이 태그와 연결된 문서를 한곳에서 모아보고, 함께 자주 등장하는 연관 태그까지 이어서 탐색할 수 있습니다.
연관 태그
총 262건 중 121-144건
이 글은 인공지능 보조 도구가 빠르게 만든 타입스크립트 코드일수록 다음 사람이 읽고 고치기 쉬운 구조, 흐름, 타입 모델링이 더 중요하다고 설명한다.
스탠퍼드 HAI가 실제 채용 데이터를 대규모로 분석한 결과, 인공지능 채용 선별 도구가 직무별 인종적 불균형을 만들고 같은 지원자를 여러 채용 과정에서 반복적으로 배제할 수 있다는 우려가 제기됐다.
Firecrawl이 Vercel Marketplace의 네이티브 통합으로 출시되어, Vercel 프로젝트에서 웹 데이터 수집용 계정·API 키·청구 설정을 자동화할 수 있게 됐습니다.
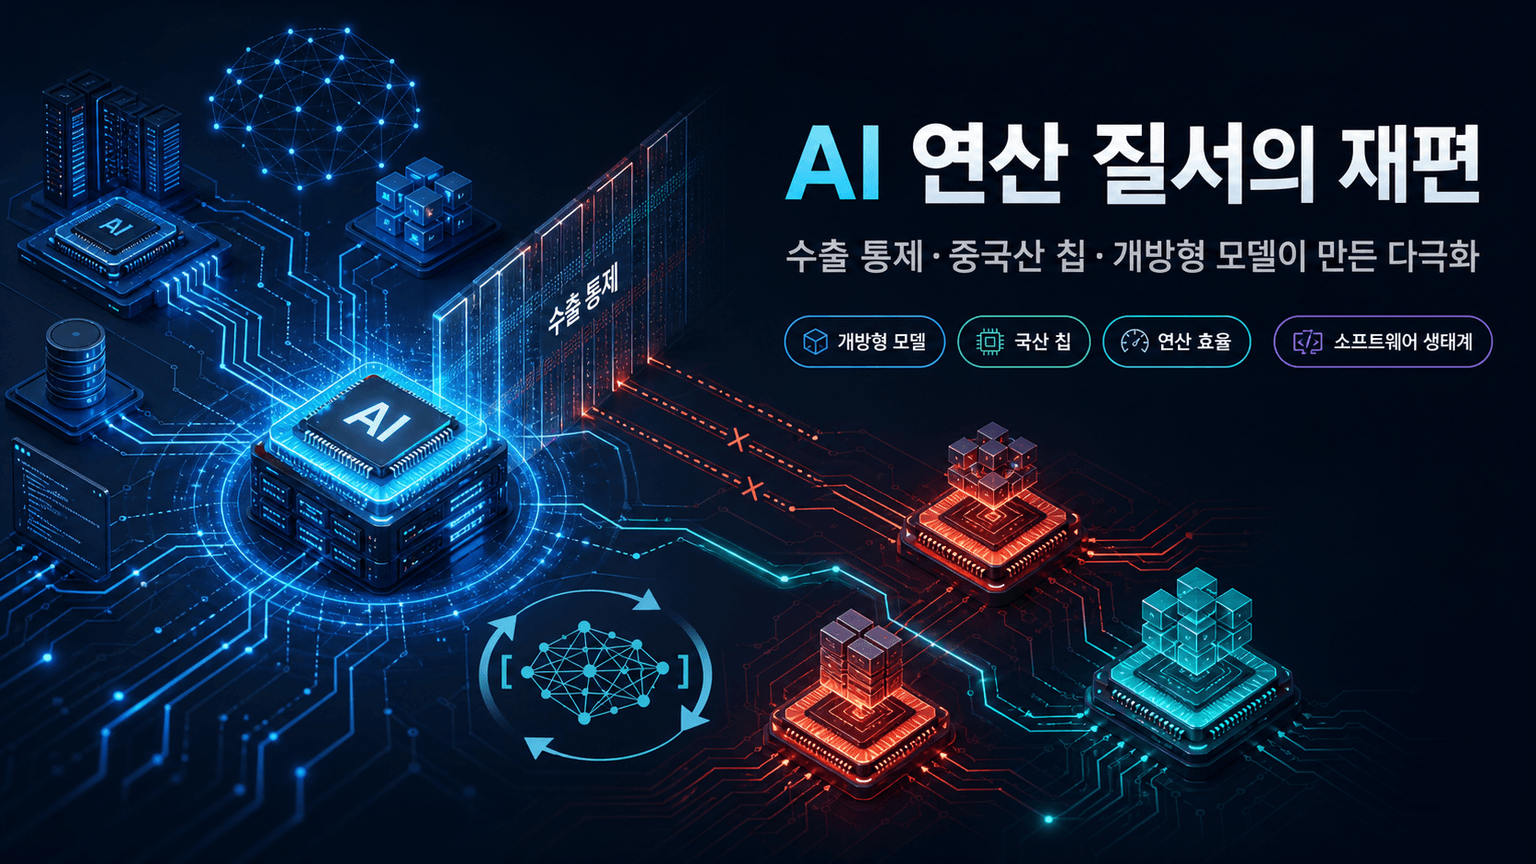
미국 중심이던 인공지능 연산 생태계가 수출 통제, 중국산 칩의 성장, 개방형 모델과 연산 효율 기술의 확산을 계기로 중국을 포함한 다극적 하드웨어·소프트웨어 구조로 재편되고 있다.
Convex OS는 Windows XP 스타일의 브라우저 기반 React 데스크톱 UI를 Convex의 반응형 데이터베이스 상태 모델 위에 올려, 창 위치·프로세스·파일 상태를 여러 탭에서 실시간으로 공유하게 만든 실험이다.
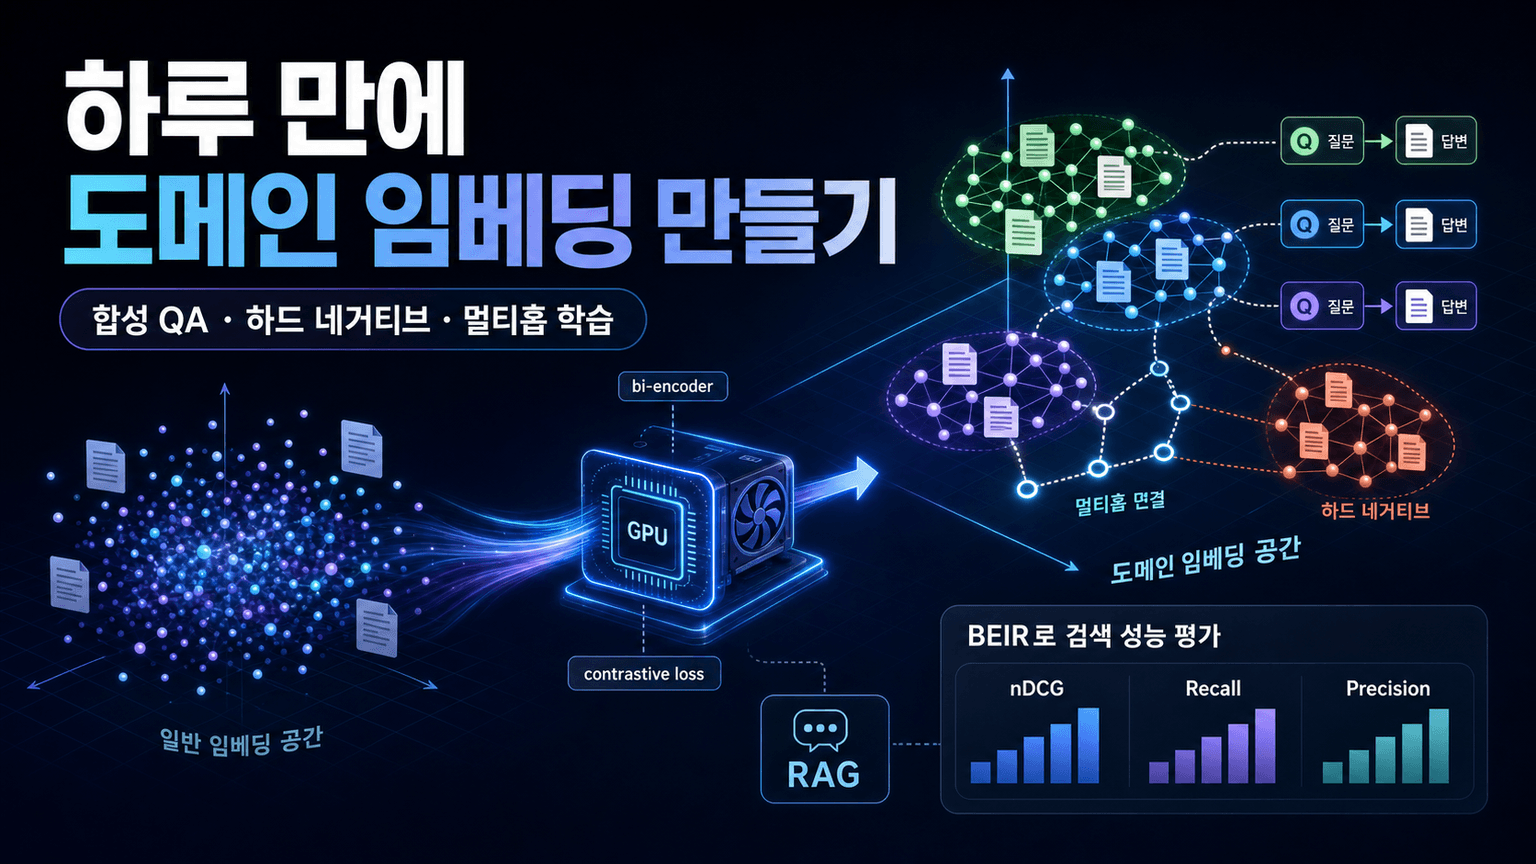
이 글은 범용 임베딩 모델이 도메인 특유의 미묘한 차이를 놓칠 때, 합성 질의응답 생성·하드 네거티브 마이닝·멀티홉 학습·대조학습·BEIR 평가를 통해 하루 안에 도메인 특화 임베딩 모델로 미세조정하는 절차를 설명한다.
TRL의 델타 가중치 동기화는 연속된 강화학습 단계에서 실제로 바뀐 극소수의 bf16 원소만 희소 세이프텐서로 저장해 허깅페이스 버킷으로 전달함으로써, 대규모 모델의 반복적인 전체 체크포인트 전송 비용과 추론 중단 시간을 크게 줄이는 방식이다.
호주 노인요양기관 Regis는 RegiCare Assist로 방대한 24시간 보고서와 인수인계 기록을 요약해 임상관리자가 서류보다 입소자 돌봄에 더 많은 시간을 쓰도록 하고 있습니다.
Cloudflare는 Project Glasswing에서 Mythos Preview를 자사 저장소 50여 개에 적용하며, 보안 특화 LLM이 취약점 발견을 넘어 exploit chain과 실행 가능한 증명까지 만들 수 있지만 대규모 활용에는 정교한 harness와 검증 구조가 필요하다고 설명한다.
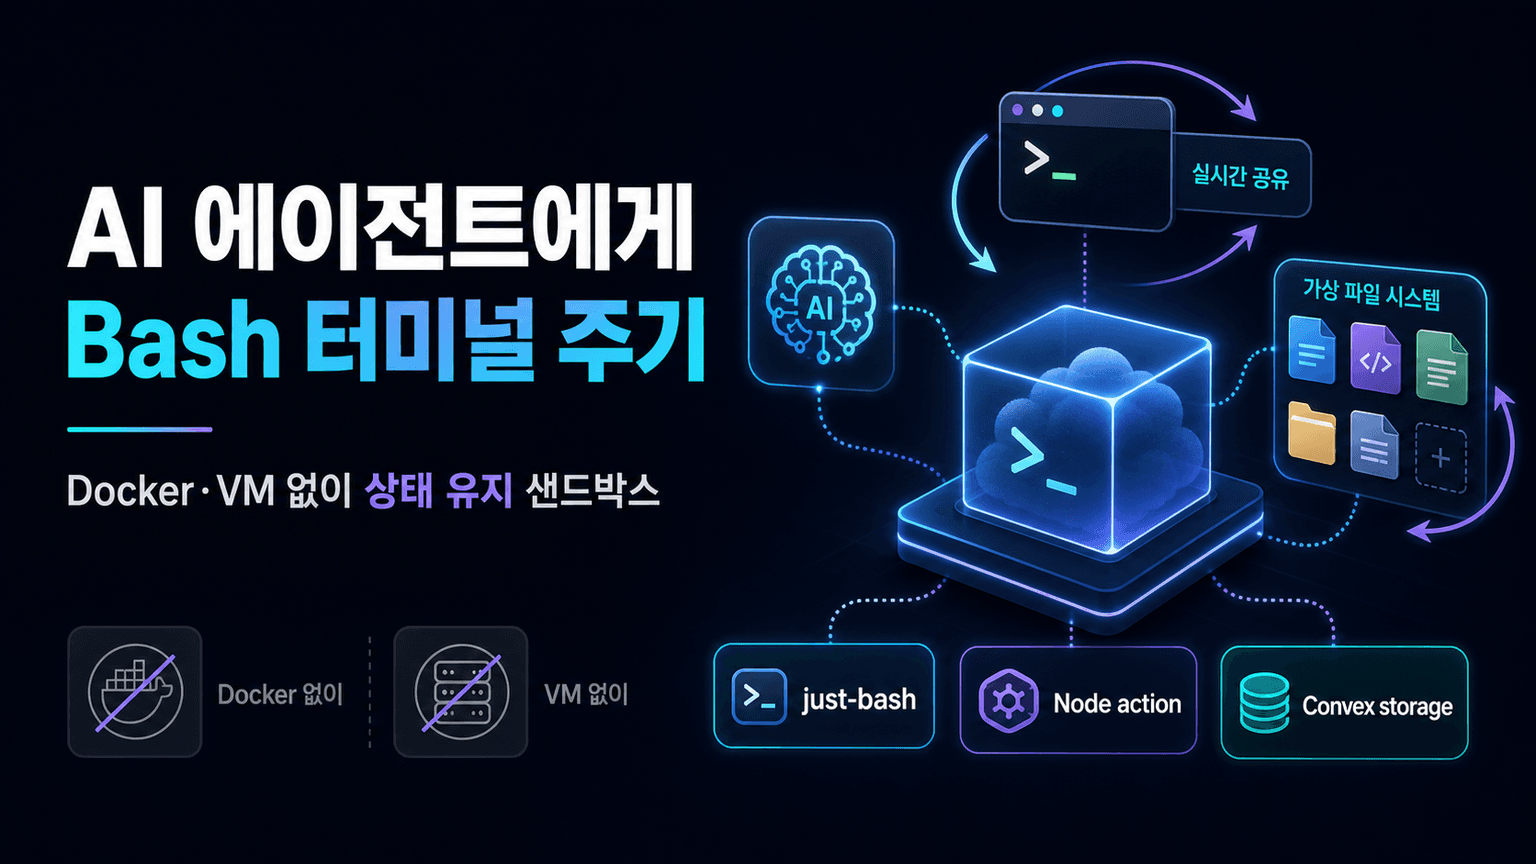
Convex Sandbox는 Docker나 VM 없이 Convex Node action, just bash, Convex storage를 조합해 AI 에이전트에게 상태가 유지되는 bash 터미널과 가상 파일 시스템을 제공하는 경량 샌드박스입니다.
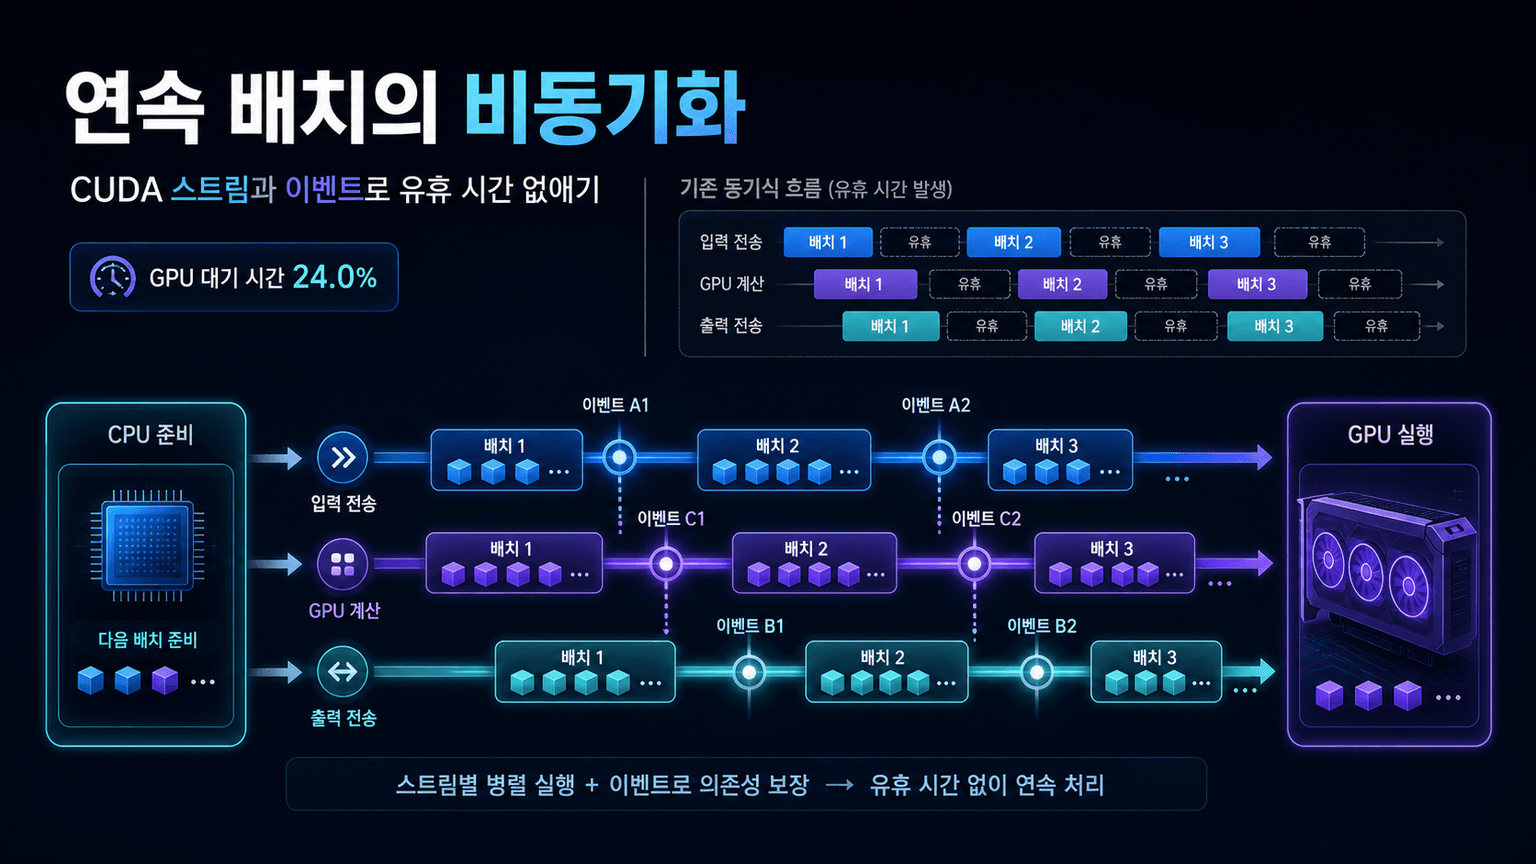
연속 배치의 동기식 유휴 시간을 없애기 위해 중앙처리장치의 배치 준비와 그래픽처리장치의 계산을 분리하고, 비기본 CUDA 스트림과 이벤트로 병렬 실행과 작업 순서를 함께 보장하는 방법을 설명한다.
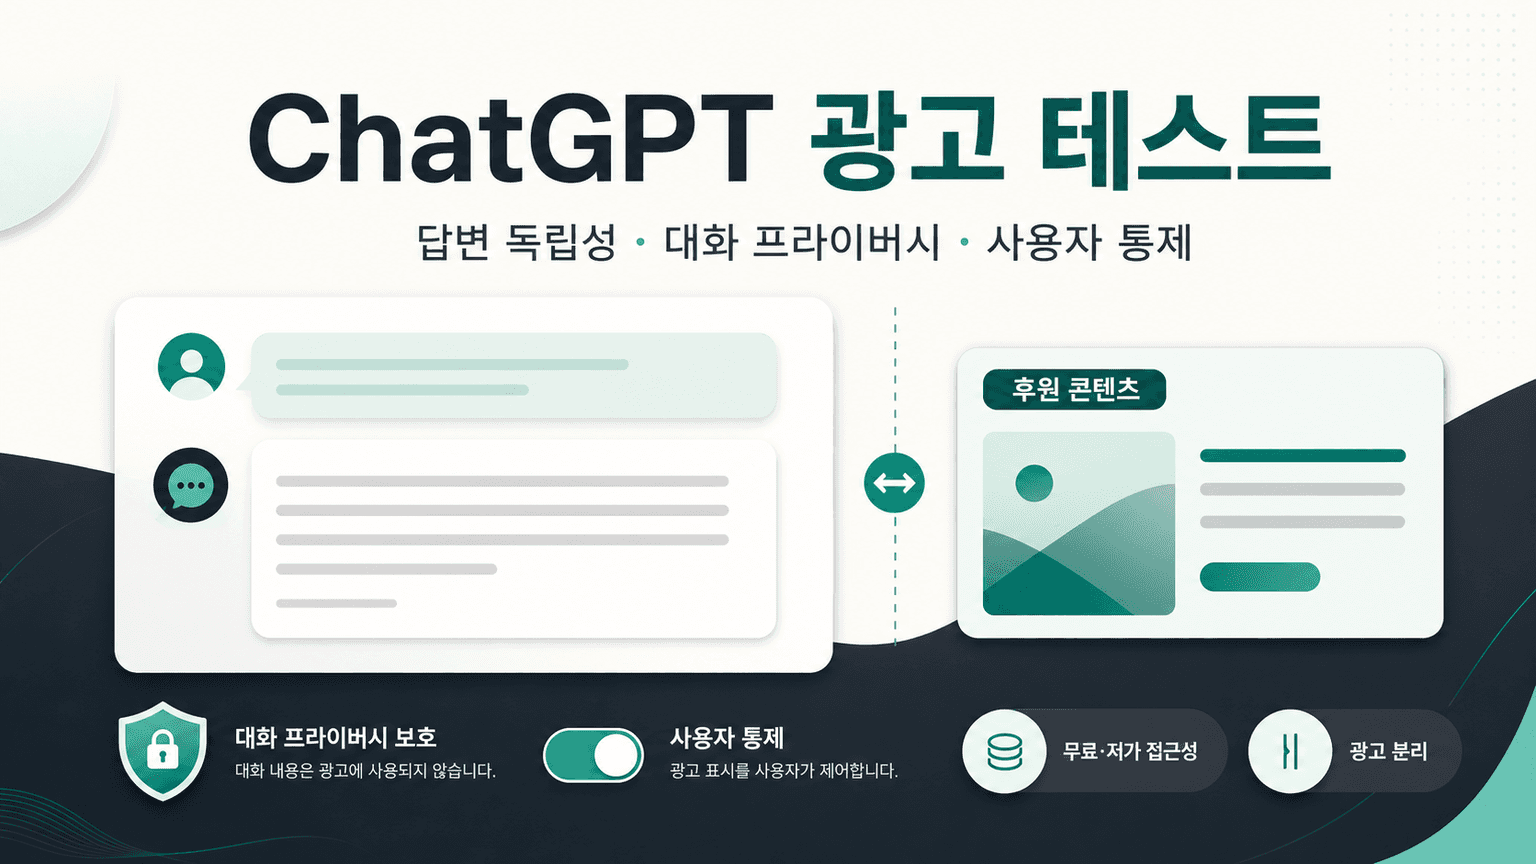
OpenAI는 ChatGPT의 무료·저가 접근성을 유지하기 위해 광고 파일럿을 확대하되, 답변 독립성·대화 프라이버시·사용자 통제를 핵심 원칙으로 유지한다고 밝혔다.
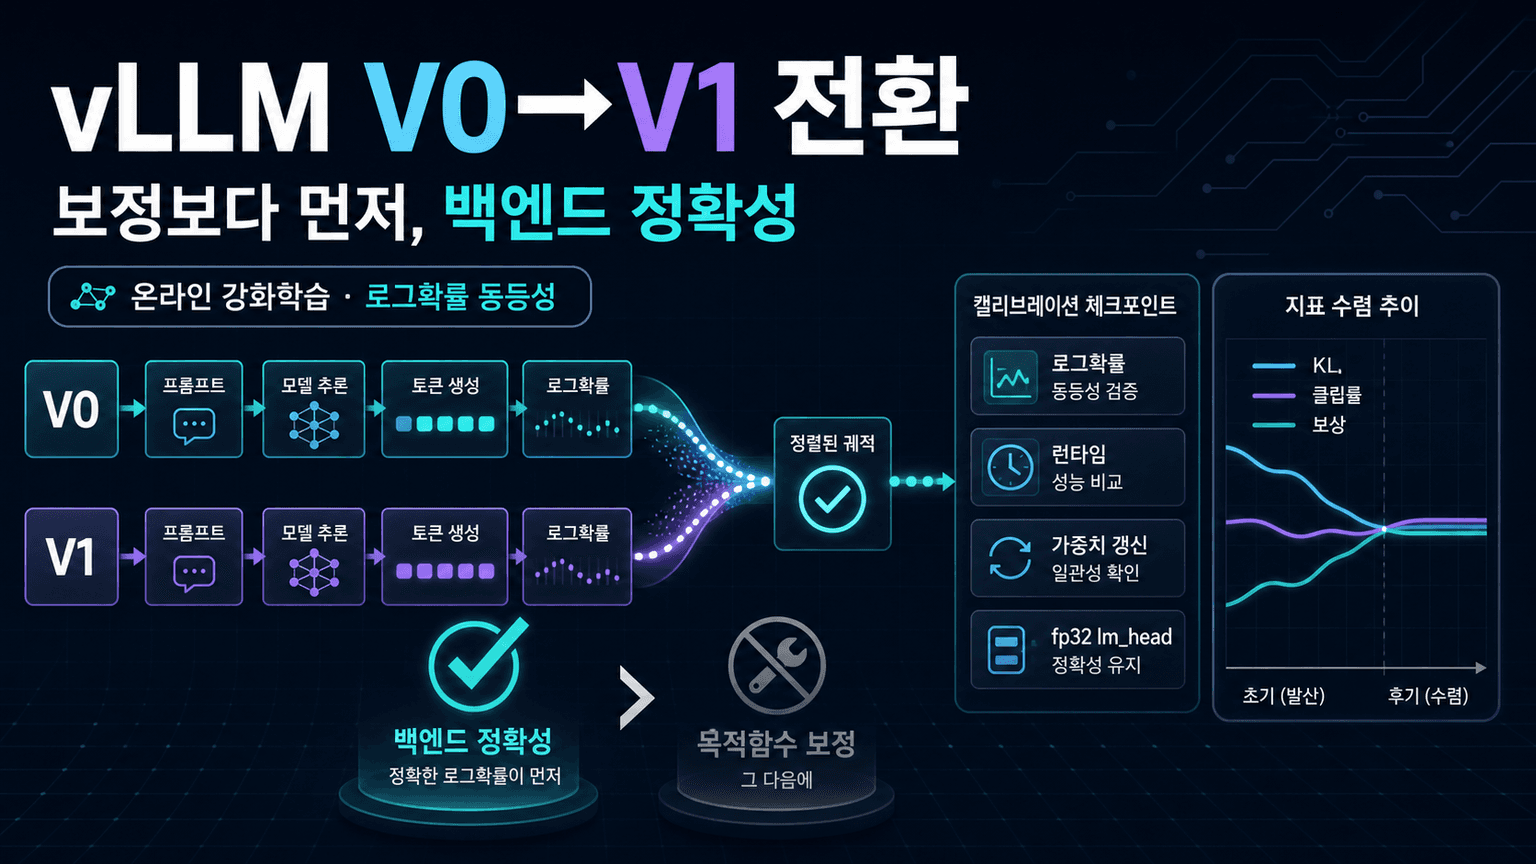
온라인 강화학습의 vLLM V0→V1 전환에서는 목적함수 보정을 서두르기보다 로그확률 의미, 런타임 기본값, 비행 중 가중치 갱신, fp32 출력 헤드를 먼저 일치시켜 추론 백엔드의 정확성을 복원해야 했다.
IBM의 Granite Embedding Multilingual R2는 200개 이상의 언어와 32K 토큰 문맥을 지원하며, 97M 소형 모델과 311M 고성능 모델로 다국어·장문·코드 검색의 성능과 배포 효율을 함께 높인 Apache 2.0 임베딩 모델군이다.
스탠퍼드는 AI 변화 속도에 맞춰 HAI와 스탠퍼드 데이터 사이언스를 통합하고, 대규모 협업 연구와 개방성을 중심으로 대학의 AI 역할을 재구성하려 한다.
Firecrawl은 로컬 문서를 업로드해 웹 페이지처럼 정리된 마크다운, 요약, 구조화 JSON을 받을 수 있는 새 API /parse를 출시했다.
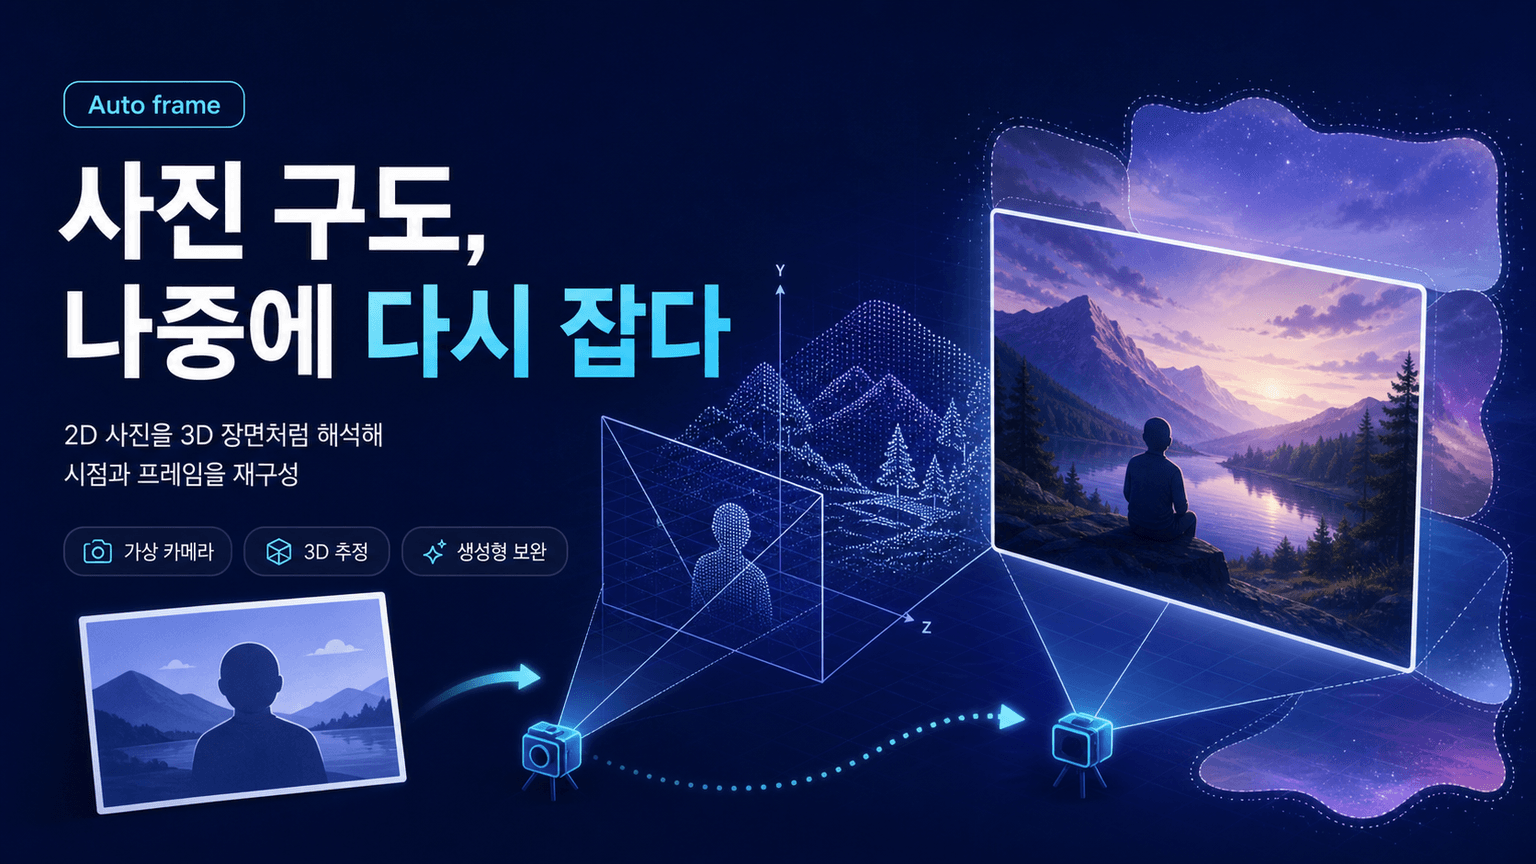
Google Photos의 Auto frame은 촬영 후에도 사진을 3D 장면처럼 해석해 시점과 구도를 자동으로 재구성하는 이미지 편집 기능이다.
Codex는 주간 개발자 사용자가 2주 만에 300만 명 이상에서 400만 명 이상으로 늘어난 가운데, 기업들이 소프트웨어 개발과 지식 업무 전반의 실제 워크플로에 빠르게 도입하는 단계로 확장되고 있다.
Unweight는 LLM 가중치의 BF16 지수 바이트를 무손실로 압축하고 GPU 온칩 메모리에서 바로 복원해, 출력 품질을 유지하면서 모델 크기와 HBM 메모리 대역폭 부담을 줄이는 추론용 압축 시스템이다.
Cloudflare는 Workers AI에서 Kimi K2.5 같은 초대형 오픈소스 언어 모델을 빠르고 효율적으로 운영하기 위해 하드웨어 구성, prefill/decode 분리, 프롬프트 캐싱, KV 캐시 최적화, speculative decoding, 자체 추론 엔진 Infire를 조합하고 있다고 설명한다.
마틴 파울러는 AI 시대에도 좋은 소프트웨어를 만드는 핵심은 더 많은 코드를 빠르게 생산하는 능력이 아니라, 인간의 ‘게으름’이 낳는 단순한 추상화와 의심·검증·절제라고 정리한다.
마틴 파울러는 두 편의 팟캐스트, 공급망 공격 사례, 문서화 프레임워크, AI 에이전트 기반 개발 경험, 돌봄 중심의 성장 관점을 묶어 소개한다.
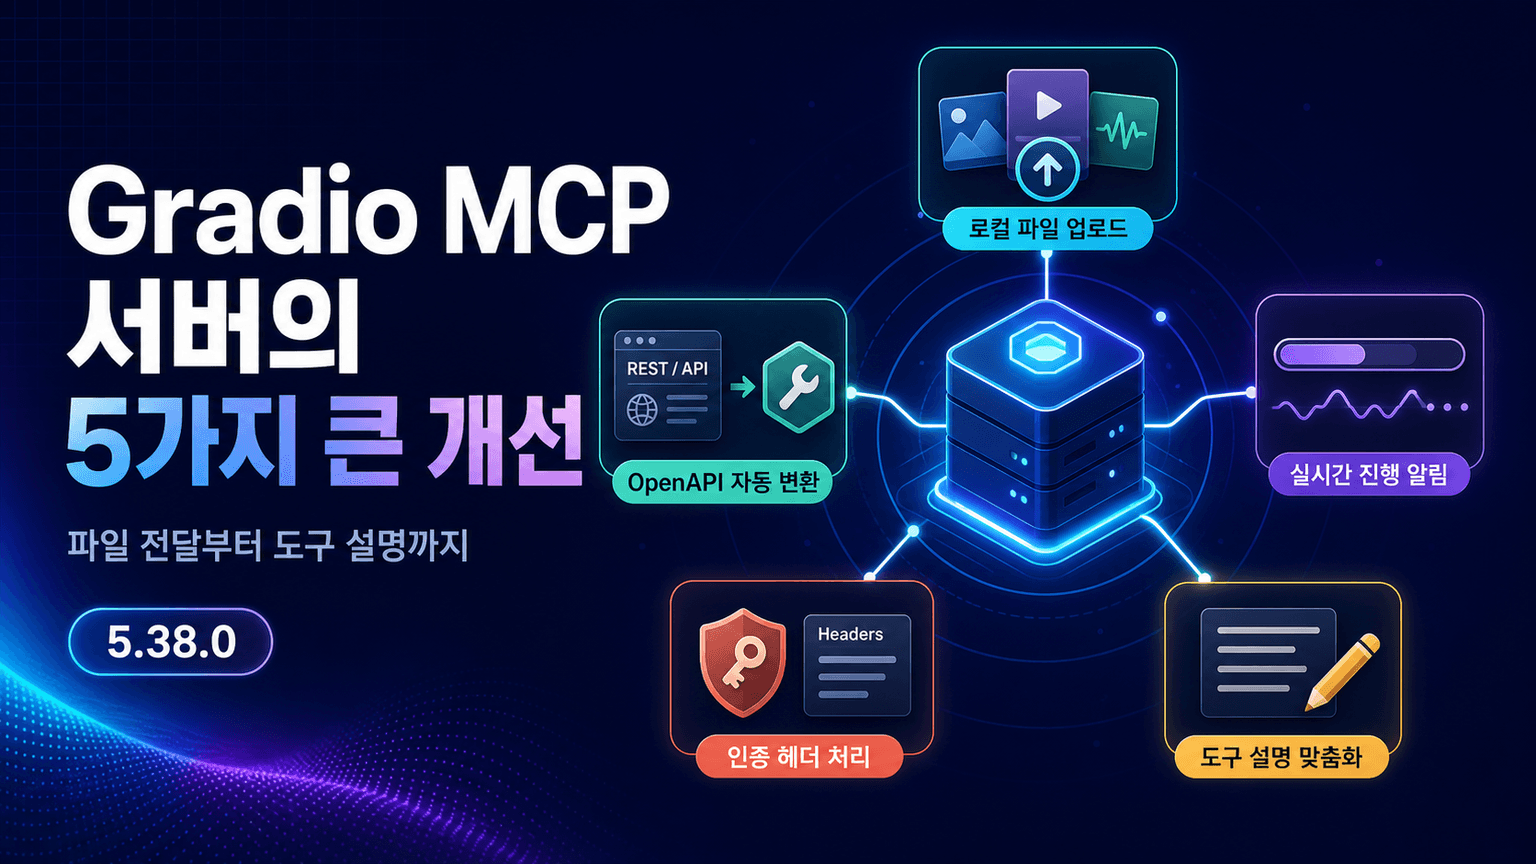
Gradio 5.38.0은 로컬 파일 전달, 실시간 진행 알림, OpenAPI 변환, 인증 헤더 처리, 도구 설명 맞춤화로 MCP 서버의 개발·연결 경험을 개선했다.
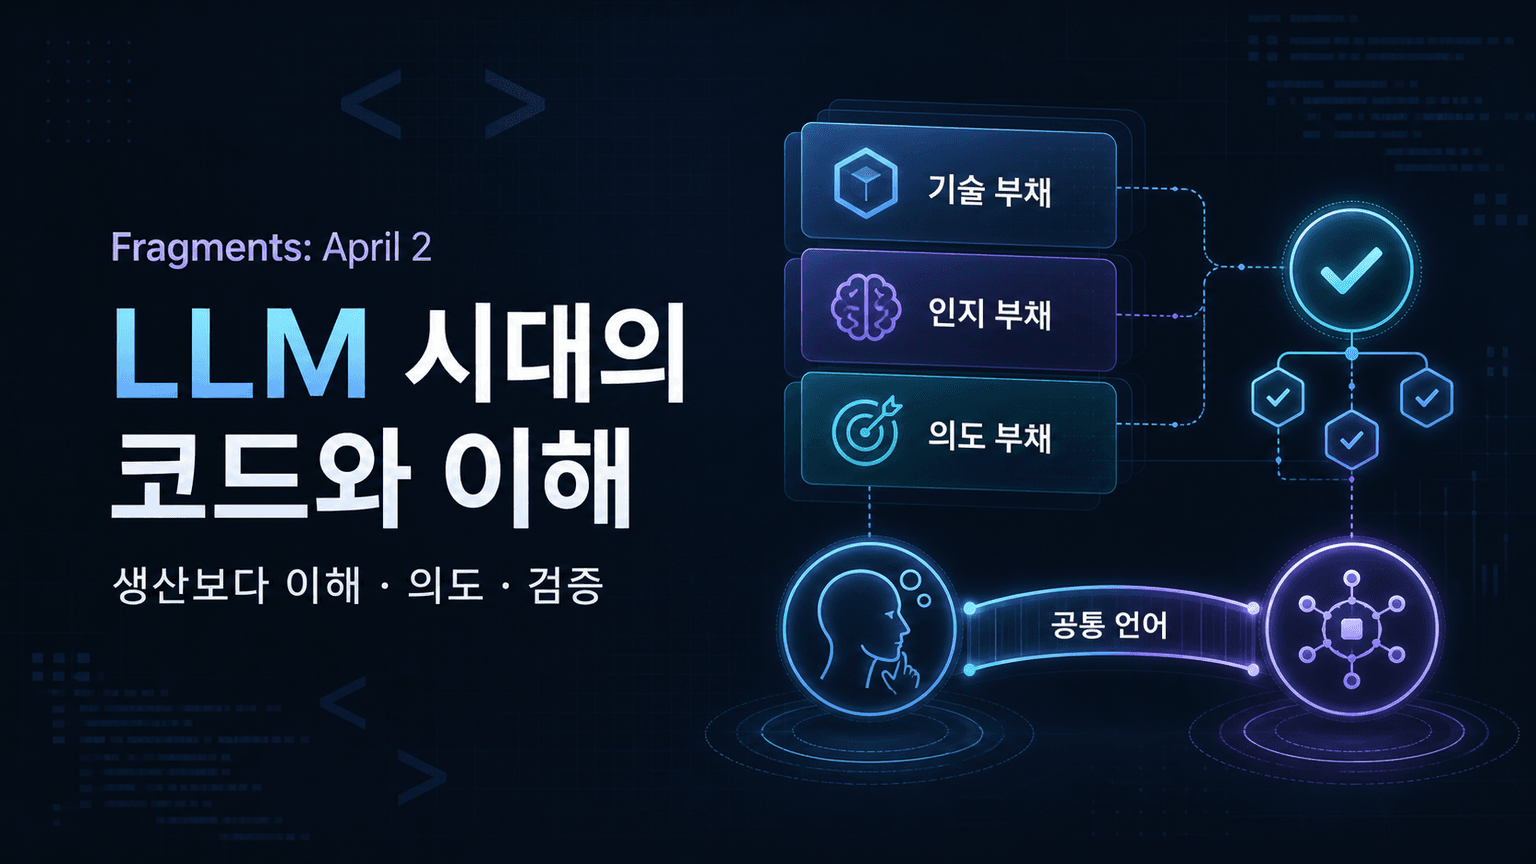
마틴 파울러는 LLM 시대의 핵심 문제가 코드 생산 자체보다 시스템 이해, 의도 보존, 검증, 그리고 인간과 AI가 함께 사용할 언어의 설계로 이동하고 있다고 정리한다.