이 태그와 연결된 문서를 한곳에서 모아보고, 함께 자주 등장하는 연관 태그까지 이어서 탐색할 수 있습니다.
연관 태그
총 262건 중 169-192건
AprielGuard는 현대 LLM의 안전 위험과 프롬프트 주입·탈옥·메모리 오염 등 적대적 공격을 통합적으로 감지하도록 설계된 8B 안전·보안 가드레일 모델이다.
Firecrawl은 AI 에이전트가 스크래핑, 검색, 브라우징, 크롤링, 사이트 매핑을 하나의 CLI와 Skill로 수행하고 결과를 파일시스템에 저장하도록 하는 웹 데이터 도구 모음을 발표했다.
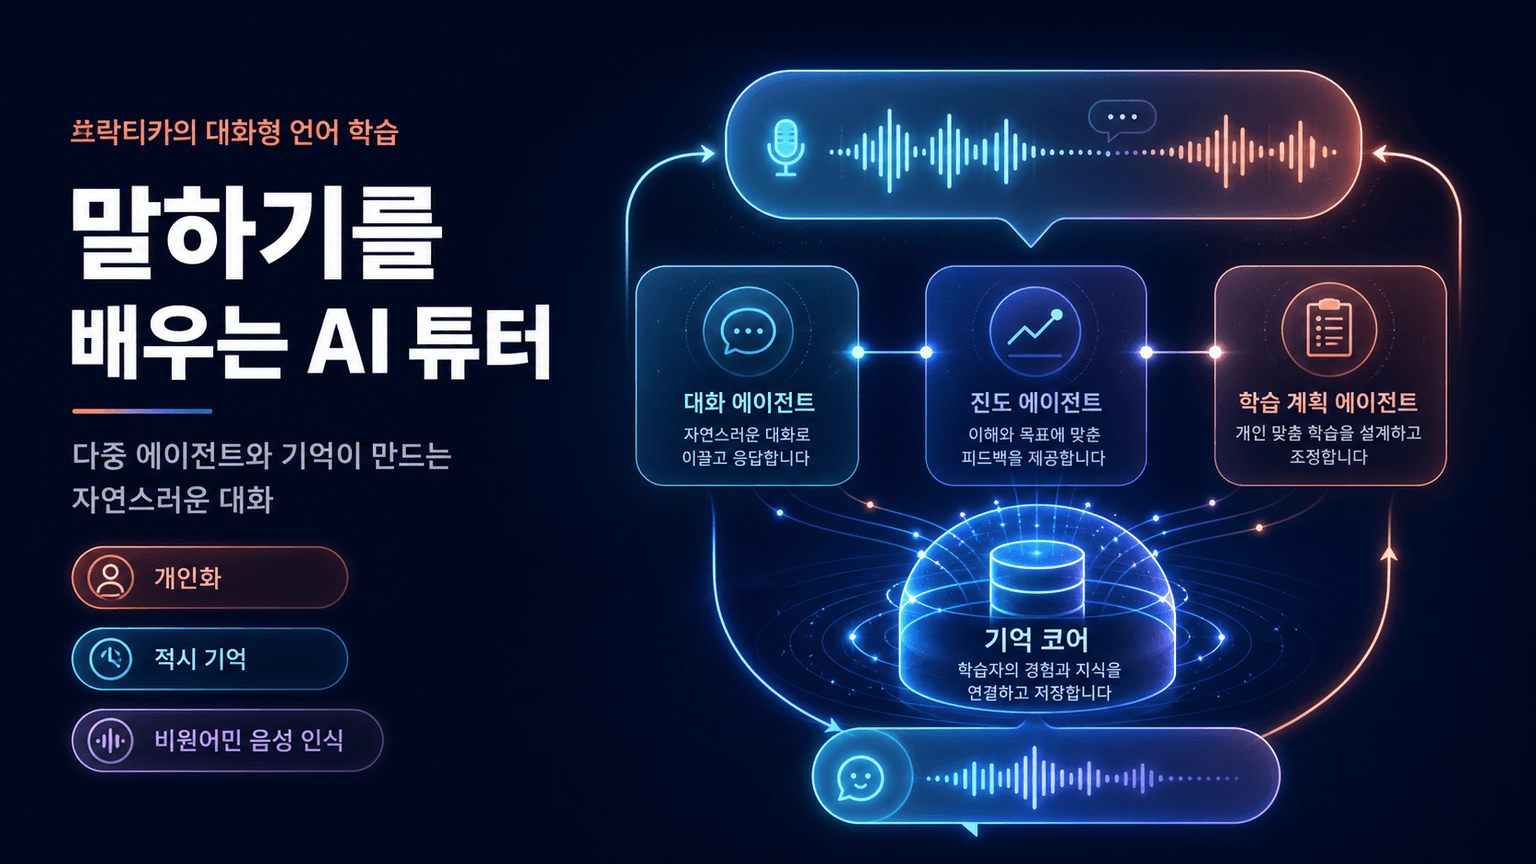
프락티카는 개인화된 다중 에이전트, 적시 기억 검색, 비원어민 음성 인식을 결합해 실제 상황에서 자신 있게 말하는 능력을 키우는 대화형 언어 학습 앱이다.
웨이포인트 1은 텍스트·마우스·키보드 입력을 매 프레임 반영해 실시간으로 상호작용 가능한 세계를 생성하는 오버월드의 비디오 확산 모델이다.
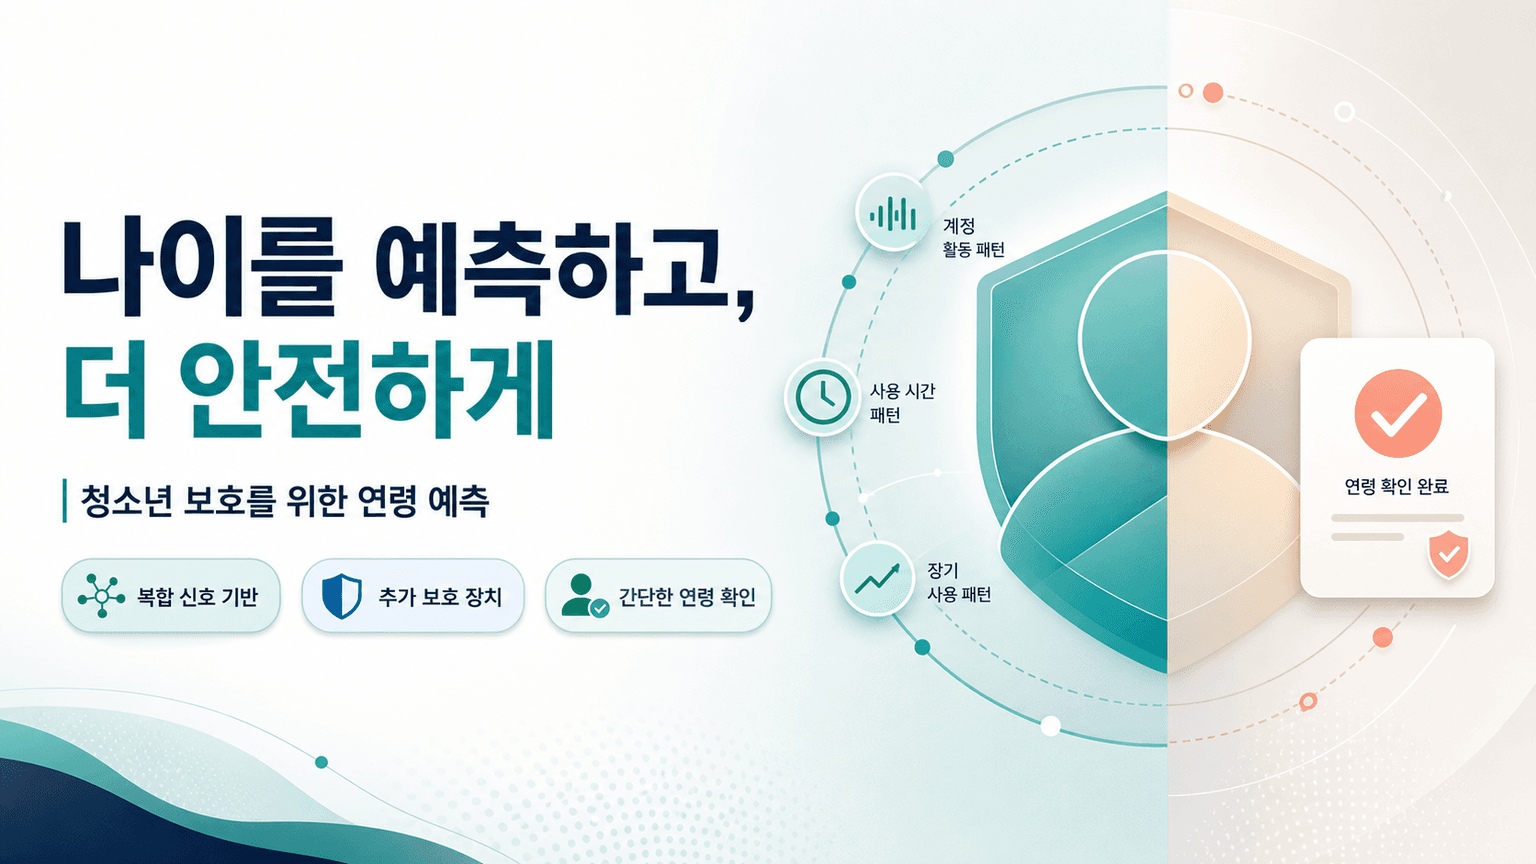
오픈AI는 18세 미만으로 추정되는 ChatGPT 계정에 청소년 보호 장치를 자동 적용하고, 잘못 분류된 이용자에게는 간단한 연령 확인 절차를 제공하는 연령 예측 기능을 소비자 요금제에 도입하고 있다.
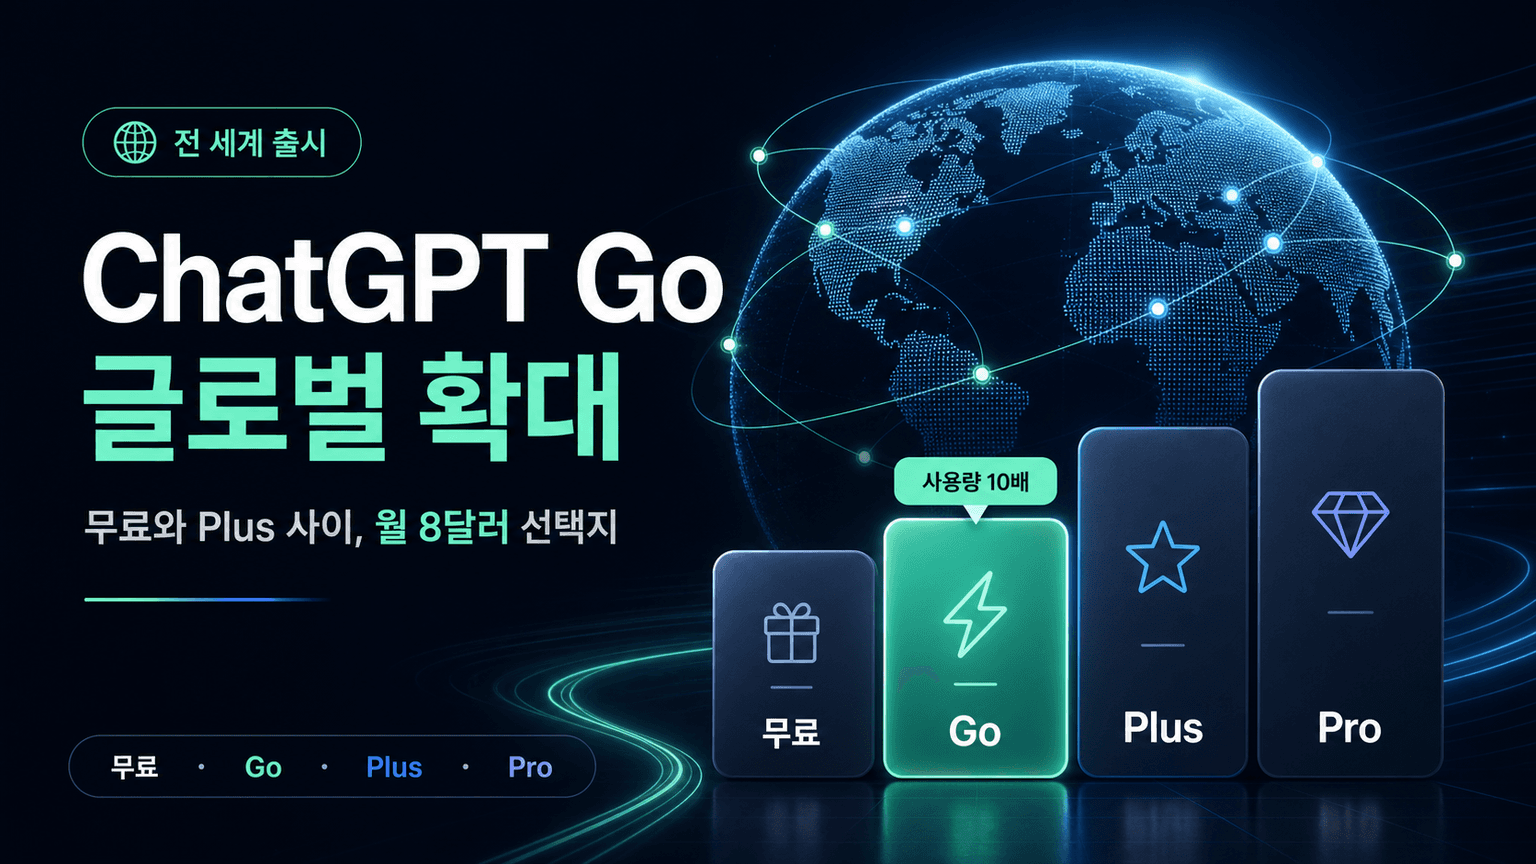
OpenAI는 저가형 구독제인 ChatGPT Go를 ChatGPT가 제공되는 전 지역으로 확대하며, 무료·Go·Plus·Pro로 이어지는 이용자별 선택 구조를 강화했다.
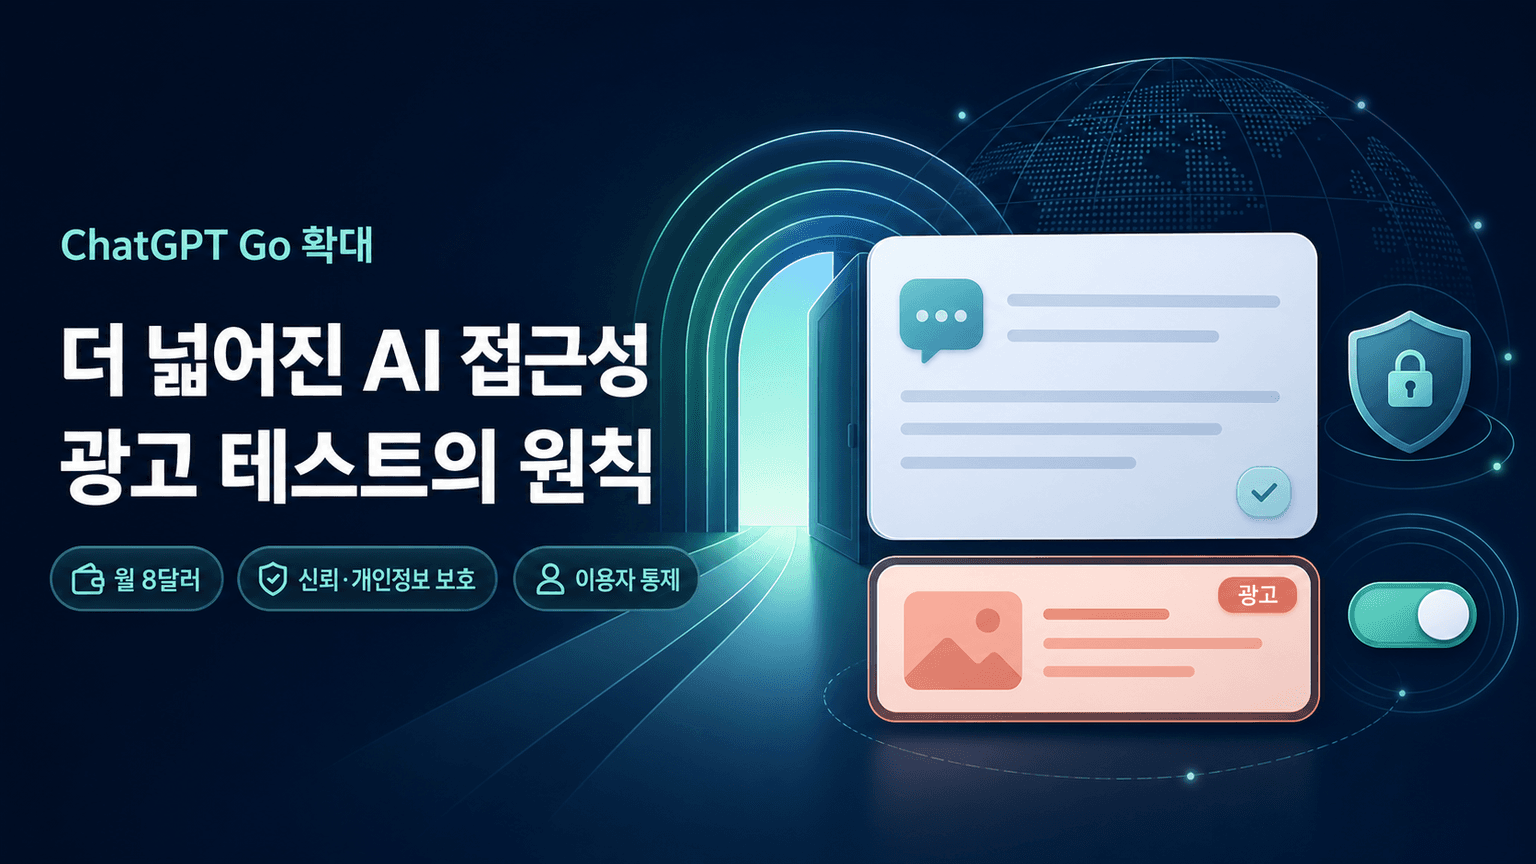
OpenAI는 월 8달러의 ChatGPT Go를 전체 서비스 지역으로 확대하고, 무료·Go 이용자의 접근성을 높이기 위해 미국에서 신뢰·개인정보 보호·이용자 통제를 원칙으로 광고 테스트를 시작할 계획이다.
NeuralGCM은 물리 기반 대기 모델과 NASA 위성 강수 관측으로 학습한 신경망을 결합해 전 지구 강수, 특히 극한 강수와 하루 주기 강수의 장기 시뮬레이션 정확도를 높인 하이브리드 모델이다.
Google Research는 STOC 2026 제출 논문을 대상으로 Gemini 기반 Paper Assistant Tool을 실험해 이론 컴퓨터과학 논문의 증명 오류, 계산 실수, 논리적 빈틈을 사전 점검하는 가능성을 확인했다.
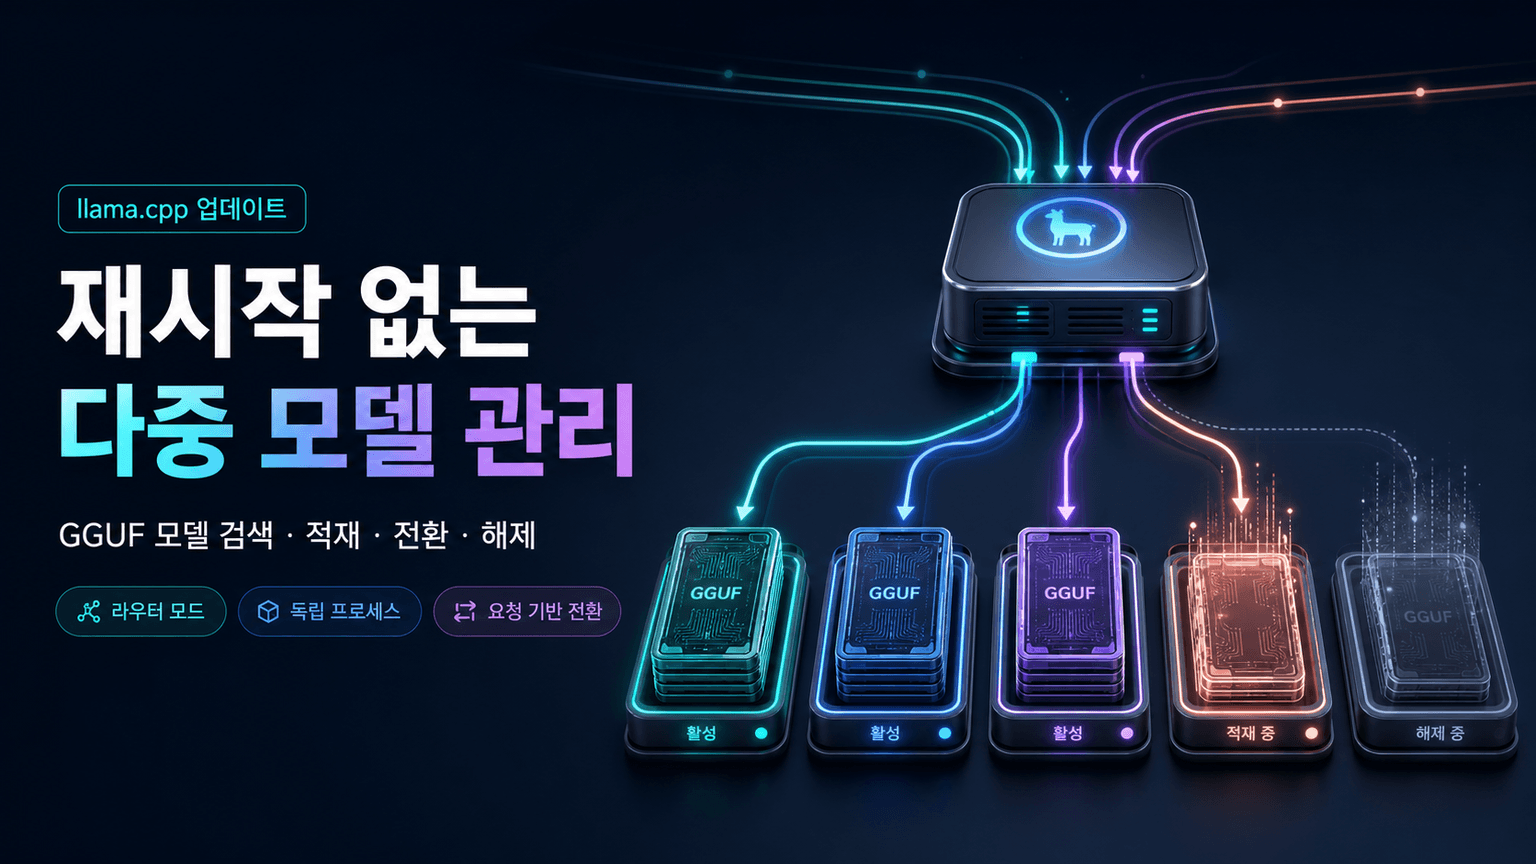
llama.cpp 서버의 라우터 모드는 재시작 없이 여러 GGUF 모델을 검색·적재·전환·해제하고, 요청의 모델 지정에 따라 독립 프로세스로 실행되는 모델에 트래픽을 전달합니다.
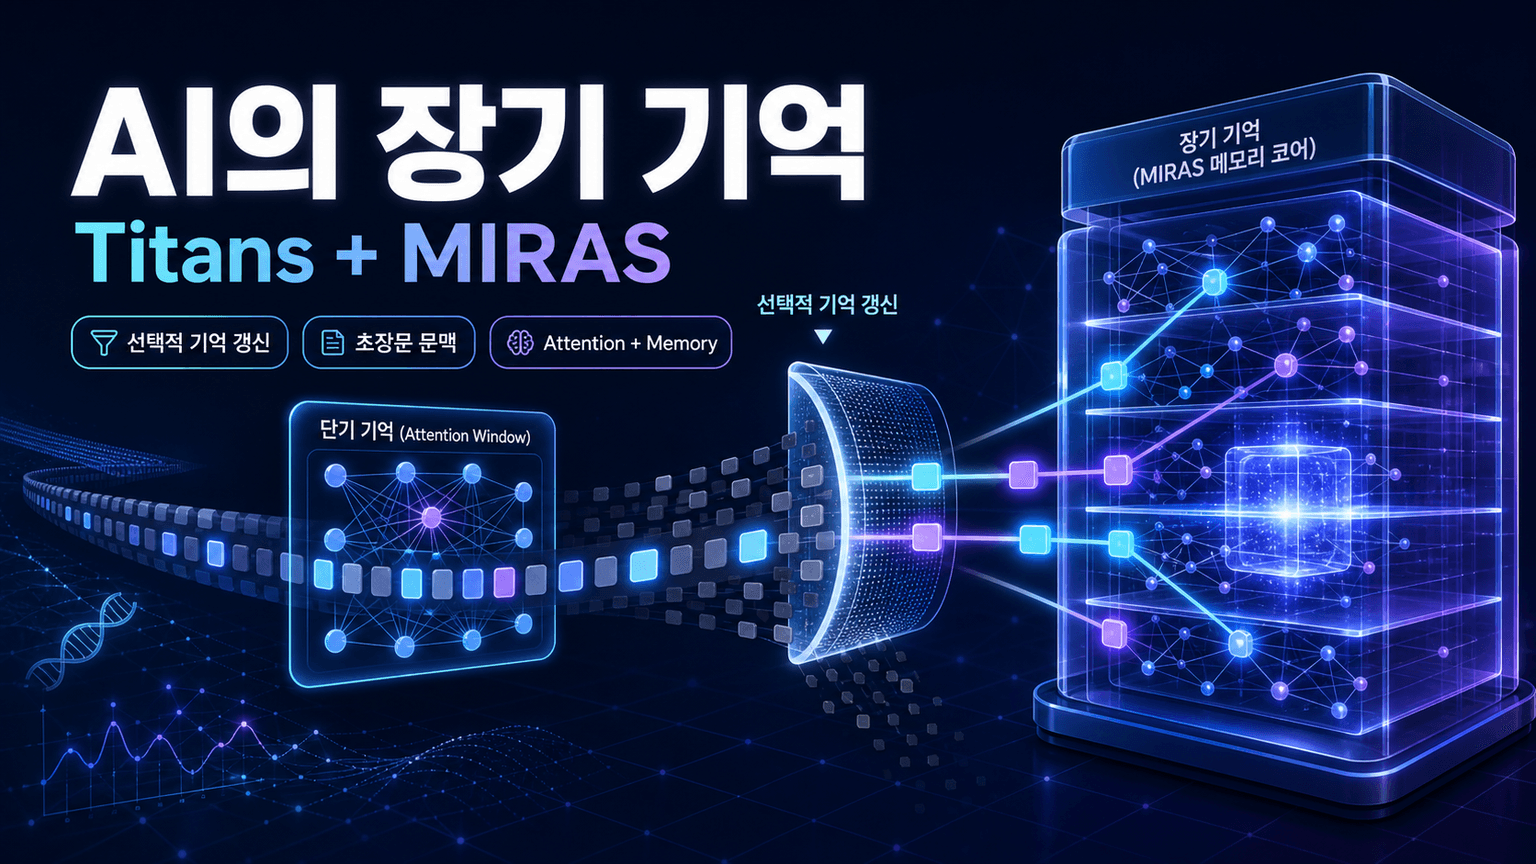
Titans와 MIRAS는 실행 중 장기 기억을 선택적으로 갱신하는 방식으로, 매우 긴 문맥을 더 빠르고 정확하게 다루려는 새로운 시퀀스 모델링 접근이다.
마이크로소프트와 허깅페이스는 1만 개 이상의 검증된 공개 모델을 애저 AI 파운드리에서 간편하고 안전하게 배포할 수 있도록 협력을 확대했습니다.
대형 소비자 인터넷 서비스는 사용자 행동의 상관관계로 추천과 발견을 만들어 왔지만, 대규모 언어 모델은 사물과 의도를 더 넓게 해석해 인터넷의 ‘발견 필터’ 자체를 바꿀 수 있다.
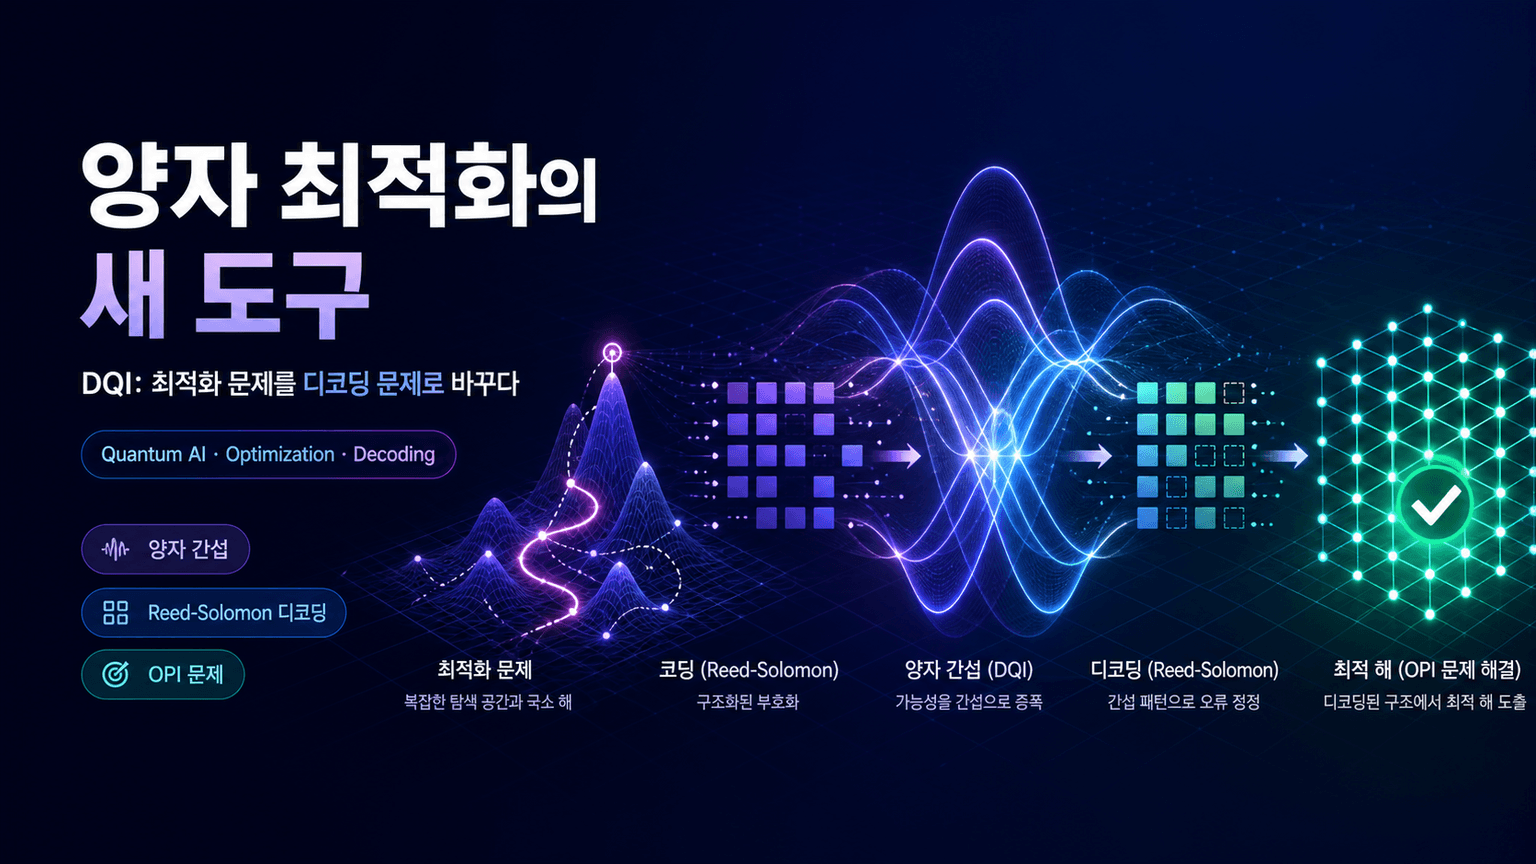
Google Quantum AI 연구진은 최적화 문제를 디코딩 문제로 변환해 양자 간섭과 기존 디코딩 알고리즘을 결합하는 DQI 알고리즘을 제시하며, 특히 OPI 문제에서 알려진 고전 알고리즘 대비 뚜렷한 속도 우위를 보일 수 있음을 설명했다.
구글 리서치는 모델 구조와 최적화 규칙을 하나의 중첩된 학습 시스템으로 보는 Nested Learning을 제안하며, 지속 학습의 핵심 난제인 파국적 망각을 줄이는 새 설계 관점을 제시했다.
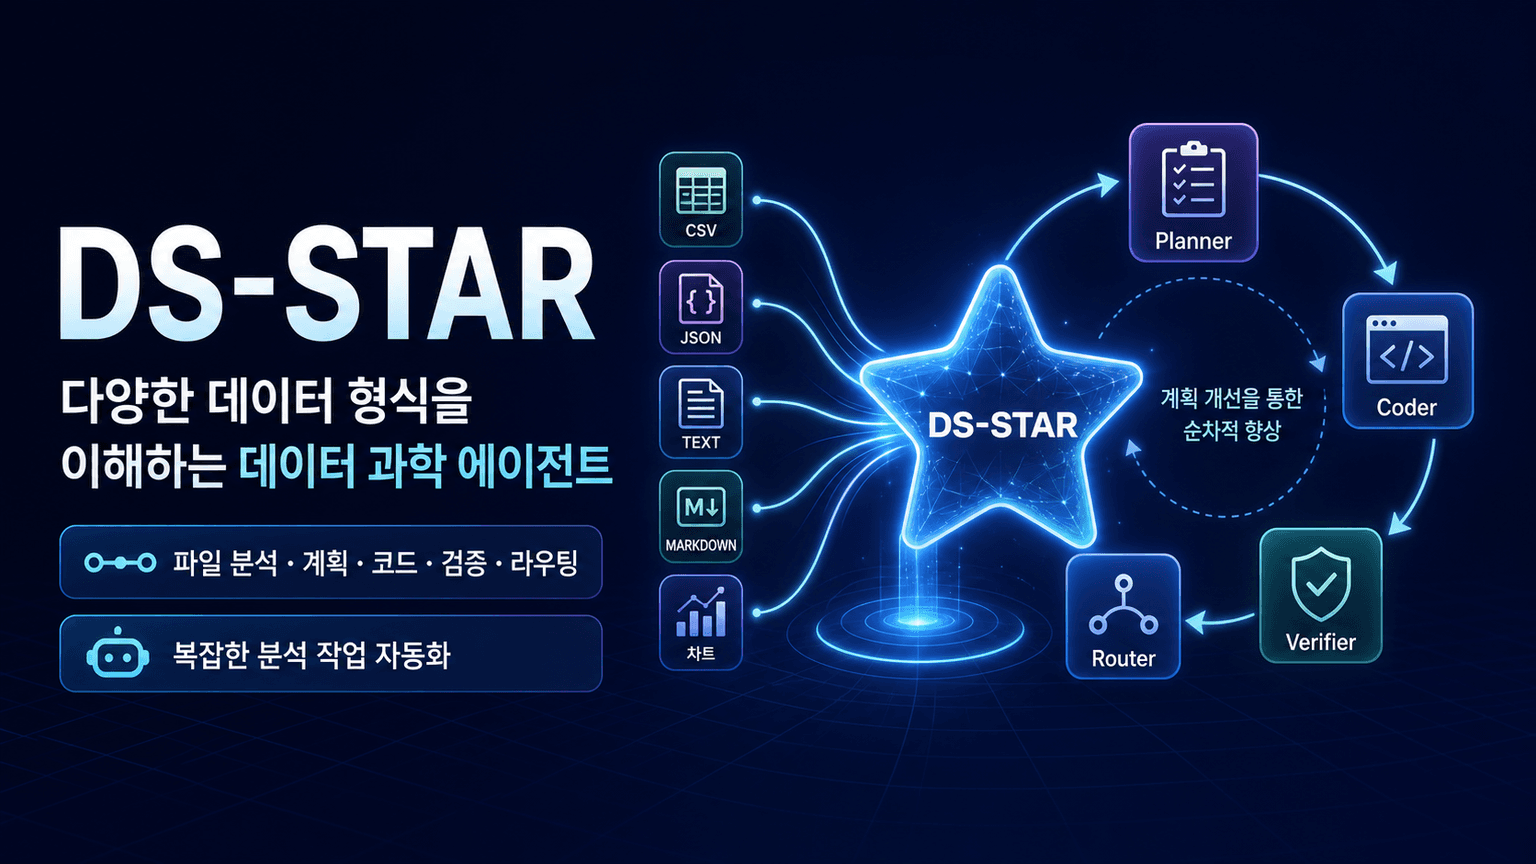
DS STAR는 다양한 데이터 형식 분석, LLM 기반 검증, 순차적 계획 개선을 결합해 복잡한 데이터 과학 작업을 자동화하고 주요 벤치마크에서 기존 에이전트보다 높은 성능을 보인 데이터 과학 에이전트입니다.
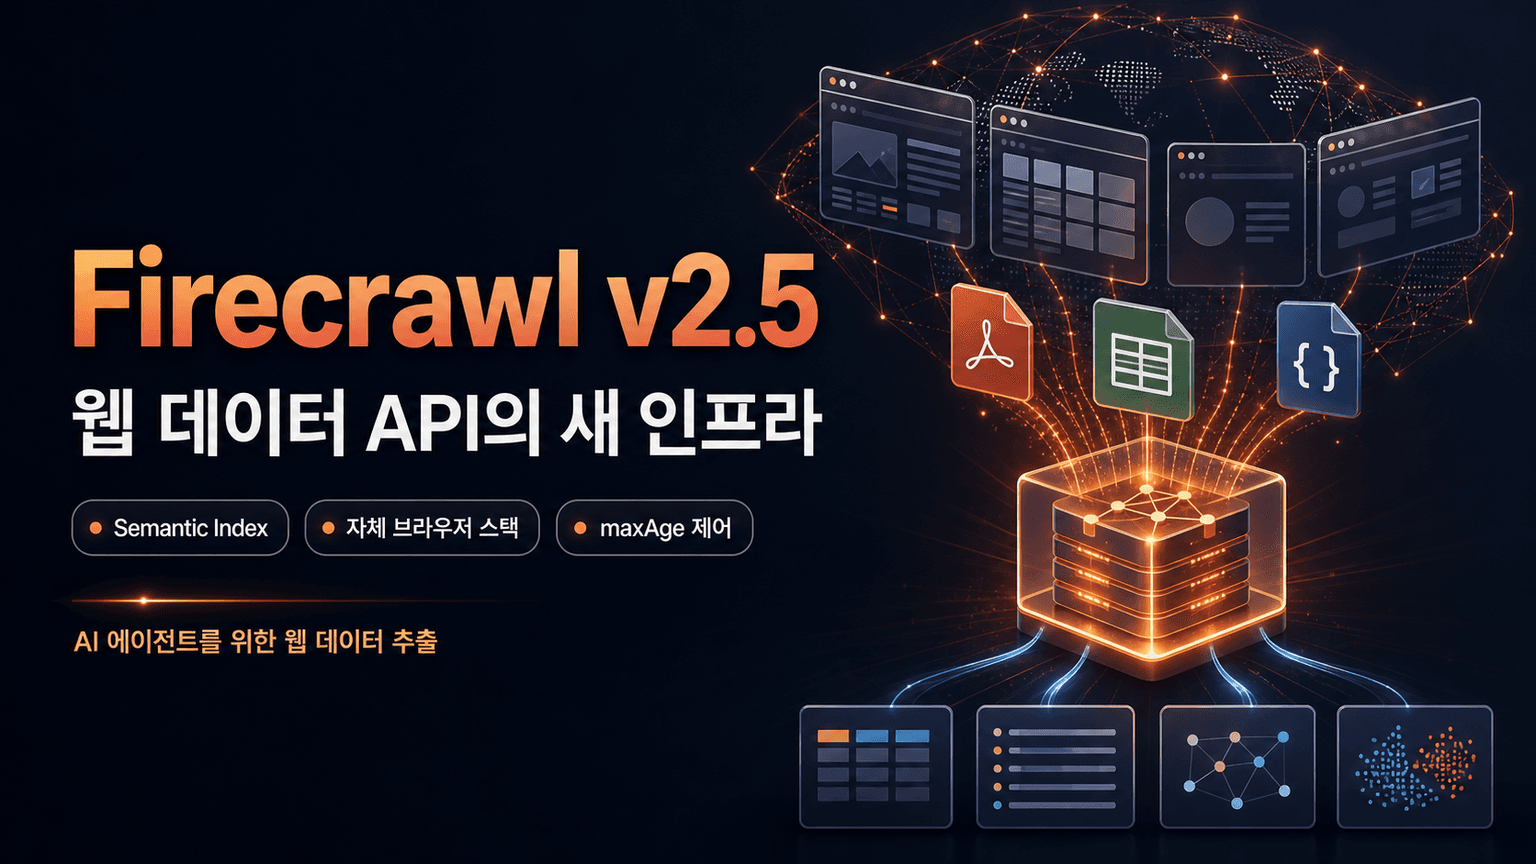
Firecrawl v2.5는 자체 브라우저 스택과 Semantic Index를 통해 웹 데이터 추출의 품질, 커버리지, 속도, 신뢰성을 높였다고 발표한 릴리스입니다.
StreetReaderAI는 시각장애인과 저시력 사용자가 스트리트뷰 장면을 음성 설명, 대화형 AI, 접근 가능한 이동 조작으로 탐색할 수 있게 만든 연구용 프로토타입입니다.
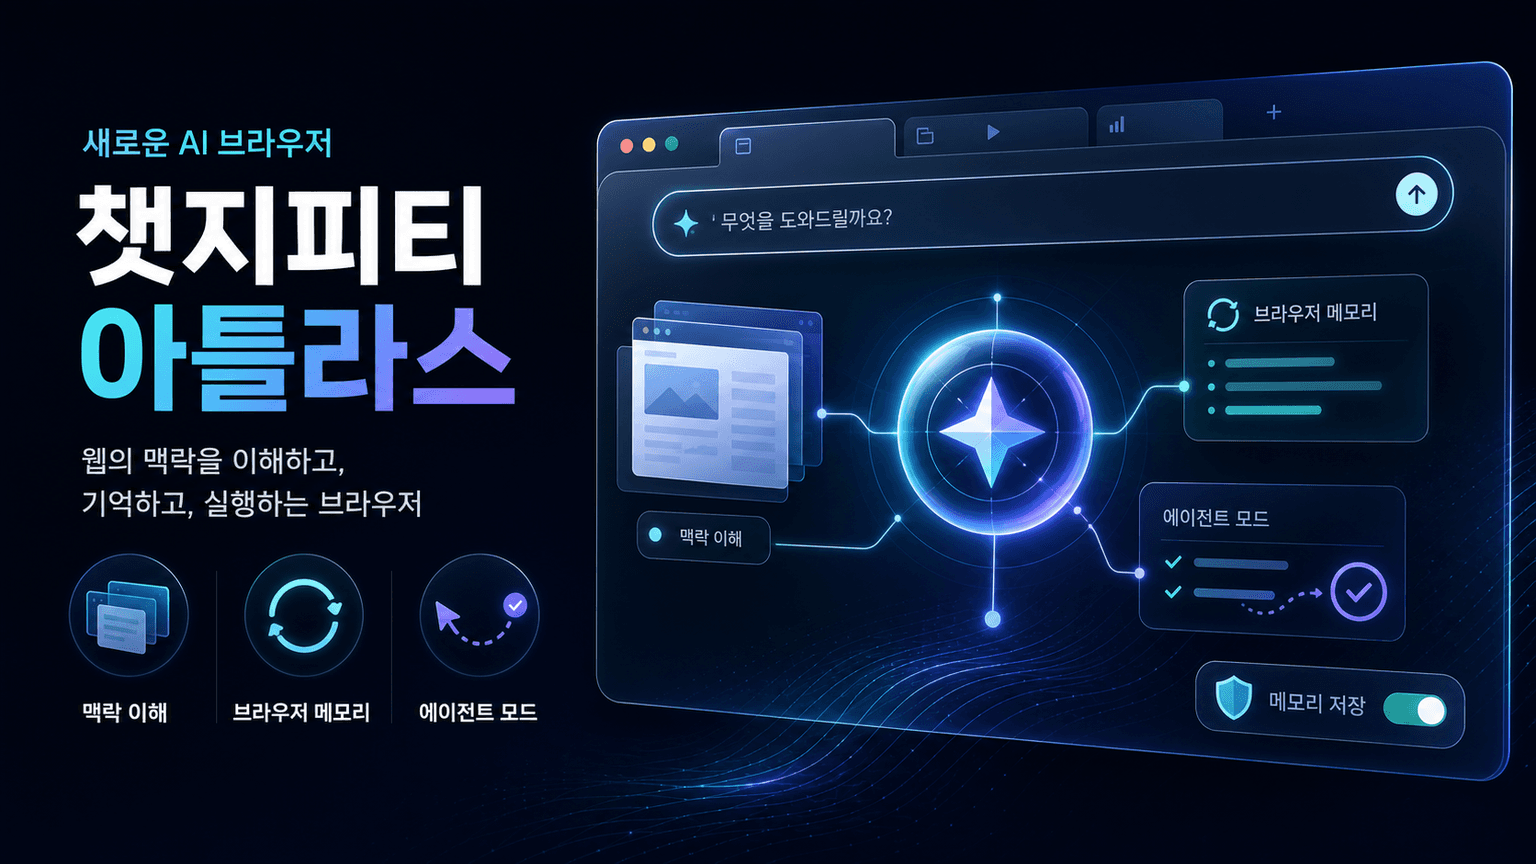
챗지피티 아틀라스는 웹 탐색 맥락을 이해하고 기억하며 사용자를 대신해 작업까지 수행하도록 챗지피티를 중심에 둔 새 웹 브라우저다.
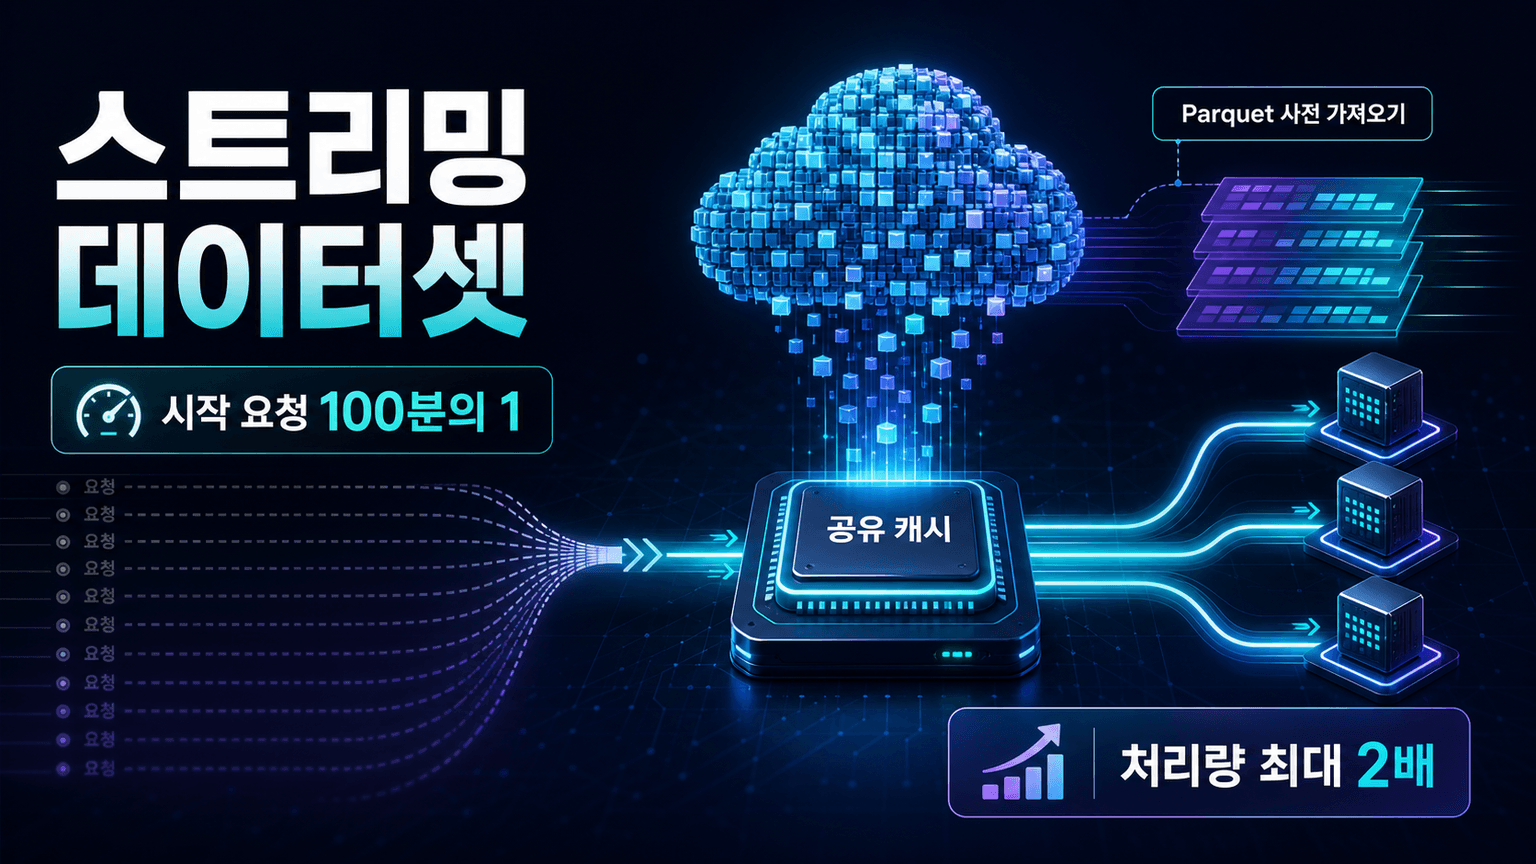
허깅페이스는 데이터 파일 목록의 공유 캐시, 요청 최적화, Parquet 사전 가져오기와 버퍼 조정을 통해 대규모 데이터셋 스트리밍의 시작 요청을 최대 100분의 1로 줄이고 처리량을 최대 2배로 높였다.
Google 연구진은 VM 수명 예측을 한 번에 끝내지 않고 계속 갱신하는 LAVA 계열 스케줄링 기법으로 대규모 데이터센터의 자원 배치 효율과 운영 안정성을 높이는 방법을 제시했다.
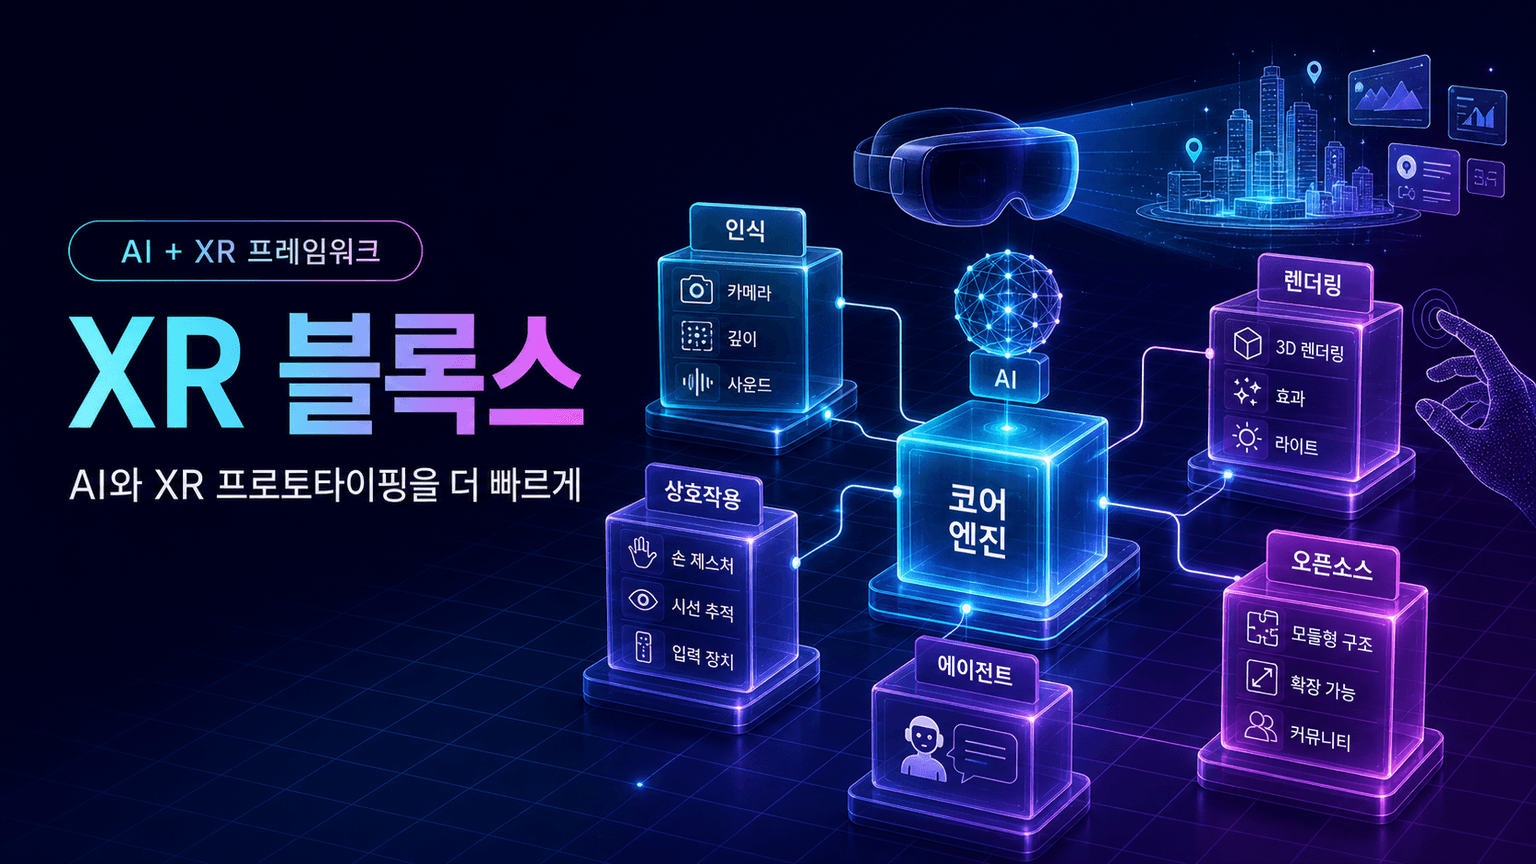
엑스알 블록스는 인공지능과 확장현실 앱의 인식·상호작용·렌더링 구현 부담을 낮춰 웹과 안드로이드 확장현실 기기에서 빠른 프로토타이핑을 돕는 오픈소스 프레임워크다.
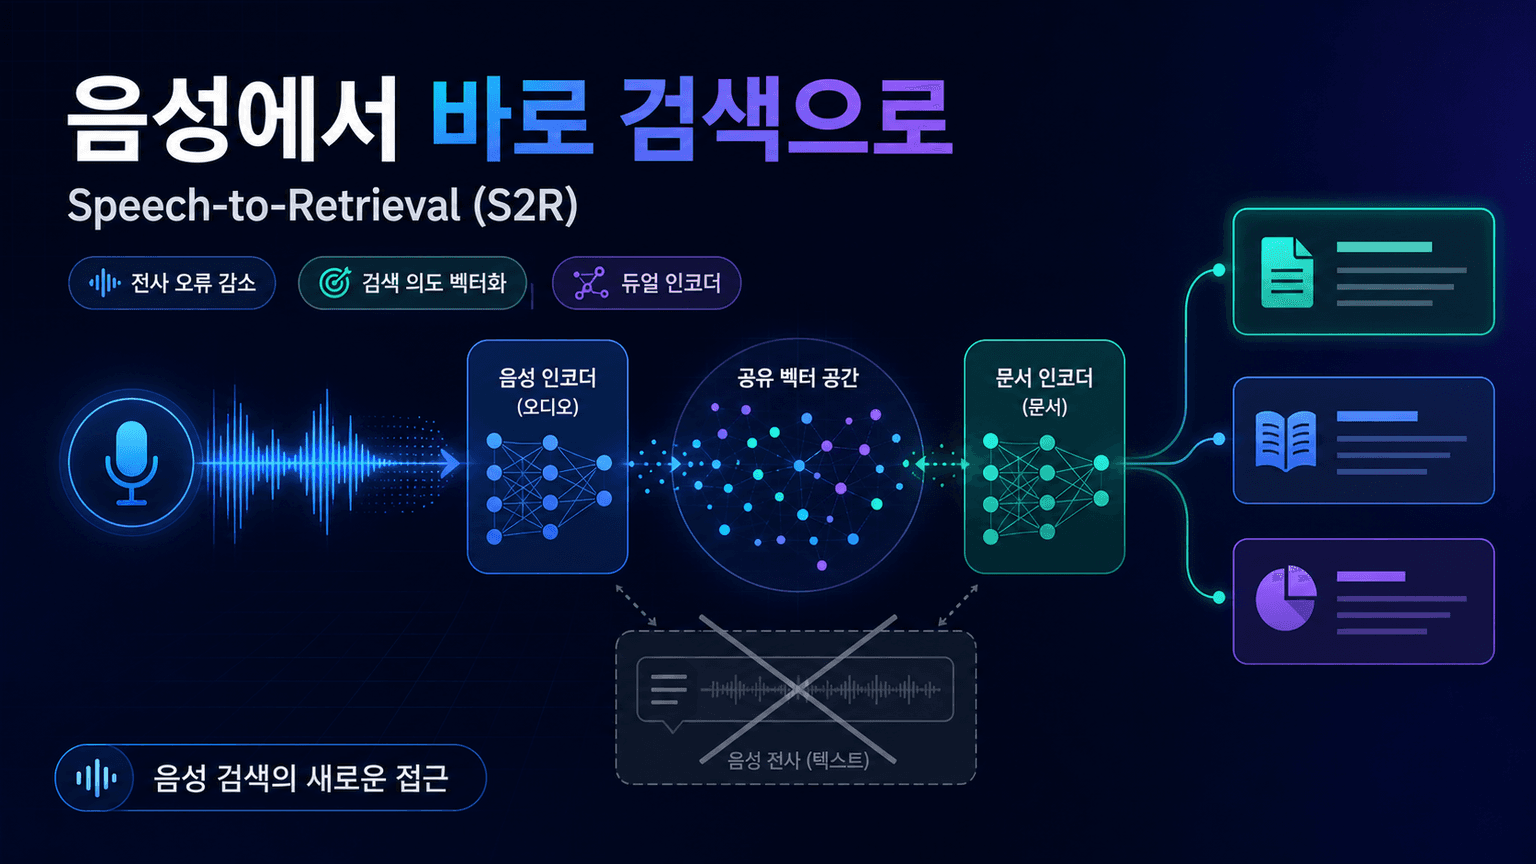
Google Research는 음성을 먼저 텍스트로 바꾸는 기존 음성 검색의 오류 전파 문제를 줄이기 위해, 발화에서 검색 의도를 직접 벡터화해 문서를 찾는 Speech to Retrieval(S2R) 방식을 도입하고 다국어 평가 데이터셋 SVQ를 공개했다.
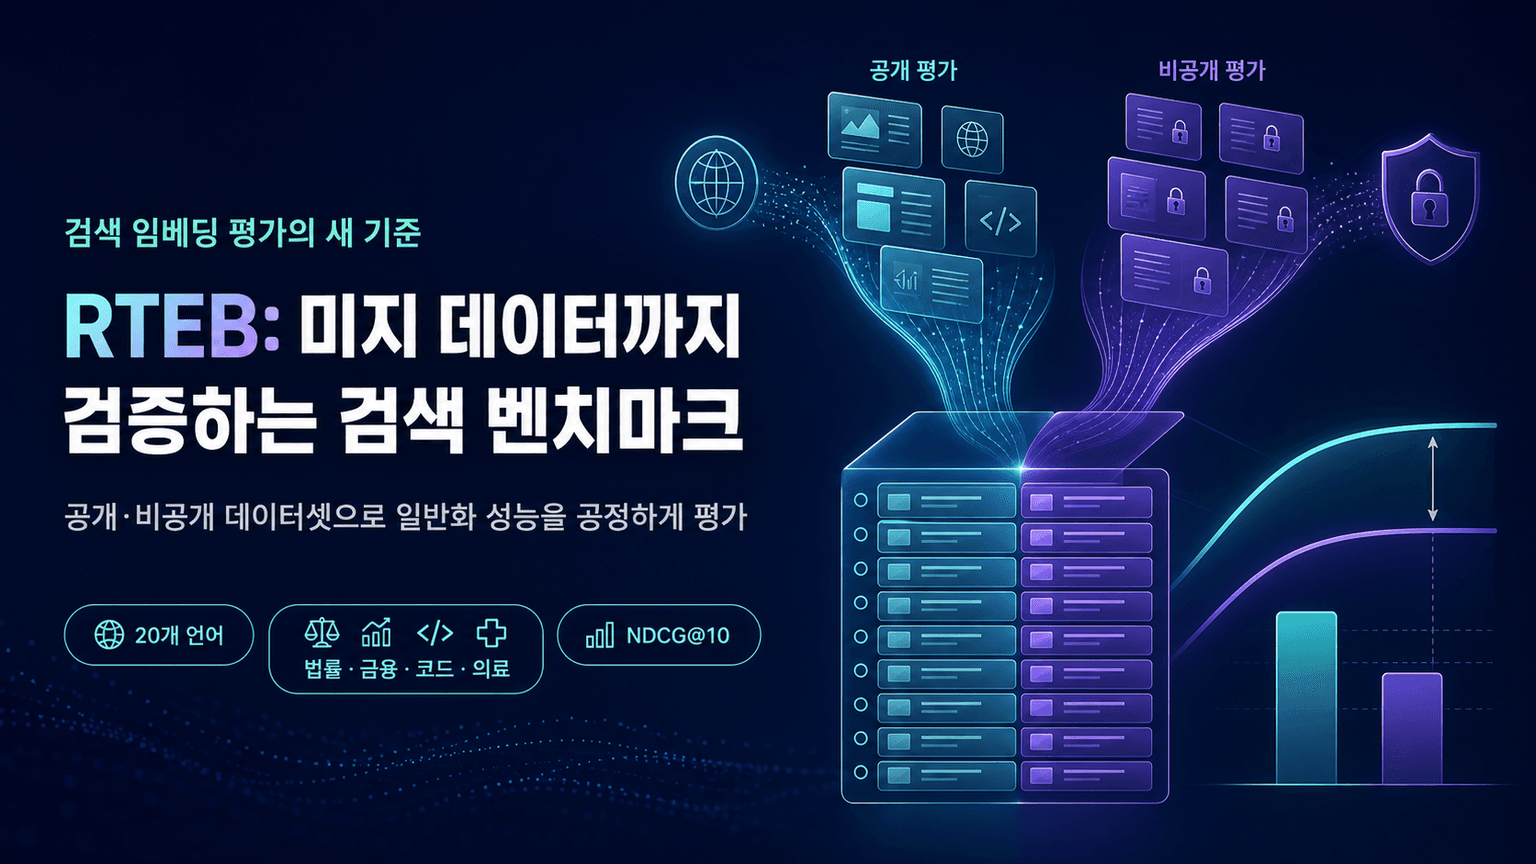
RTEB는 공개·비공개 데이터셋을 함께 활용해 임베딩 모델의 미지 데이터 검색 성능과 실제 응용 적합성을 공정하게 평가하려는 새로운 검색 벤치마크다.