이 태그와 연결된 문서를 한곳에서 모아보고, 함께 자주 등장하는 연관 태그까지 이어서 탐색할 수 있습니다.
연관 태그
총 262건 중 193-216건
ChatGPT는 공유 프로젝트, 지능형 커넥터, 강화된 규정 준수·관리 기능을 통해 조직의 협업 맥락을 통합하고 기업 데이터를 안전하게 활용하도록 지원한다.
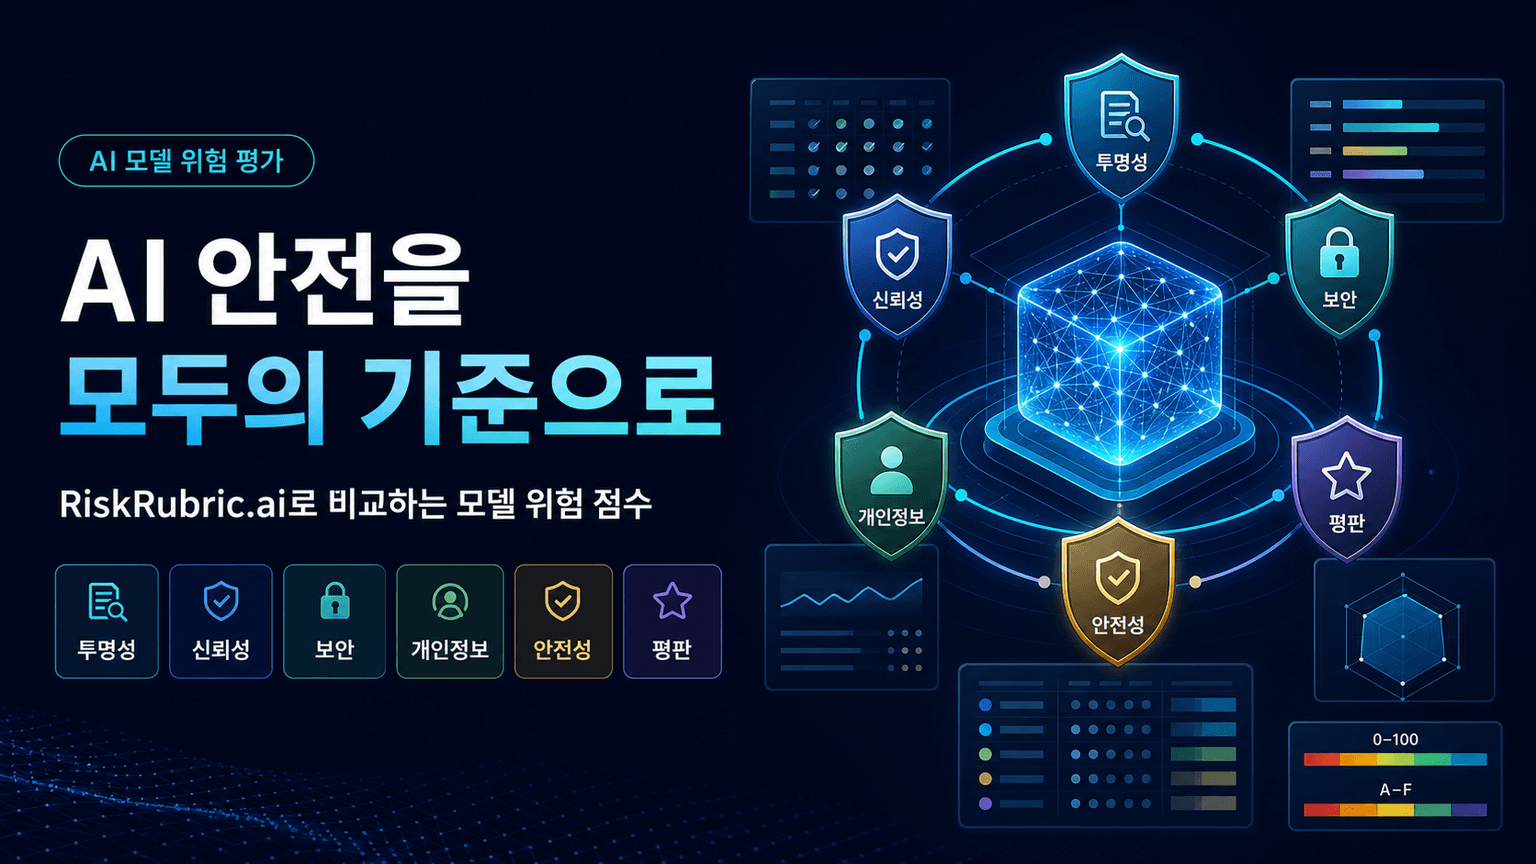
RiskRubric.ai는 인공지능 모델을 투명성·신뢰성·보안·개인정보 보호·안전성·평판의 여섯 축으로 평가해, 개발자와 조직이 비교 가능한 위험 점수에 근거하여 모델을 선택하고 배포하도록 돕는 공개 표준화 구상이다.
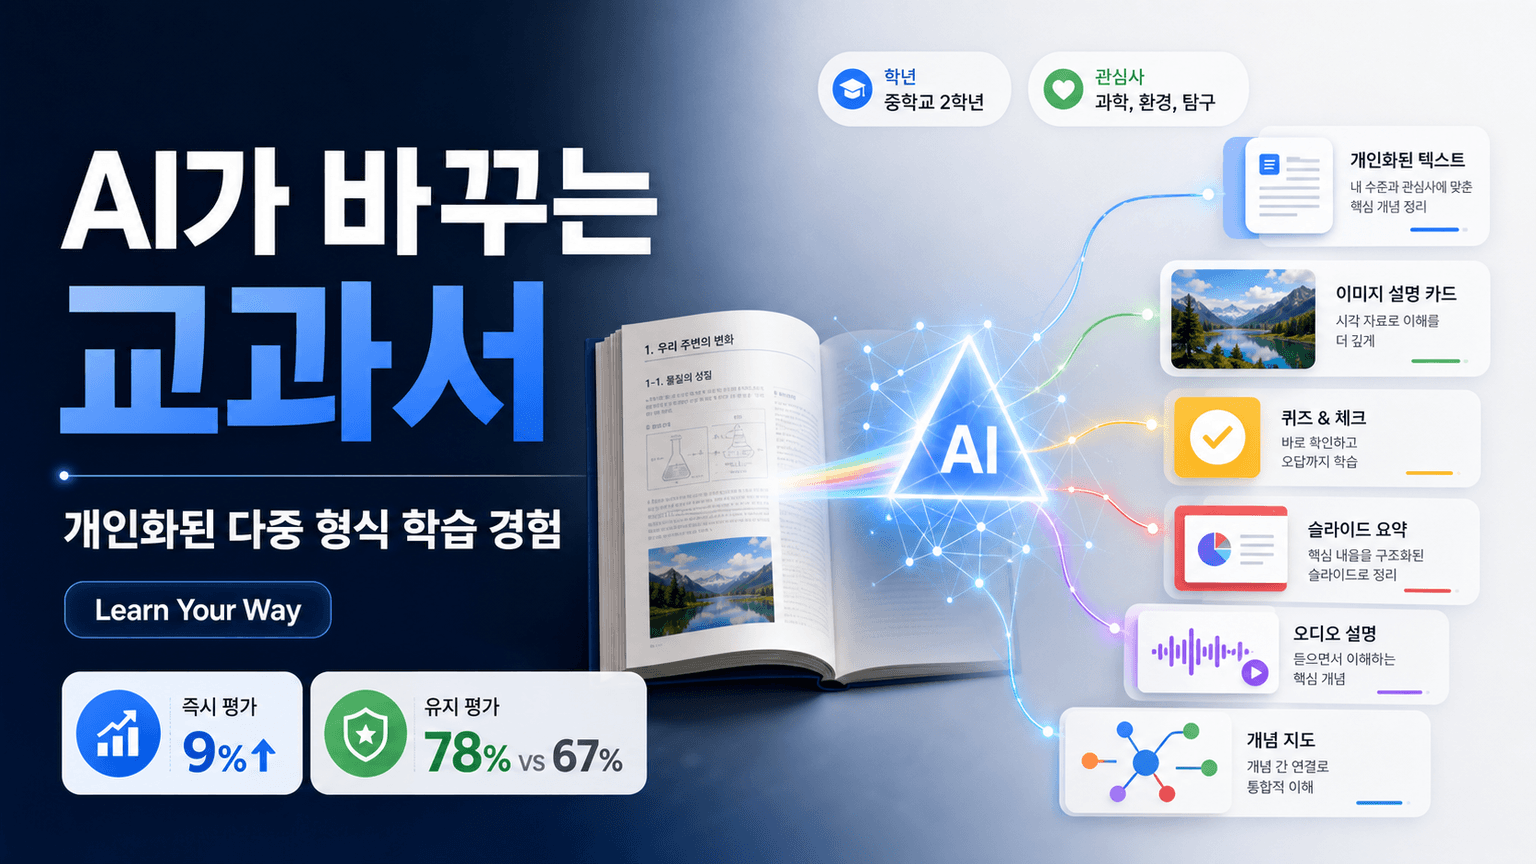
구글 리서치의 Learn Your Way는 생성형 AI로 교과서를 개인화된 다중 형식 학습 경험으로 바꾸고, 초기 연구에서 디지털 리더보다 학습 성과와 유지 점수를 높인 교육 실험이다.
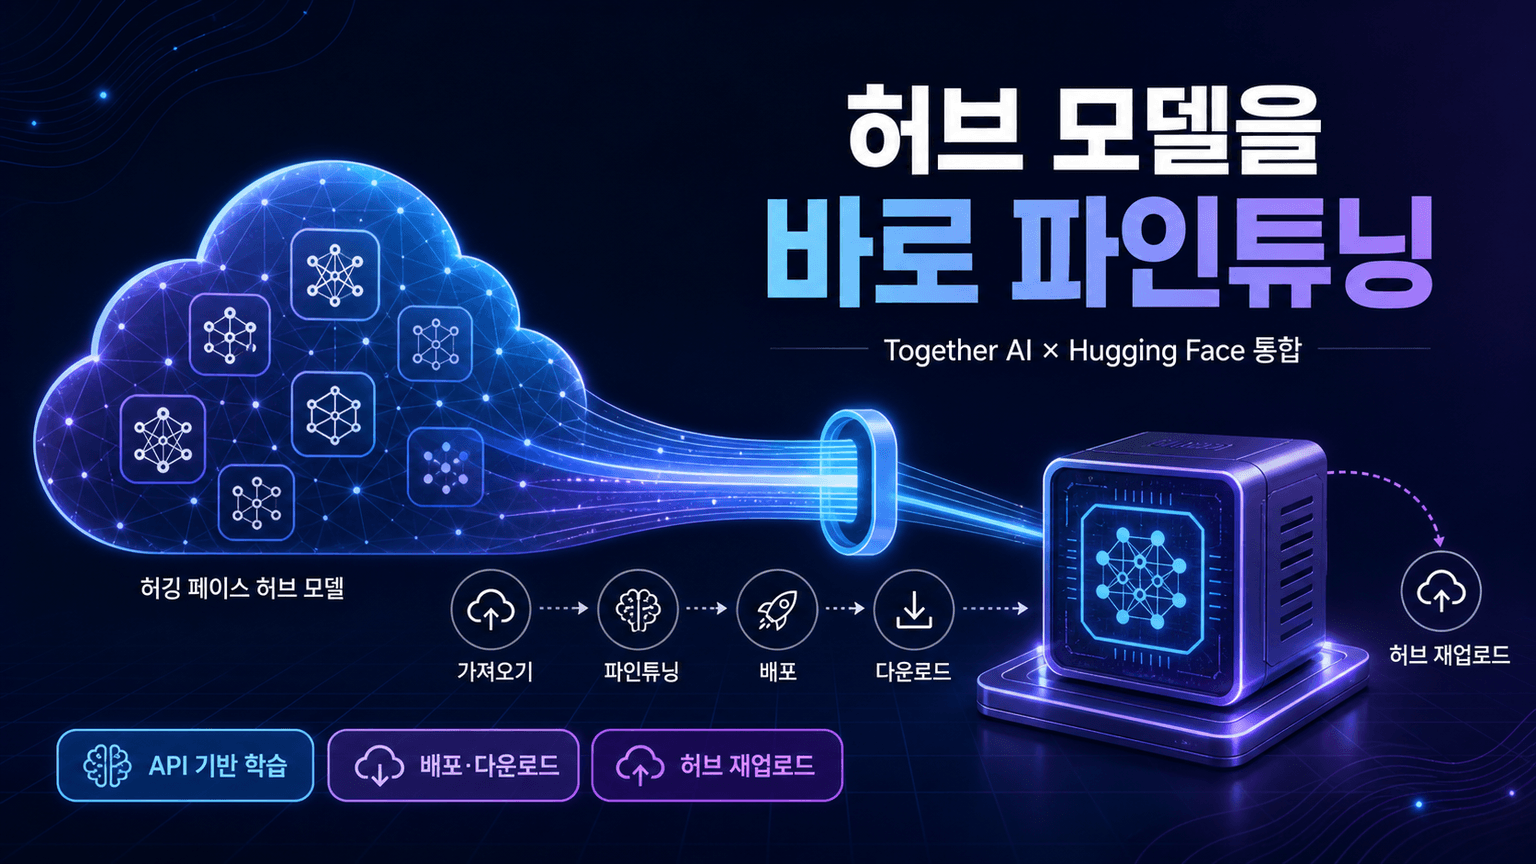
Together AI는 Hugging Face Hub의 호환 LLM을 자사 인프라에서 쉽게 파인튜닝하고 배포·다운로드·허브 재업로드까지 할 수 있는 기능을 발표했다.
OpenAI는 정신적·정서적 위기 상황에서 더 적절하게 대응하도록 전문가 협력, 추론 모델 자동 라우팅, 청소년 보호용 부모 관리 기능을 강화한다.
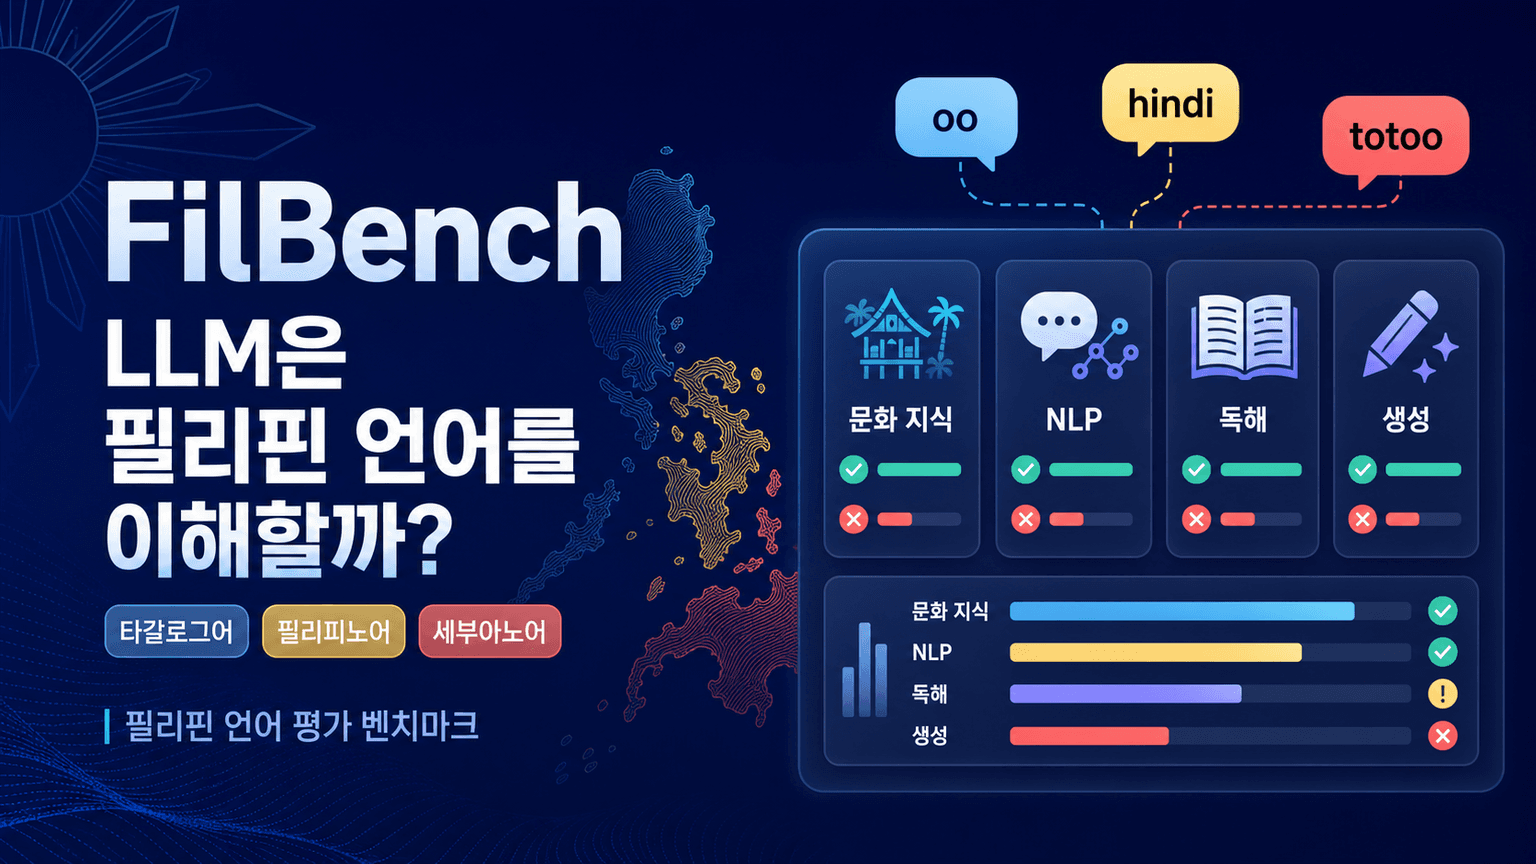
FilBench는 타갈로그어·필리피노어·세부아노어에 대한 대규모 언어 모델의 문화 지식, 전통적 자연어 처리, 독해, 생성 능력을 체계적으로 측정하고, 지역 특화 학습 데이터와 공개 가중치 모델의 가능성 및 번역 성능의 한계를 보여 주는 평가 모음이다.
구글 리서치 연구진은 대규모 사용자 기반 데이터 공개에서 개인 정보 보호를 유지하면서 더 많은 유용한 항목을 선택할 수 있는 차등 프라이버시 파티션 선택 알고리즘 MAD를 제안했다.
TNG는 머리말과 꼬리말을 의도적으로 생략하던 olmOCR를 8,000개 문서로 미세조정해, 문서의 논리적 읽기 순서를 유지하면서 업무상 중요한 주변 정보까지 충실하게 추출하는 OCR 모델로 개선했다.
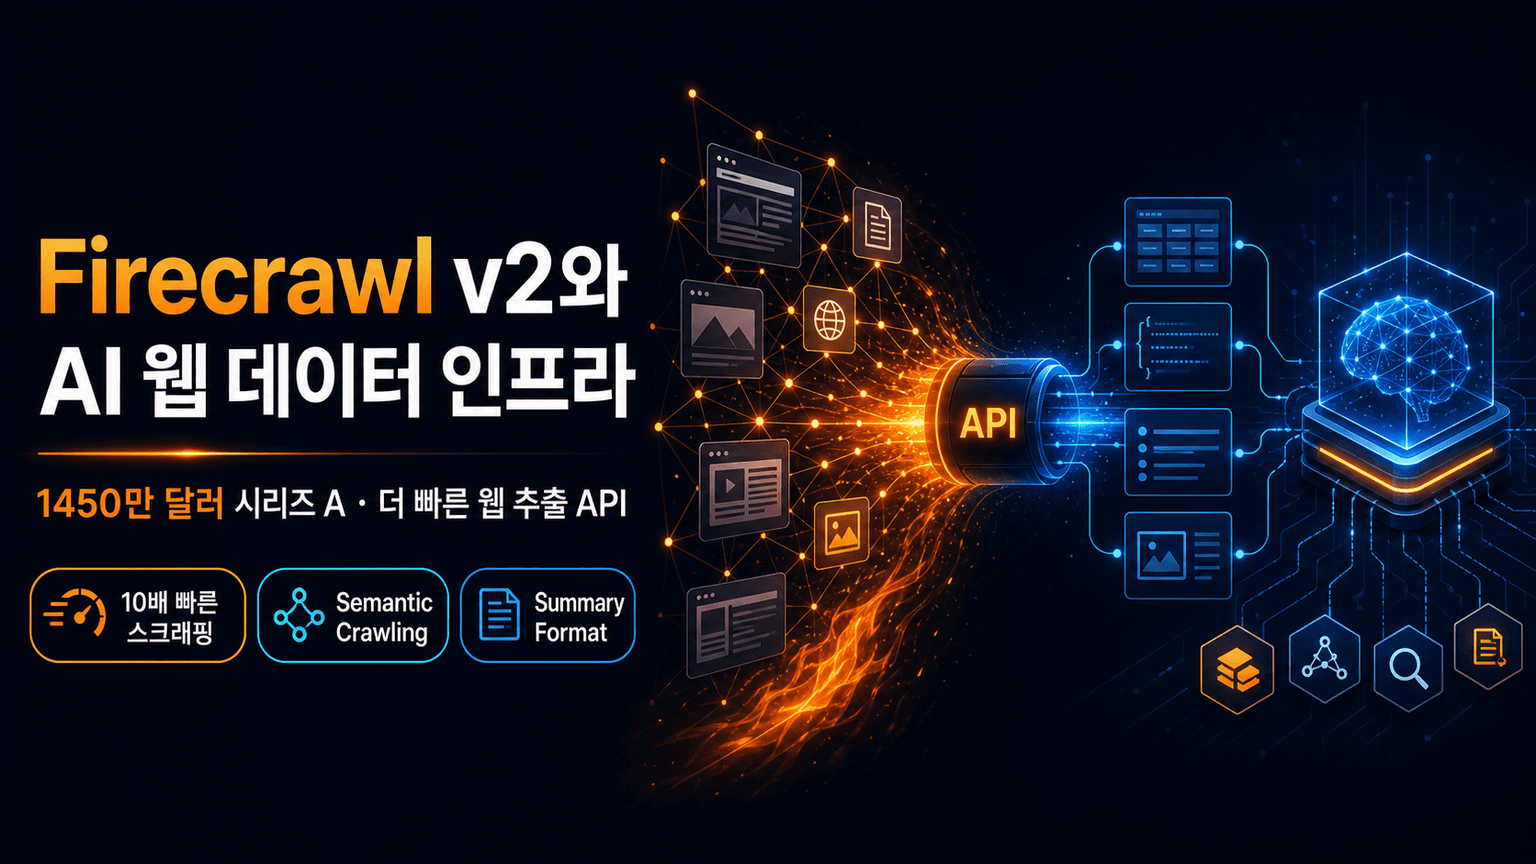
Firecrawl은 1450만 달러 규모의 시리즈 A 투자 유치와 v2 출시를 알리며, AI가 웹 데이터를 더 빠르고 안정적으로 활용하도록 하는 인프라 기업으로의 확장을 강조했다.
Convex의 Persistent Text Streaming 컴포넌트를 쓰면 WebSocket이나 SSE를 직접 다루지 않고도 React 채팅 앱에 ChatGPT식 실시간 응답 스트리밍을 빠르게 붙일 수 있다는 튜토리얼입니다.
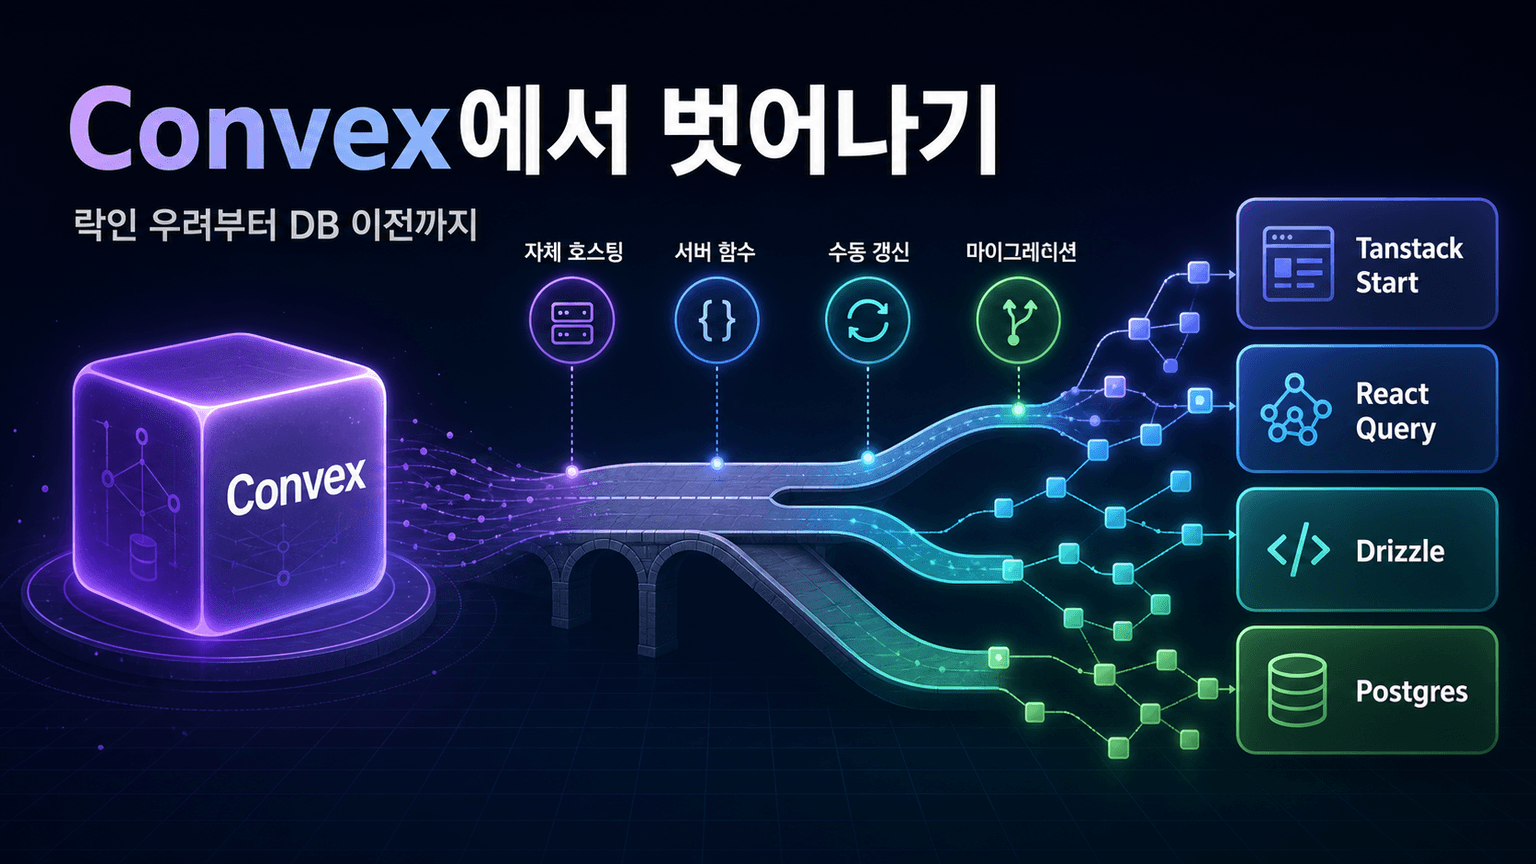
저자는 Convex에서 벗어나는 난이도를 직접 검증하기 위해 간단한 Tanstack Start 예제를 기준으로 함수, 클라이언트 호출, 반응형 쿼리, 데이터베이스 이전을 차례로 Tanstack Start와 Drizzle/Postgres로 옮겨 보며 실제 작업량과 복잡도 변화를 살펴본다.
Gradio의 MCP 통합을 이용해 웹 탐색 도구와 IDM VTON 가상 피팅 모델을 연결하고, VS Code AI 채팅에서 사용할 수 있는 개인용 AI 쇼핑 도우미를 구현하는 방법을 설명한다.
동시 요청을 처리하는 LLM 추론에서는 프리필과 디코드의 계산 특성이 달라, 첫 토큰 지연·토큰 생성 지연·총처리량·GPU 활용률 사이의 균형에 맞춰 배칭과 프리필 청크 크기를 조정해야 한다.
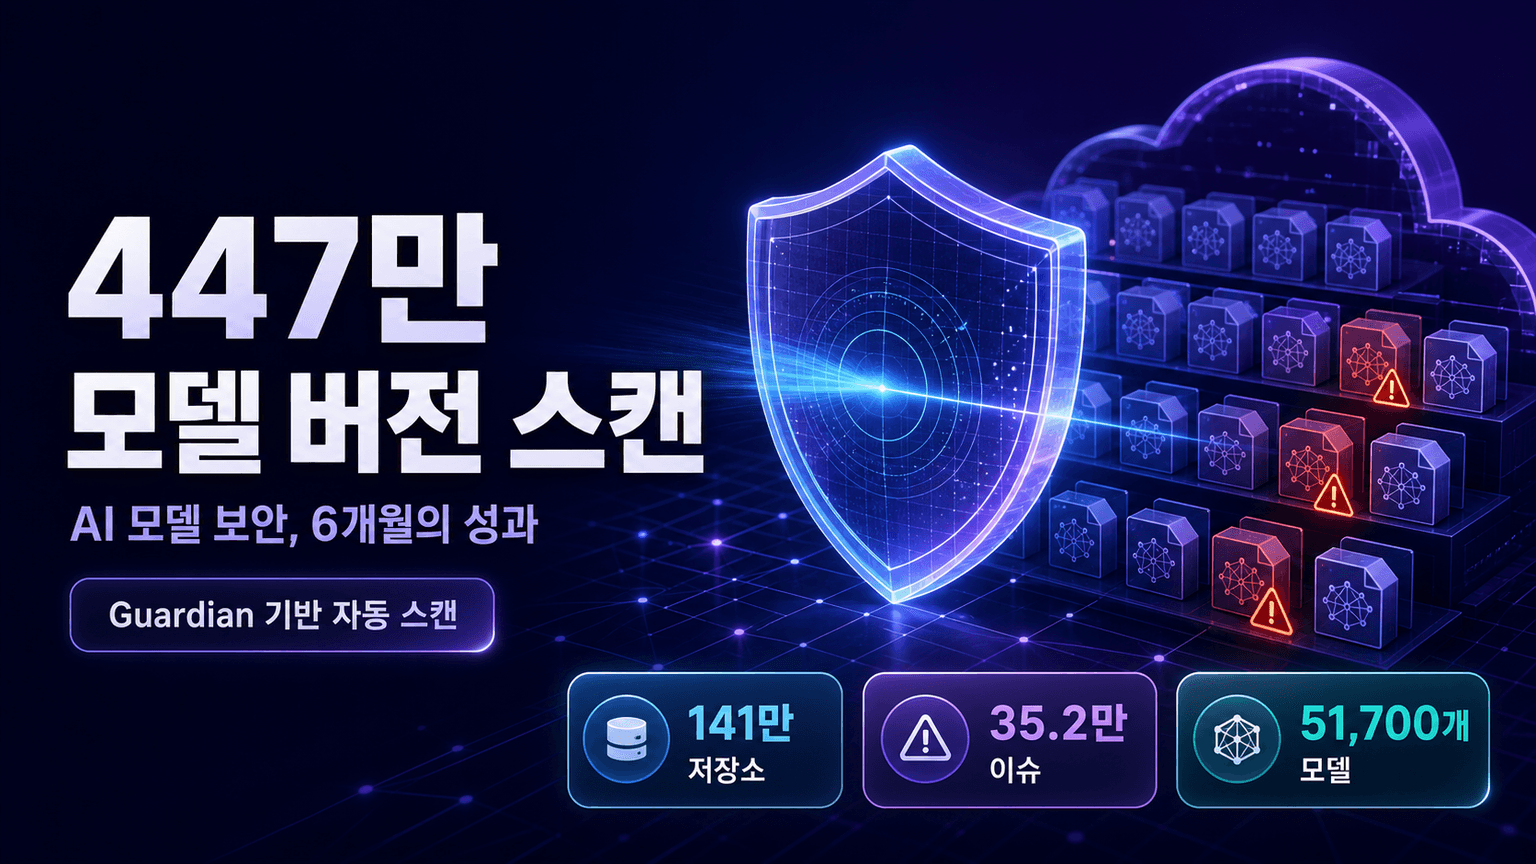
Protect AI와 Hugging Face의 6개월 파트너십은 Guardian 스캔으로 447만 개 모델 버전을 검사하고 35.2만 건의 unsafe/suspicious 이슈를 찾아, 공개 모델 사용자가 보안 위험을 더 명확히 판단하도록 돕고 있다.
Ulysses Sequence Parallelism은 긴 시퀀스 학습에서 시퀀스와 어텐션 헤드를 함께 나누고 all to all 통신으로 재배치해, 단일 GPU 메모리 한계를 넘어 수십만~백만 토큰 문맥 학습을 가능하게 하는 방식이다.
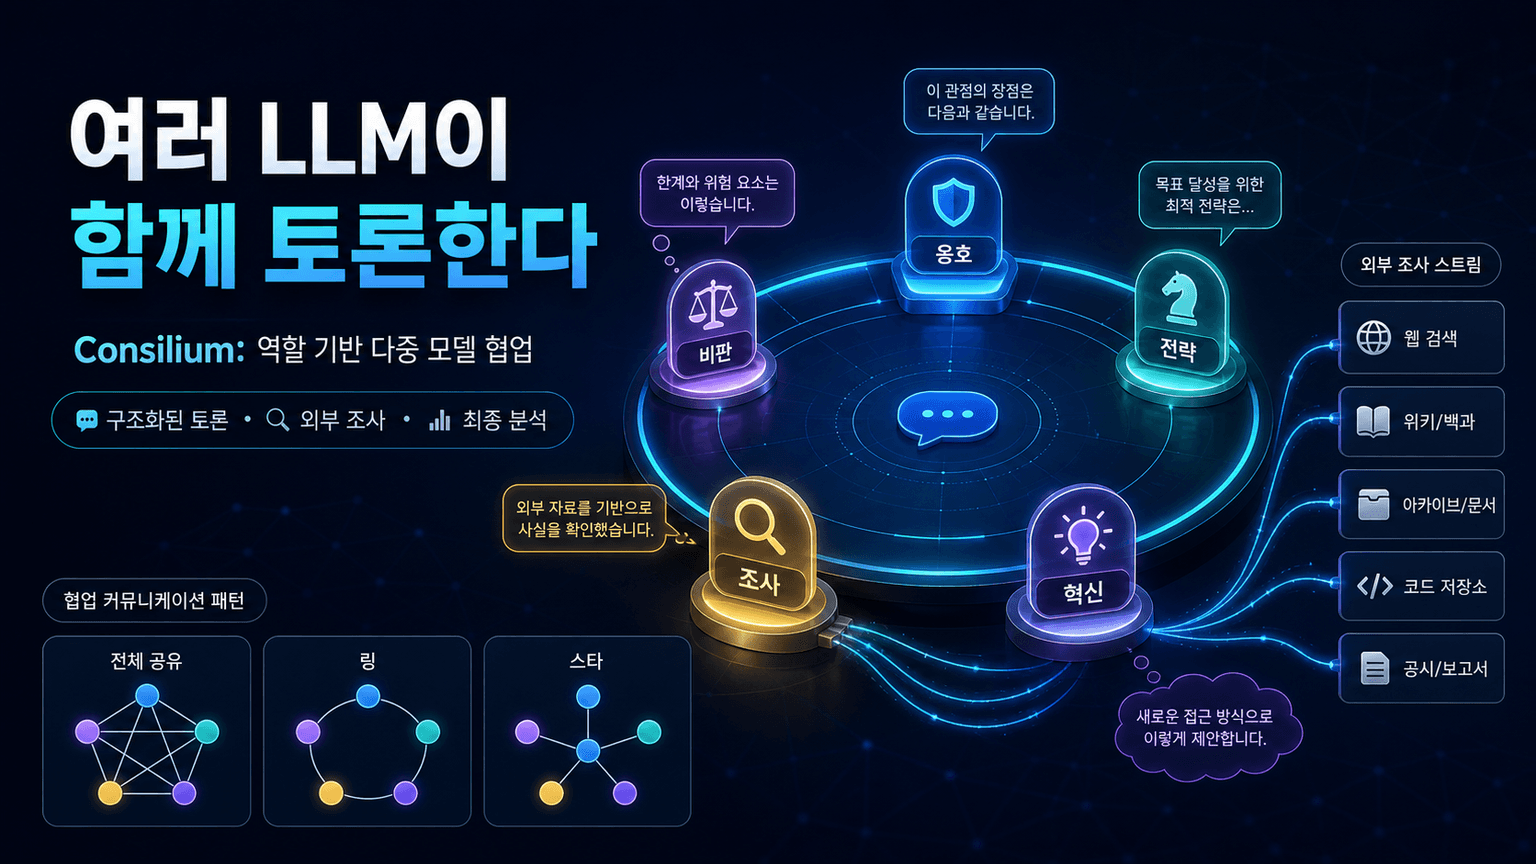
Consilium은 서로 다른 역할을 맡은 여러 언어 모델이 구조화된 토론과 외부 조사를 거쳐 합의 또는 최종 분석을 도출하도록 만든 시각적 다중 모델 협업 플랫폼이다.
2024년 창작 AI는 오픈소스 이미지 생성의 구조적 도약과 개인화 기술의 대중화를 이뤘으며, 2025년에는 비디오·오디오·3D 등 더 다양한 형식으로 발전의 중심이 이동하고 있다.
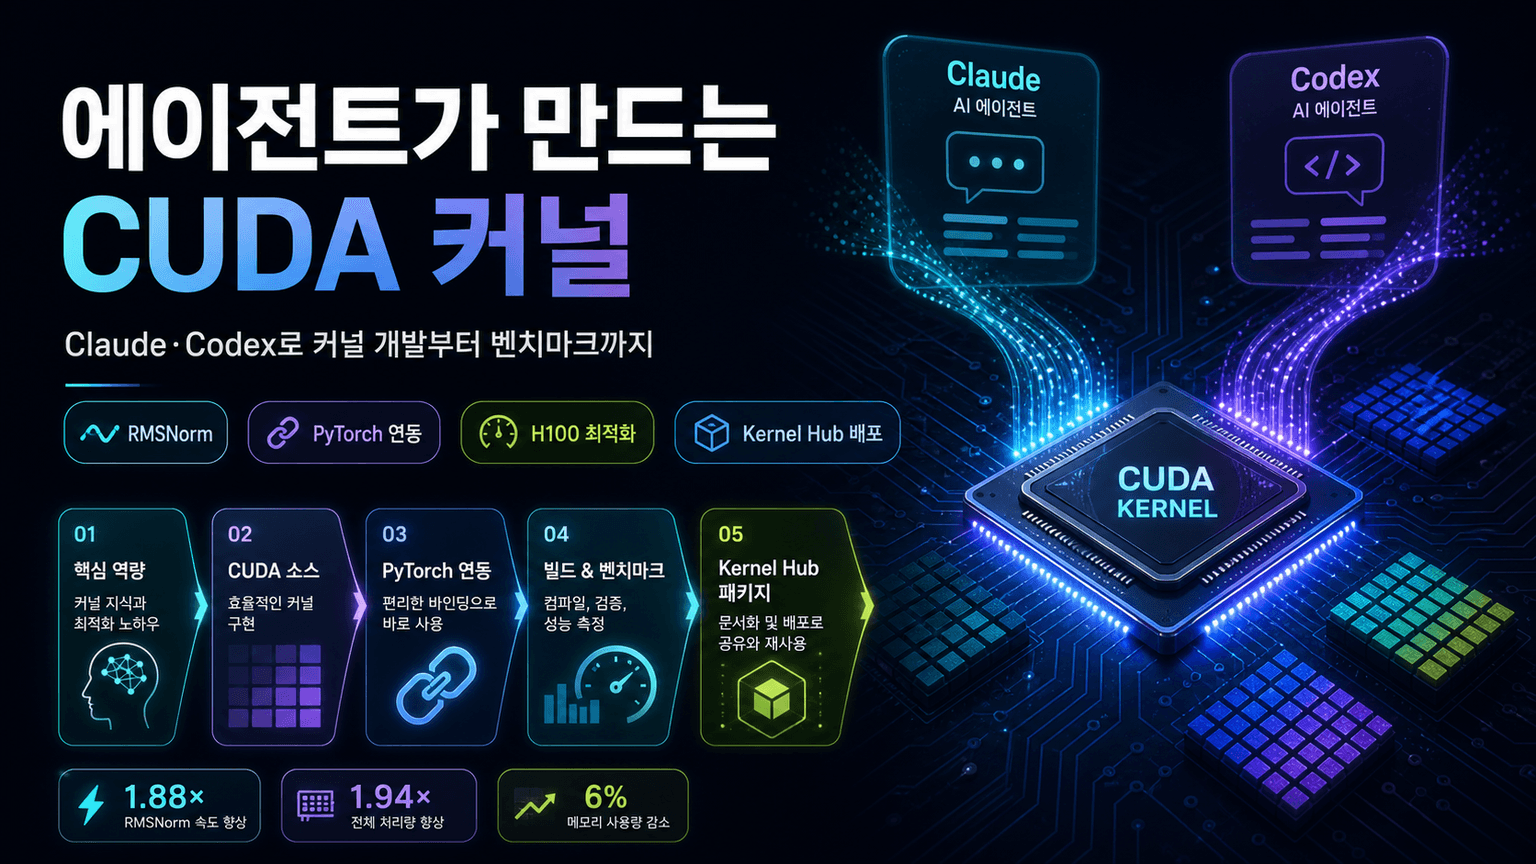
CUDA 커널 개발 지식을 에이전트 스킬로 구조화해 Claude와 Codex가 실제 diffusers·transformers 대상의 커널, PyTorch 바인딩, 빌드 구성, 벤치마크까지 완성하도록 한 사례다.
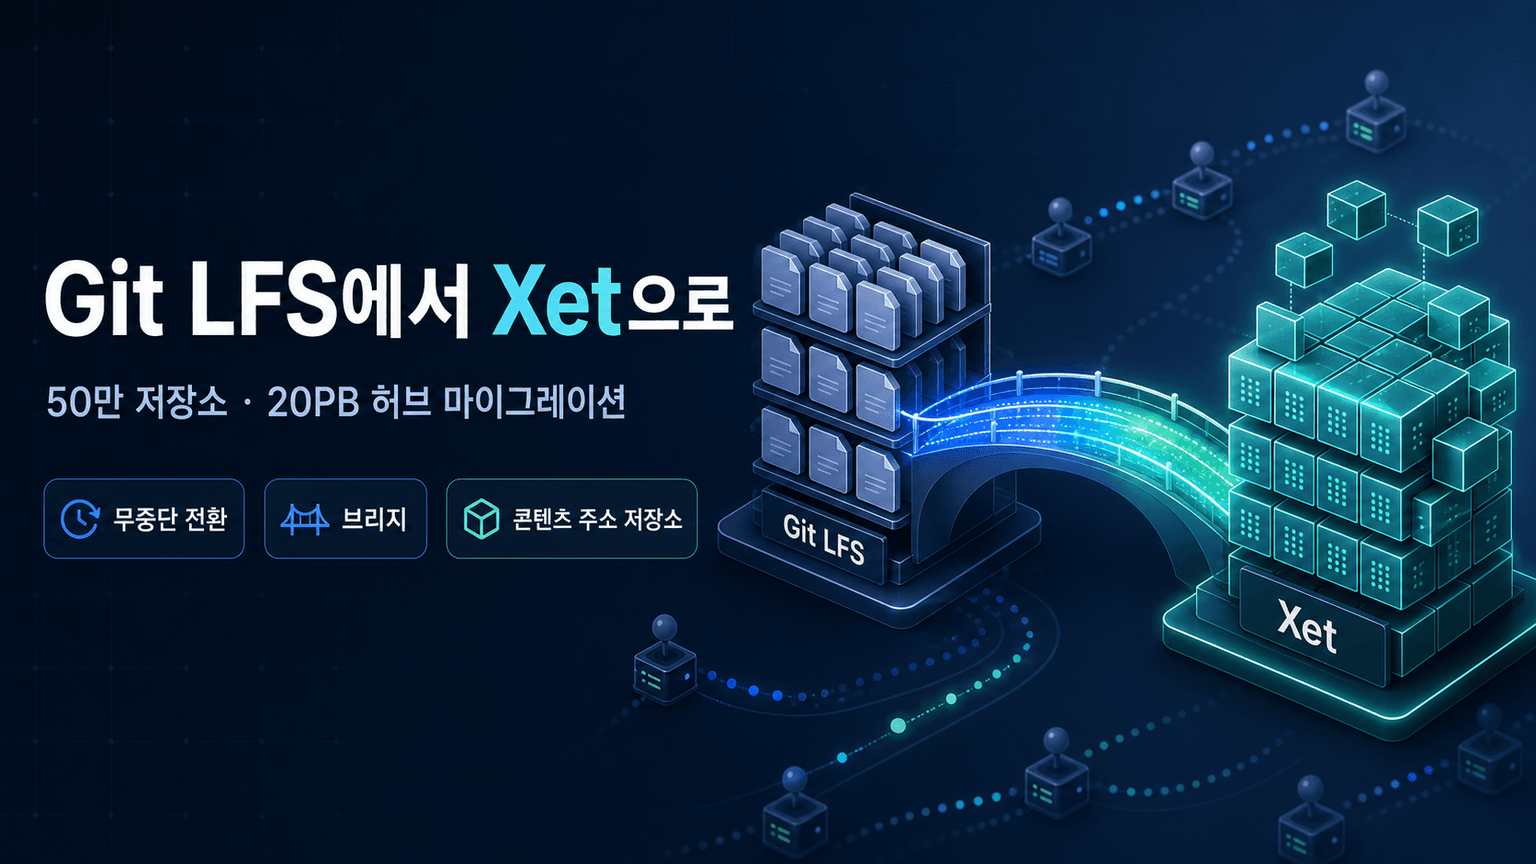
허깅페이스는 기존 사용자의 작업 방식을 유지하는 브리지와 무중단 백그라운드 마이그레이션을 기반으로, 50만 개 저장소와 20페타바이트 규모의 허브를 깃 대용량 파일 저장소에서 젯으로 전환하고 있다.
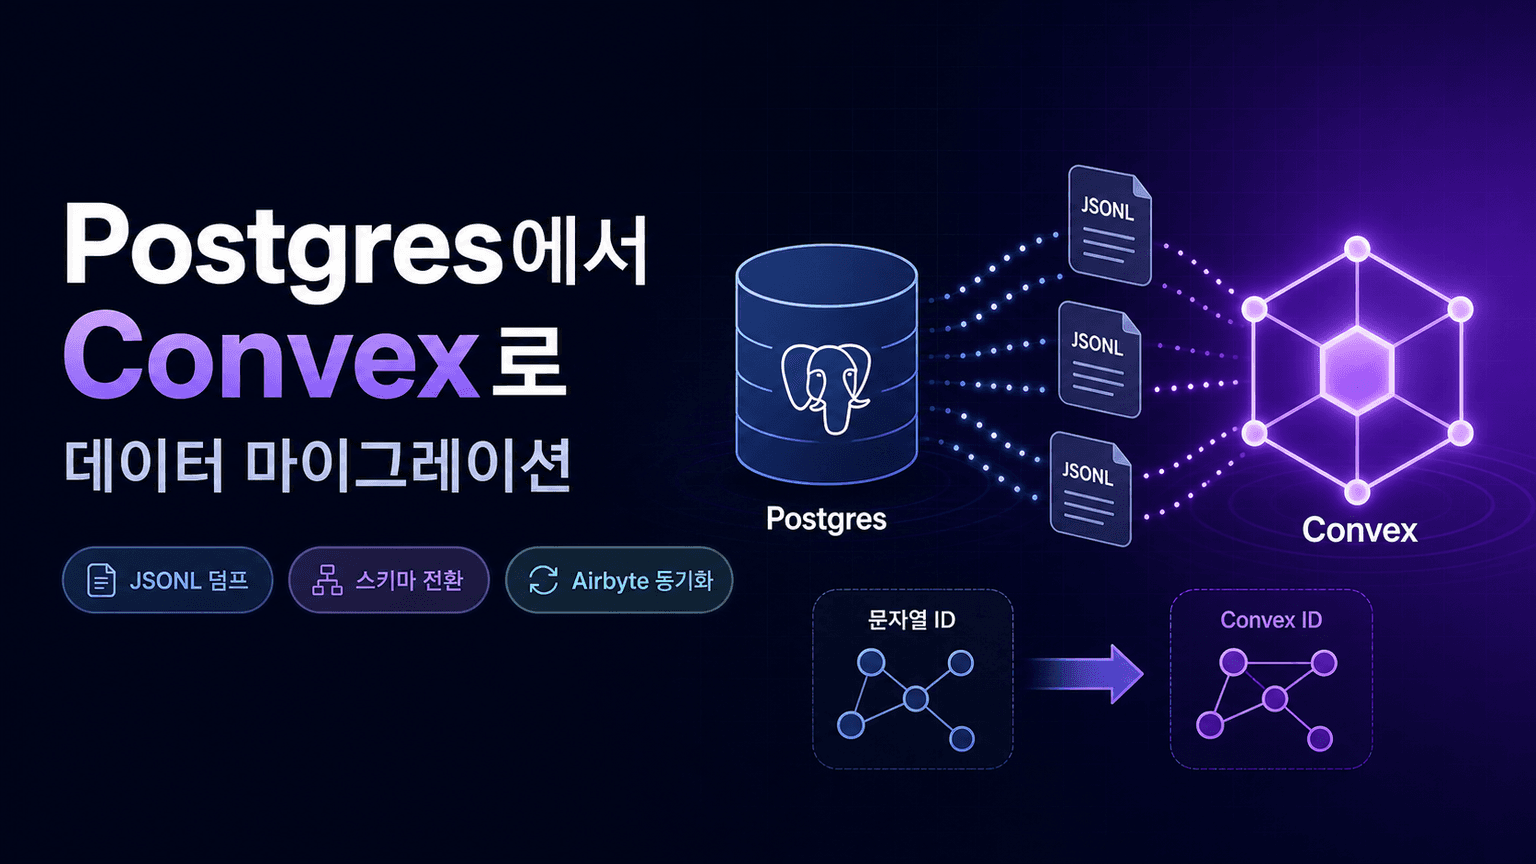
Postgres 데이터를 Convex로 이전하는 방법은 소규모 데이터의 JSONL 덤프·가져오기에서 시작해, 스키마 정의와 관계 필드의 Convex ID 전환, 필요 시 Airbyte 기반 스트리밍 가져오기까지 이어진다.
허깅페이스 인프라팀은 네트워크 트래픽 임계치와 로그 보관 성공률 같은 경보를 통해 비용 증가, 구성 오류, 로그 유실을 대형 장애로 번지기 전에 탐지한다.
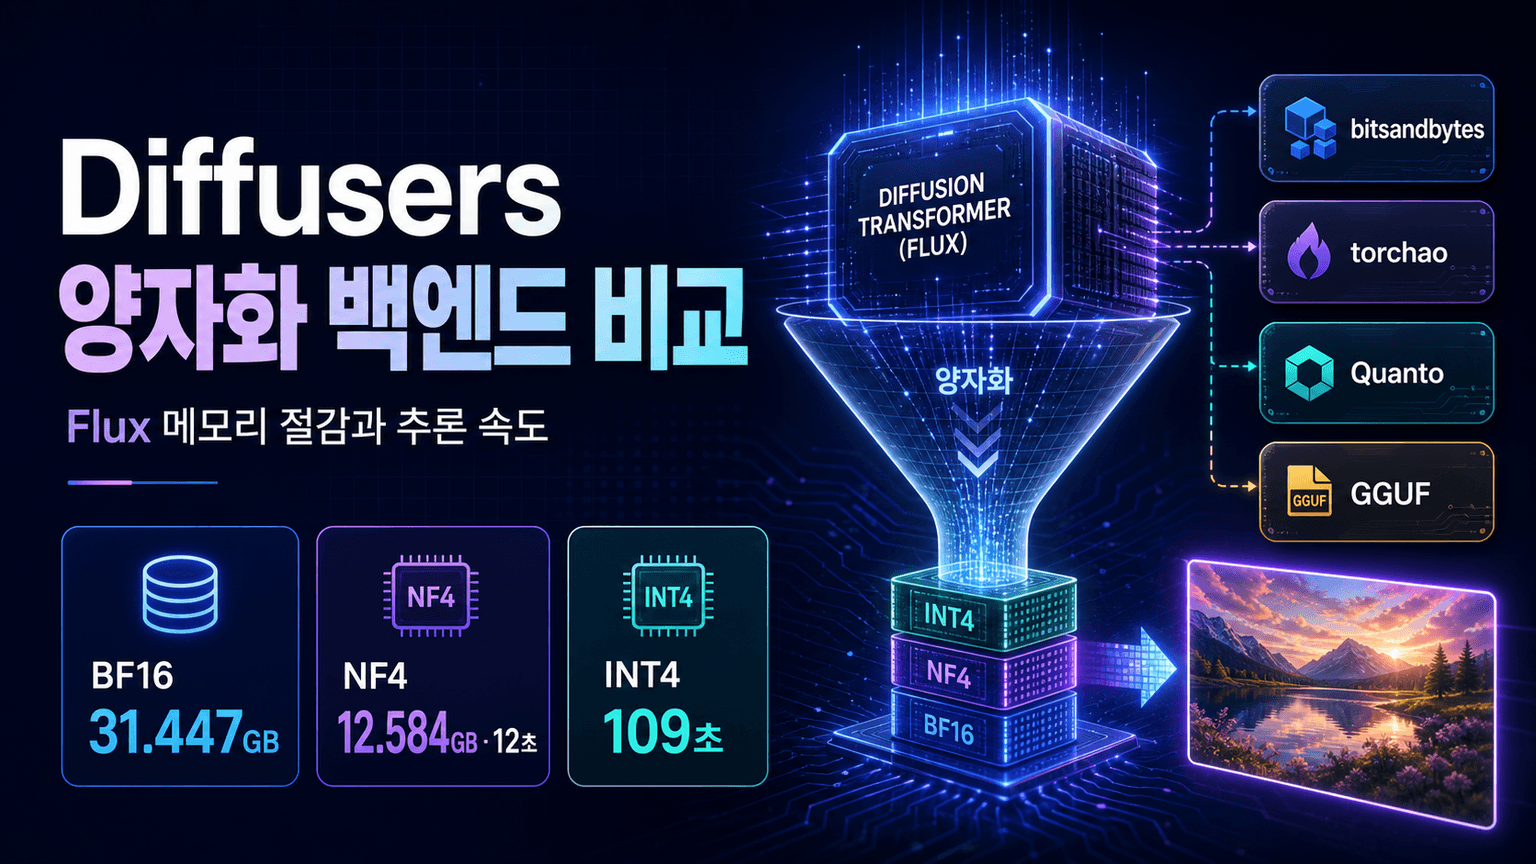
Diffusers는 Flux의 핵심 구성 요소를 여러 백엔드로 양자화해 이미지 품질을 크게 훼손하지 않으면서 메모리 사용량을 줄일 수 있으며, 정밀도와 백엔드에 따라 속도·메모리·사용 편의성의 차이가 뚜렷하다.
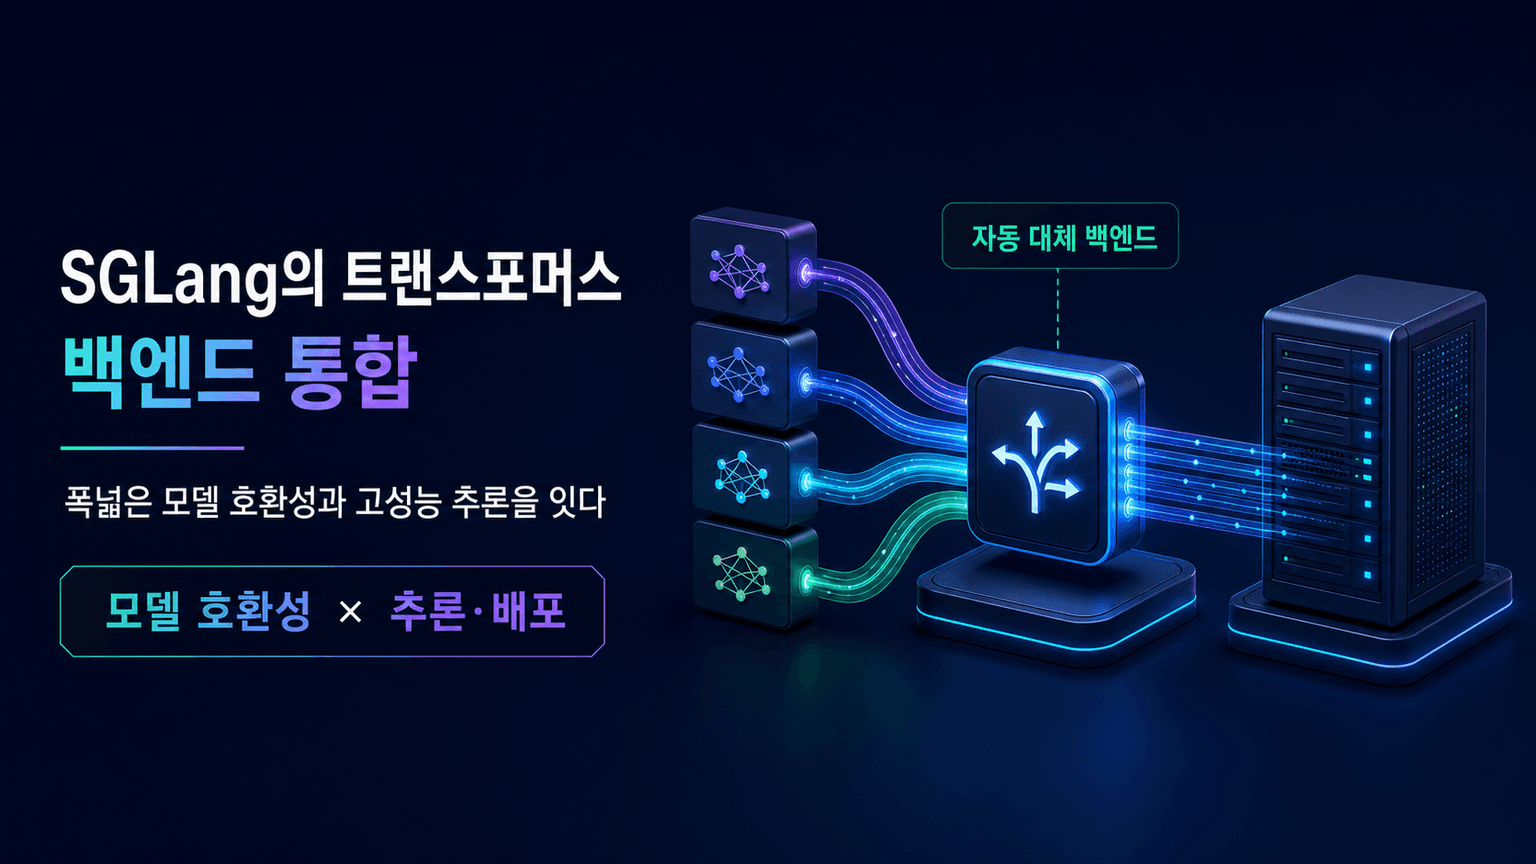
SGLang은 트랜스포머스 호환 모델을 자동 대체 백엔드로 실행해 폭넓은 모델 접근성과 고성능 추론·배포 기능을 결합합니다.
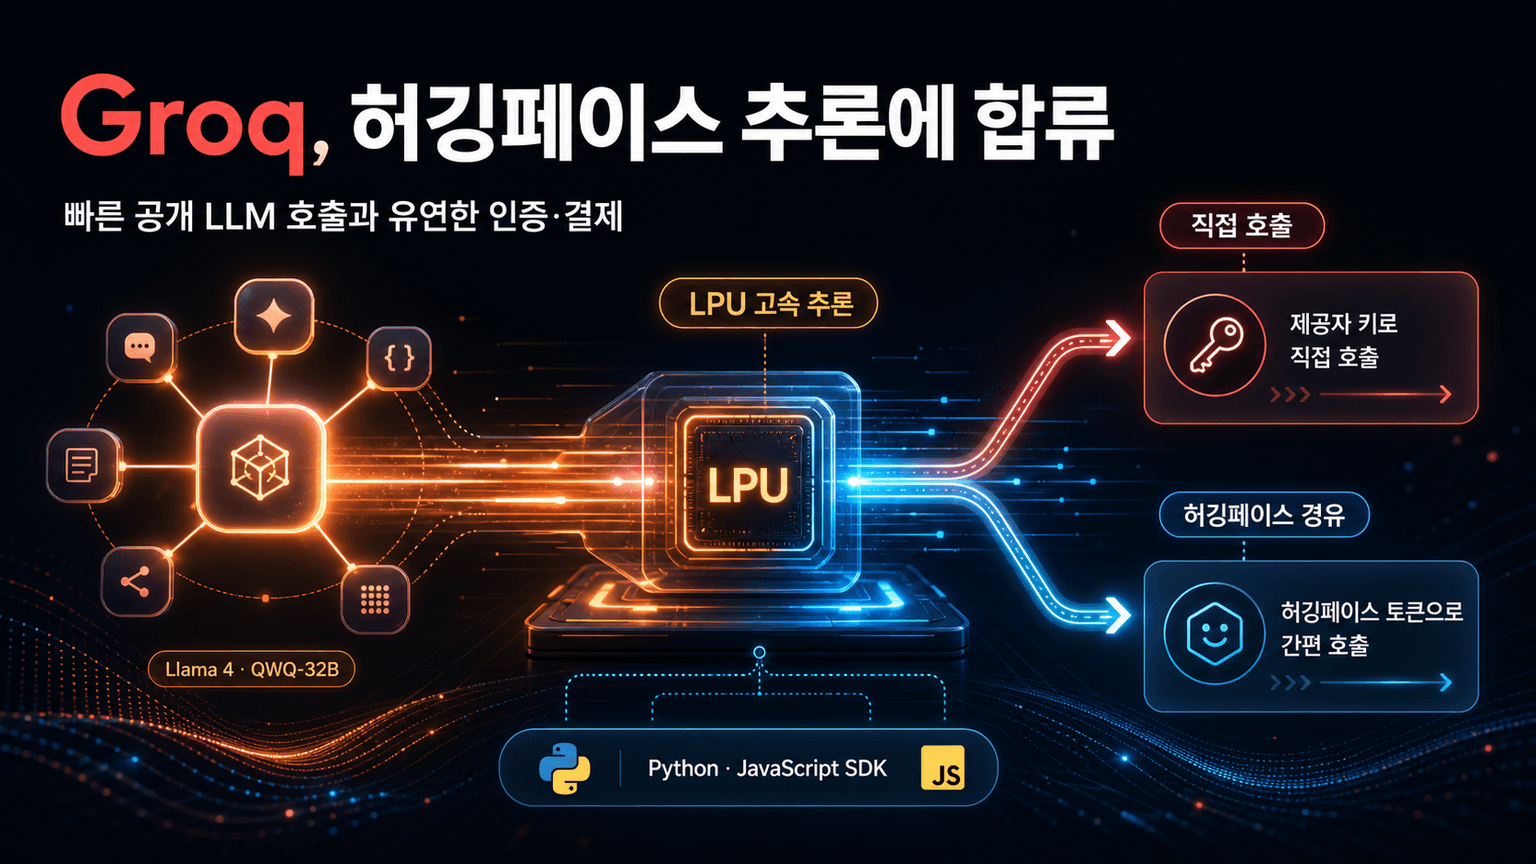
허깅페이스 허브의 추론 제공업체에 Groq가 추가되어, 사용자는 모델 페이지와 Python·JavaScript SDK에서 공개 대규모 언어 모델을 빠르게 호출하고 인증 및 결제 방식도 선택할 수 있게 됐다.