이 작성자와 연결된 문서를 한곳에서 모아보고, 관련 태그를 따라 같은 맥락의 문서를 이어서 탐색할 수 있습니다.
자주 함께 등장한 태그
총 26건 중 1-24건
AI in Healthcare Series: Have We Already Bent the Healthcare Cost Curve를 중심으로, 예측 대비 절감과 지출 자체의 감소는 다르다. 영상에서 인용한 연구에 따르면 2024년 미국 의료비는 GDP의 18%로를 핵심 판단 포인트로 압축 정리한다.
Stanford Webinar A Conversation on the Future of Translational Medicine를 중심으로, 중개연구의 출발점은 임상적 필요다. 기초과학자와 임상의가 서로의 질문과 활용 가능한 지식을 이해해야 발견을 실제 치료·진단으로 연를 핵심 판단 포인트로 압축 정리한다.
When AI Stops Being a Project: Turning Technology into Real Value for Patients and Providers를 중심으로, 생성형 AI는 단순 질의응답에서 벗어나 여러 단계를 추론·결정·실행하는 에이전트로 발전하고 있지만, 의료기관의 협업 구조와 통제를 핵심 판단 포인트로 압축 정리한다.
Stanford AA203 Optimal and Learning Based Control를 중심으로, 강의는 샘플링을 활용하는 학습 맥락에서 시간차 학습을 소개하고, 임의로 초기화된 가치함수를 반복적으로 갱신하는 접근을 다룬다를 핵심 판단 포인트로 압축 정리한다.
Stanford AA203 19강은 PPO로 모델 프리 정책 최적화를 정리한 뒤, 동역학 모델의 불확실성을 계획에 반영해 샘플 효율적인 모델 기반 강화학습을 구현하는 원리를 설명한다.
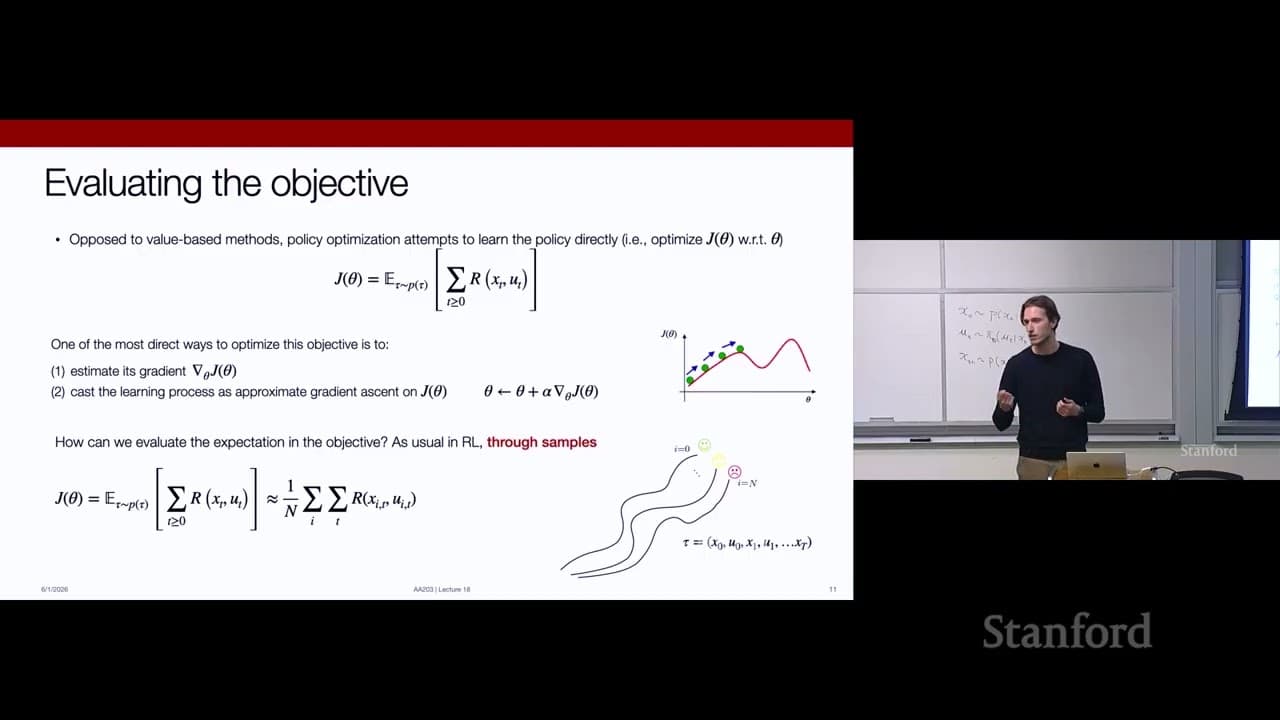
Stanford AA203 18강은 정책 그래디언트로 기대 누적 보상을 직접 최적화하고, reward to go·베이스라인·actor critic으로 추정량의 고분산을 낮추는 원리를 설명한다.
스탠퍼드 AA203의 강화학습 기초 강의는 동적 계획법에서 몬테카를로·시간차 학습으로 확장하며, 경험으로 가치를 추정하고 탐색을 통해 정책을 개선하는 원리를 설명한다.
Stanford CS329A Self Improving AI Agents를 중심으로, ReAct는 생각·행동·관찰을 순차적으로 연결해 모델 내부 지식만으로 답할 때 생기는 환각을 줄인다. 검색이나 도구 호출의 결과를를 핵심 판단 포인트로 압축 정리한다.
Show It or Tell It?에 대한 답은 하나를 고르는 것이 아니라, 과제·사용자·맥락에 따라 텍스트, 시각화, 그리고 결합의 역할을 다르게 설계하는 것이다.
Stanford MS&E435가 제시한 AI 슈퍼사이클의 GPU 경제는 제한된 전력·메모리·반도체로 더 많은 토큰과 유용한 지능을 생산해 막대한 컴퓨트 투자를 회수하는 효율 경쟁이다.
Stanford CS153의 Frontier Systems 논의는 프런티어 생태계의 승부가 모델 접근성보다 기업이 자기 데이터·평가 환경·컴퓨트 인프라로 고유 IP를 계속 축적할 수 있느냐에 달려 있음을 보여준다.
AI Supercycle의 핵심은 Coding AI가 소프트웨어 창작자를 늘리는 데서 끝나지 않고, 배포·실행·토큰·샌드박스·보안까지 포함한 새 인프라 경제를 만든다는 점이다.
Building AI Factories의 핵심은 GPU를 많이 사는 문제가 아니라, 전력·냉각·네트워크·건설 노동·입지를 묶어 디지털 노동을 생산하는 거대한 AI 공장을 실제로 지을 수 있느냐에 있다.
AI in Healthcare의 핵심은 Open Evidence 같은 임상 도구의 확산보다, 환자 접근권·병원 사이버보안·지불 구조를 함께 설계해야 한다는 점이다.
Stanford MS&E435의 AI Supercycle 강연은 Applied AI의 승부처가 더 좋은 앱 자체를 넘어, 폭증하는 인퍼런스를 싸고 빠르고 안정적으로 운영하는 커스텀 모델·후훈련·컴퓨트 확보 능력으로 이동하고 있음을 보여준다.
Stanford CS336 Language Modeling from Scratch의 Dan Fu 강의는 언어모델의 다음 병목이 모델 학습 자체보다 추론 엔진, GPU 커널, KV 캐시, 프리필·디코드 분리, 반복 구조 설계에 있다는 점을 보여준다.
The Modern Motivators of Play의 핵심은 현대 게임 설계가 경쟁과 숙련만이 아니라 자기표현, 동반감, 스트레스 완화, 교육까지 포함한 플레이어 동기에서 출발해야 한다는 점이다.
Stanford CS25의 Native Multimodal Intelligence 논의는 Language Models의 토큰화·스케일링 원리를 이미지·오디오·비디오로 확장하되, 멀티모달 생성과 이해를 하나의 표현으로 통합하는 문제는 아직 열린 연구 과제임을 보여준다.
Stanford CS336 Lecture 17: Alignment Multimodality는 텍스트 중심 언어 모델을 이미지·비디오까지 다루는 멀티모달 모델로 확장할 때, 핵심 병목이 “비텍스트 정보를 어떤 토큰·임베딩으로 바꿔 transformer에 넣고 학습할 것인가”에 있음을 보여준다.
Serving Transformers의 핵심은 모델을 잘 만드는 것을 넘어, 워크로드·지연 시간·하드웨어·관측성·최적화를 함께 설계해 실제 inference를 안정적으로 돈이 되는 서비스로 만드는 것이다.
Geometry in Robot Learning의 핵심은 로봇 학습을 무작정 더 큰 데이터와 모델로 밀어붙이기보다, 기하·대칭성·좌표계 구조를 모델에 넣어 데이터 효율성과 자세 일반화를 높이려는 것이다.
Stanford CME296 Diffusion & Large Vision Models Lecture 8의 핵심은 이미지 생성이 DDPM·score matching·SDE를 거쳐 flow matching과 DiT 중심으로 정리되고, 그 흐름이 비디오 생성·이미지 편집·텍스트 확산까지 확장된다는 점이다.
Stanford CME296 Lecture 7 Evaluation은 텍스트 이미지 생성 모델 평가가 “보기 좋은가”와 “프롬프트를 따르는가”에서 출발해, 인간 선호·분포 기반 지표·지각 유사도·멀티모달 judge까지 확장되는 문제임을 보여준다.
The Road Ahead: Resilience Required의 핵심은 사이버보안이 데이터 유출 대응을 넘어 운영 복원력, 투명한 커뮤니케이션, 법적 책임을 동시에 견디는 리더십 문제로 바뀌었다는 점이다.