이 작성자와 연결된 문서를 한곳에서 모아보고, 관련 태그를 따라 같은 맥락의 문서를 이어서 탐색할 수 있습니다.
자주 함께 등장한 태그
총 26건 중 25-26건
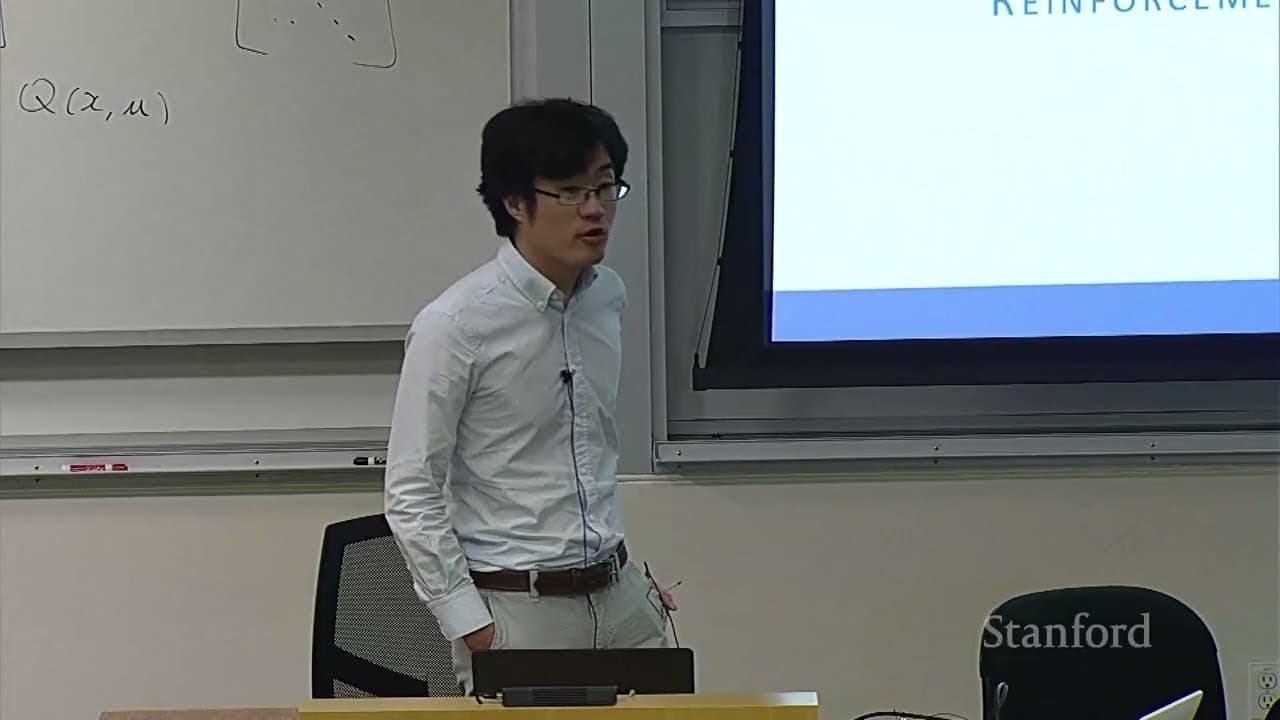
Stanford CS336의 Post Training RLVR 강의는 RLHF의 보상 모델 한계를 넘어, 검증 가능한 보상을 가진 수학·코딩형 문제에서 GRPO와 RLVR이 어떻게 thinking model의 핵심 학습 경로가 되는지를 설명한다.
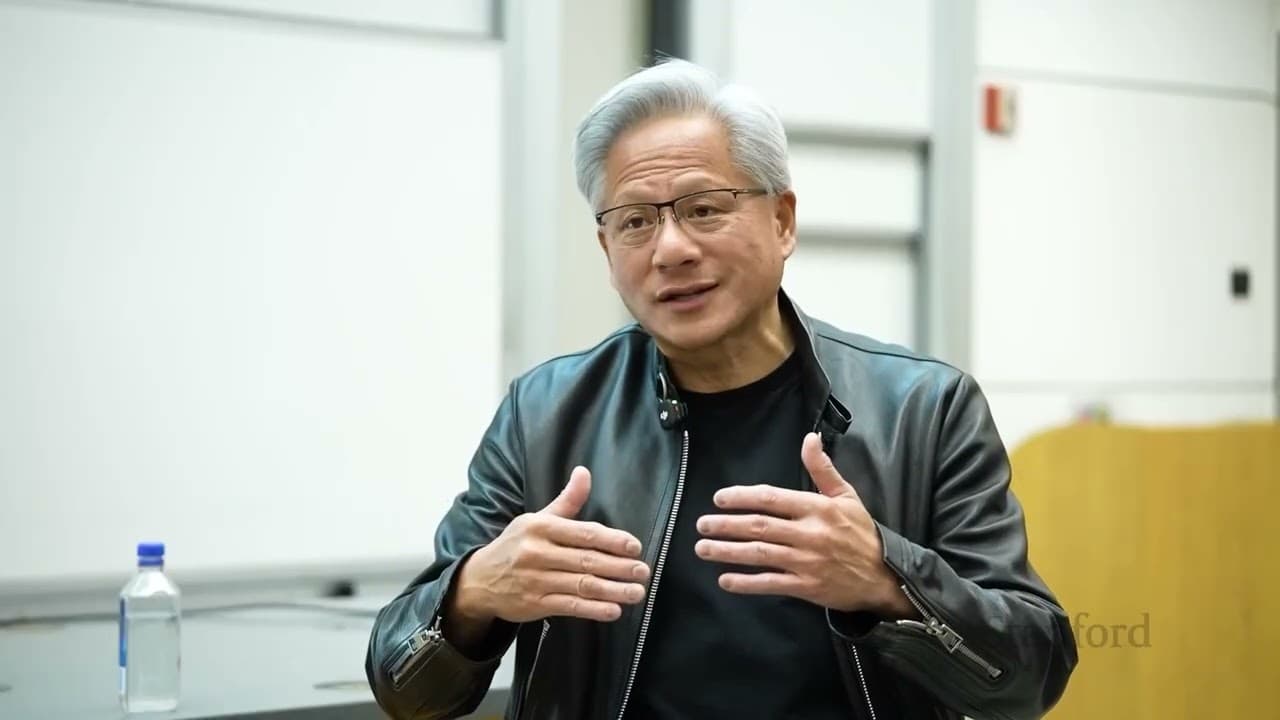
Stanford CS153에서 Jensen Huang은 Frontier Systems와 NVIDIA의 지능 뒤 컴퓨트 가 단순 GPU 성능 경쟁이 아니라, AI 시대의 소프트웨어·아키텍처·에너지·산업 전략 전체를 다시 설계하는 문제라고 설명한다.