이 태그와 연결된 문서를 한곳에서 모아보고, 함께 자주 등장하는 연관 태그까지 이어서 탐색할 수 있습니다.
연관 태그
총 262건 중 49-72건
Stratechery의 2026년 26주차 안내문은 AI와 바이브 코딩, 애플의 유럽 내 Siri AI 미출시, 메모리 칩과 중국, 다양한 팟캐스트·기사 콘텐츠를 여름 분위기의 주간 번들로 소개한다.
시에라의 제품 책임자 잭 르노 위딘은 최고의 AI 에이전트가 복잡한 다중 에이전트 구조보다 전체 맥락을 가진 단순한 단일 에이전트와 목적에 맞는 모델 조합에서 나온다고 설명한다.
이 글은 AI 코딩 도구를 넘어, 역할·기억·관측성을 공유하는 다중 에이전트가 소프트웨어 전달 전 과정을 조율하는 ‘에이전틱 엔지니어링’의 구조와 파일럿 결과를 설명한다.
WIRED 조사에 따르면 영국 브리스틀 지역 경찰과 시의회는 민감한 공공 데이터를 결합해 대규모 예측 치안·위험 점수 시스템을 만들었지만, 일부 모델은 신뢰성·투명성 문제로 폐기되거나 비판을 받았다.
이 글은 RAG의 단일 검색 지점 통제를 넘어, 에이전트형 AI가 스키마 탐색·SQL 생성·쿼리 실행·응답 합성까지 수행하는 전 과정에 세밀한 권한 통제를 적용하기 위한 AWS 기반 서버리스 데이터 메시 아키텍처를 설명한다.
Cloudflare Workflows는 다단계 작업 실패 시 각 단계 안에 선언한 보상 로직을 역순으로 실행하는 saga rollback을 도입해, 내구성 있는 워크플로에서 부분 완료 상태를 더 명확하게 되돌릴 수 있게 했다.
이 글은 Amazon SageMaker AI의 P6 B200 인스턴스와 NVIDIA Blackwell GPU를 활용해 대규모 모델 학습에서 배치 크기, 시퀀스 길이, 샤딩, 정밀도 형식, 활성화 체크포인팅을 어떻게 조정해야 하는지 설명한다.
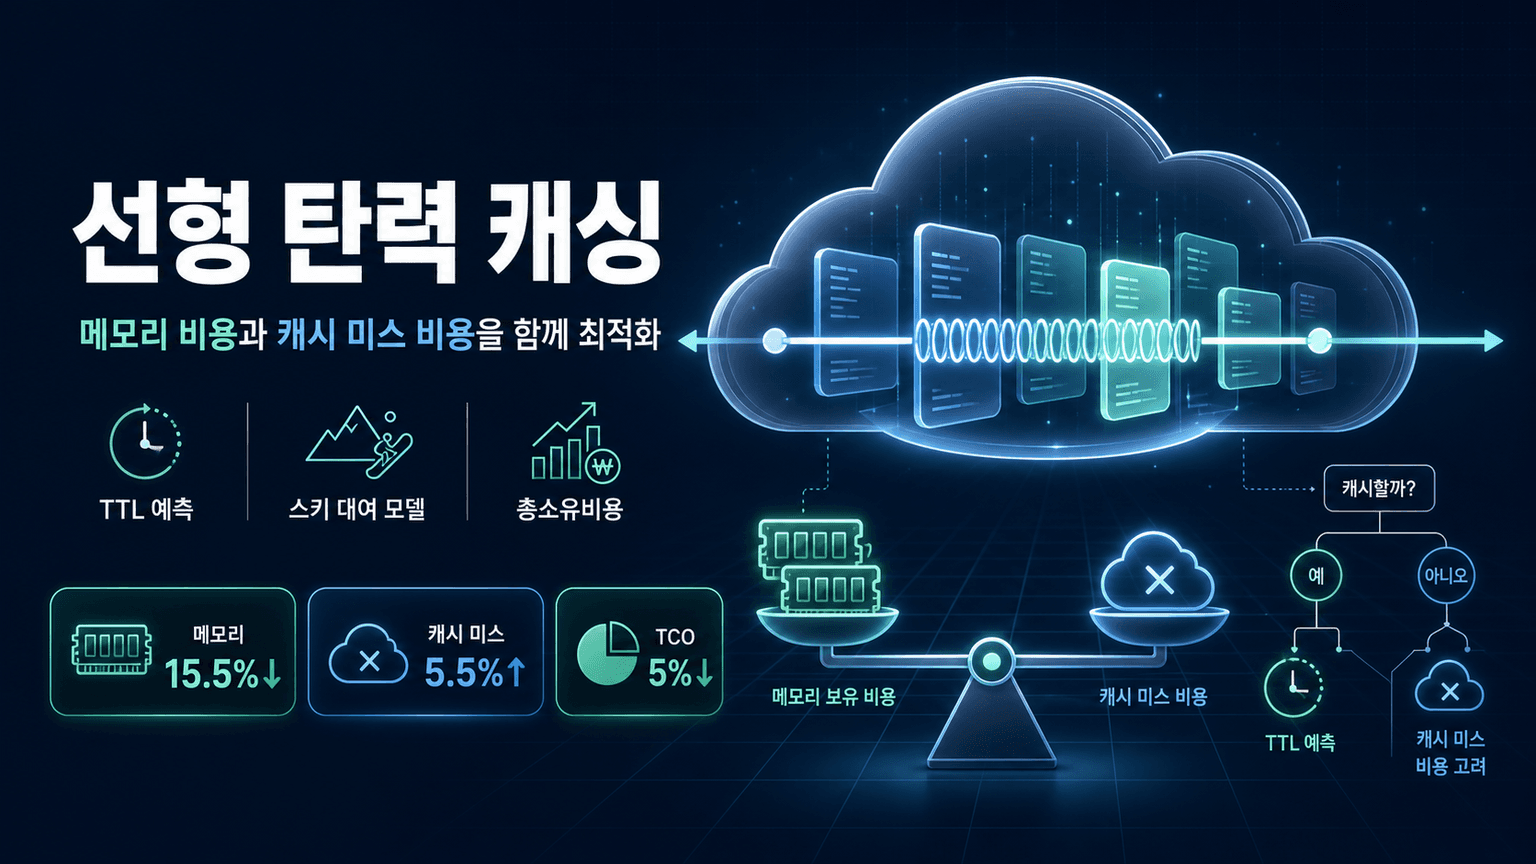
선형 탄력 캐싱은 캐시 메모리 비용과 캐시 미스 비용을 함께 최적화하기 위해 페이지 보존 시간을 스키 대여 문제로 모델링하고, 가벼운 학습 기반 TTL 예측으로 고정 크기 캐시보다 낮은 총소유비용을 달성하려는 접근이다.
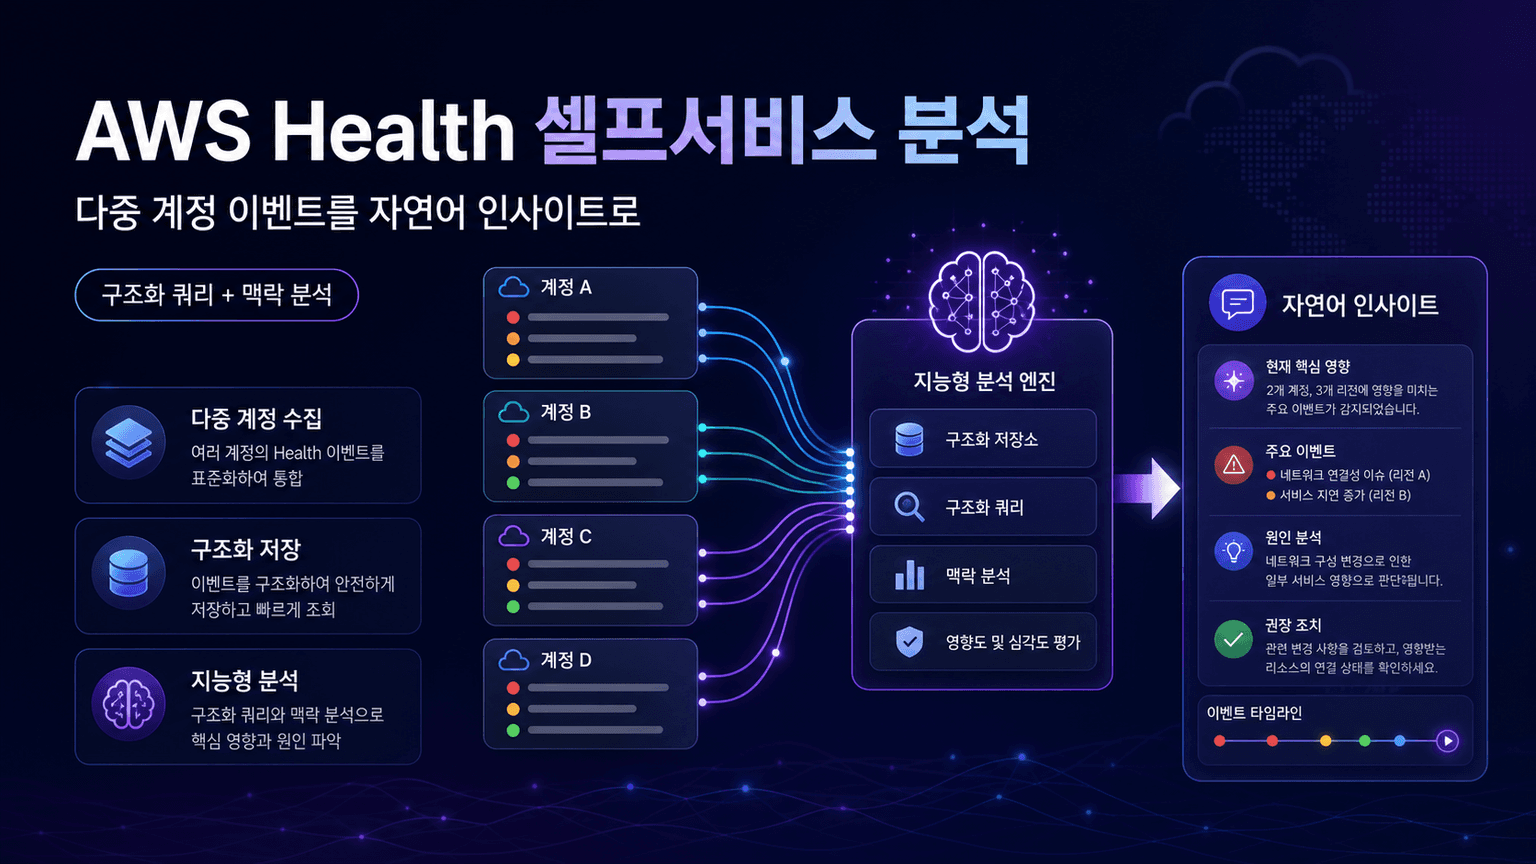
이 글은 여러 AWS 계정에 흩어진 AWS Health 이벤트를 Chaplin이라는 오픈소스 MCP 기반 AI 에이전트 시스템으로 수집·분류·분석해 운영팀이 자연어로 즉시 실행 가능한 인사이트를 얻는 방법을 설명합니다.
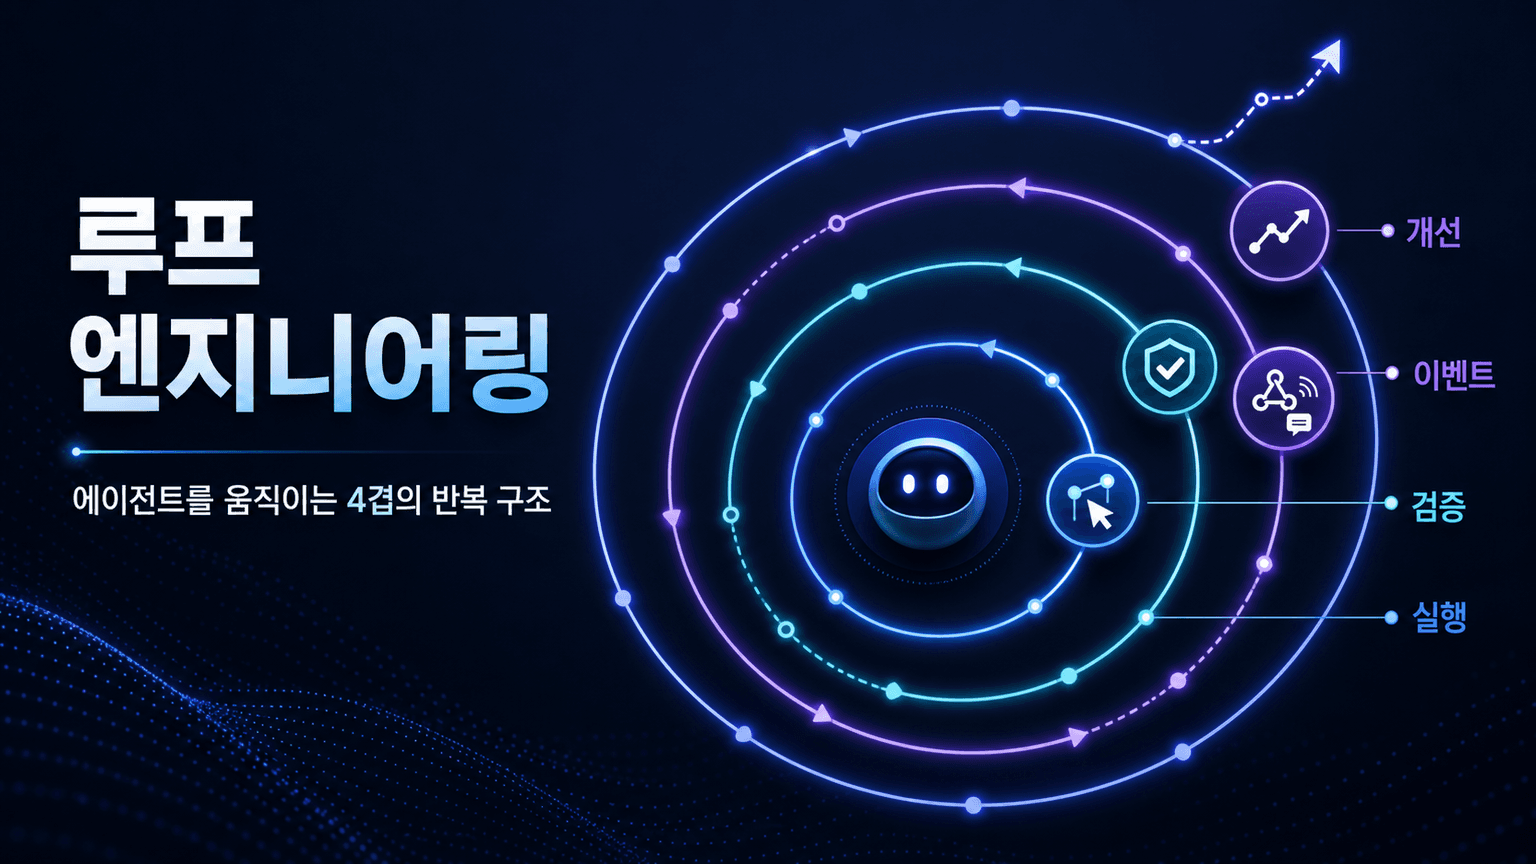
이 글은 에이전트를 잘 작동시키려면 단일 모델 성능보다 작업 실행, 검증, 이벤트 구동, 지속 개선을 겹겹이 설계하는 ‘루프 엔지니어링’이 핵심이라고 설명한다.
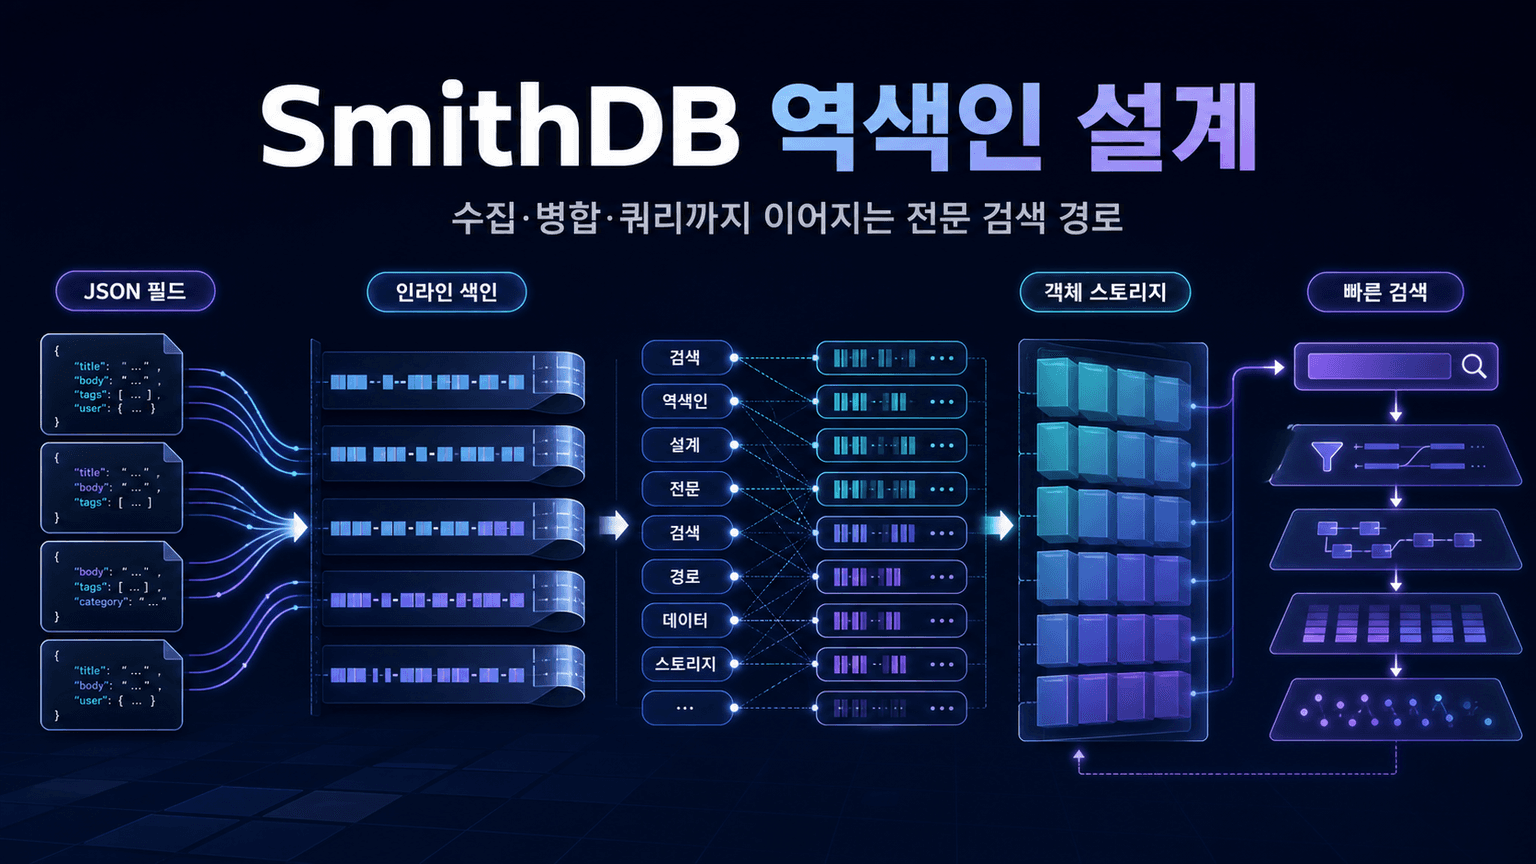
SmithDB는 수집 시점에 역색인을 함께 만들고, 객체 스토리지 친화적인 레이아웃·병합·쿼리 경로를 통해 대규모 실행 로그의 JSON 필드와 전문 검색을 빠르게 처리한다.
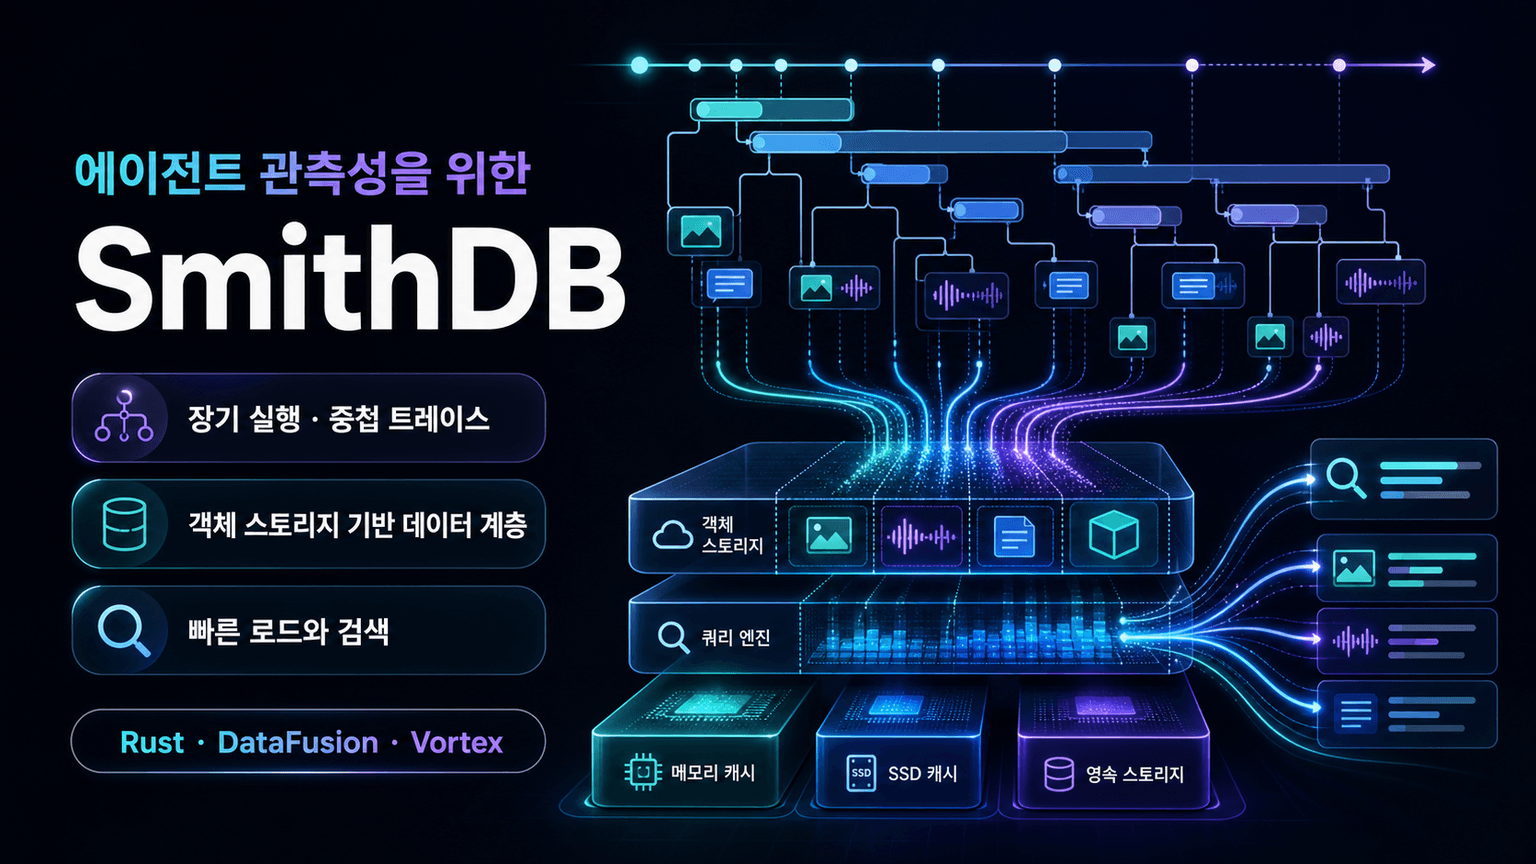
LangSmith는 장기 실행·중첩·멀티모달 에이전트 트레이스를 기존 관측성 저장소로 처리하기 어렵다고 보고, 이를 위해 Rust 기반의 객체 스토리지 지원 분산 데이터 계층인 SmithDB를 구축해 핵심 LangSmith 워크로드에 적용했다.
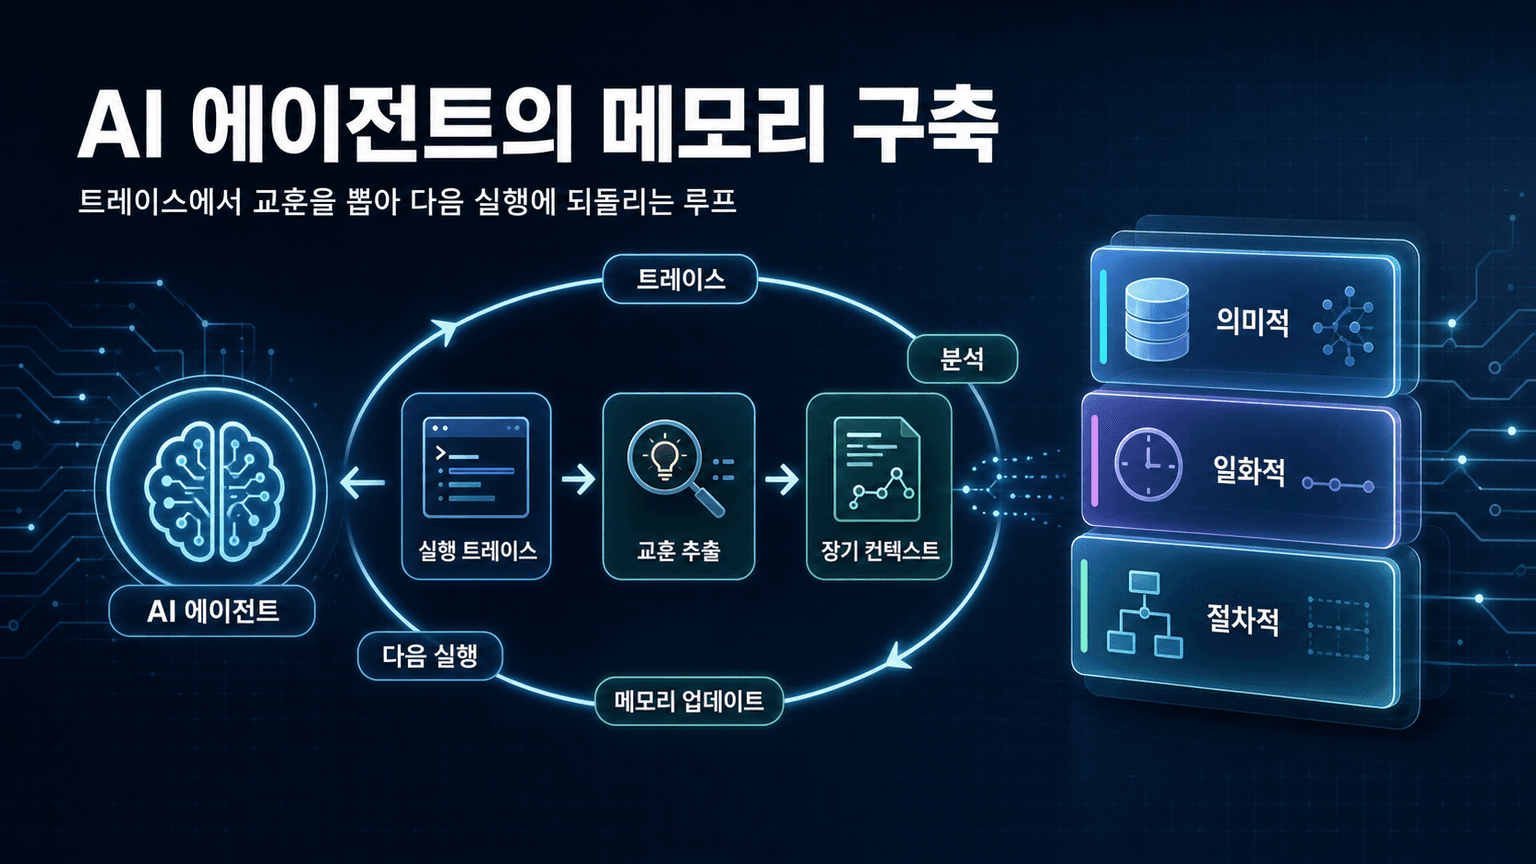
AI 에이전트의 메모리는 과거 실행에서 얻은 교훈을 장기 컨텍스트로 저장하고 다음 실행에 다시 읽혀 행동을 개선하게 만드는 순환 구조입니다.
NVIDIA NeMo AutoModel은 HuggingFace Transformers v5 위에 Expert Parallelism, DeepEP, TransformerEngine 커널을 얹어 MoE 모델 파인튜닝 처리량을 3.4~3.7배 높이고 GPU 메모리를 29~32% 줄이는 것을 목표로 한다.
이 글은 Snowflake semantic view를 공통 의미 계층으로 삼아 Cortex Analyst와 Amazon Quick Sight 대시보드가 동일한 비즈니스 정의를 사용하도록 연결하는 실습 절차를 설명합니다.
NVIDIA와 AWS는 EC2 G7, OpenSearch Serverless의 cuVS 기반 벡터 인덱싱, GB300 훈련 성능 인증을 통해 기업용 AI를 더 낮은 운영 부담으로 대규모 생산 환경에 배포할 수 있게 한다고 설명한다.
OpenAI는 Broadcom과 함께 만든 첫 맞춤형 추론 칩 ‘Jalapeño’를 공개하며, 추론 비용과 전력 효율을 낮추기 위한 인프라 내재화 전략을 강조했습니다.
AI의 다음 병목은 모델 크기가 아니라, 최신·관련성·신뢰성을 갖춘 웹 데이터를 실시간으로 발견하고 구조화해 공급하는 인프라 계층에 있다.
AI 붐으로 메모리 칩 부족이 심화되는 가운데, 미국 메모리 반도체 기업 마이크론은 급격한 매출·이익 증가와 긍정적 전망, 앤트로픽 공급 계약으로 수혜를 보고 있다.
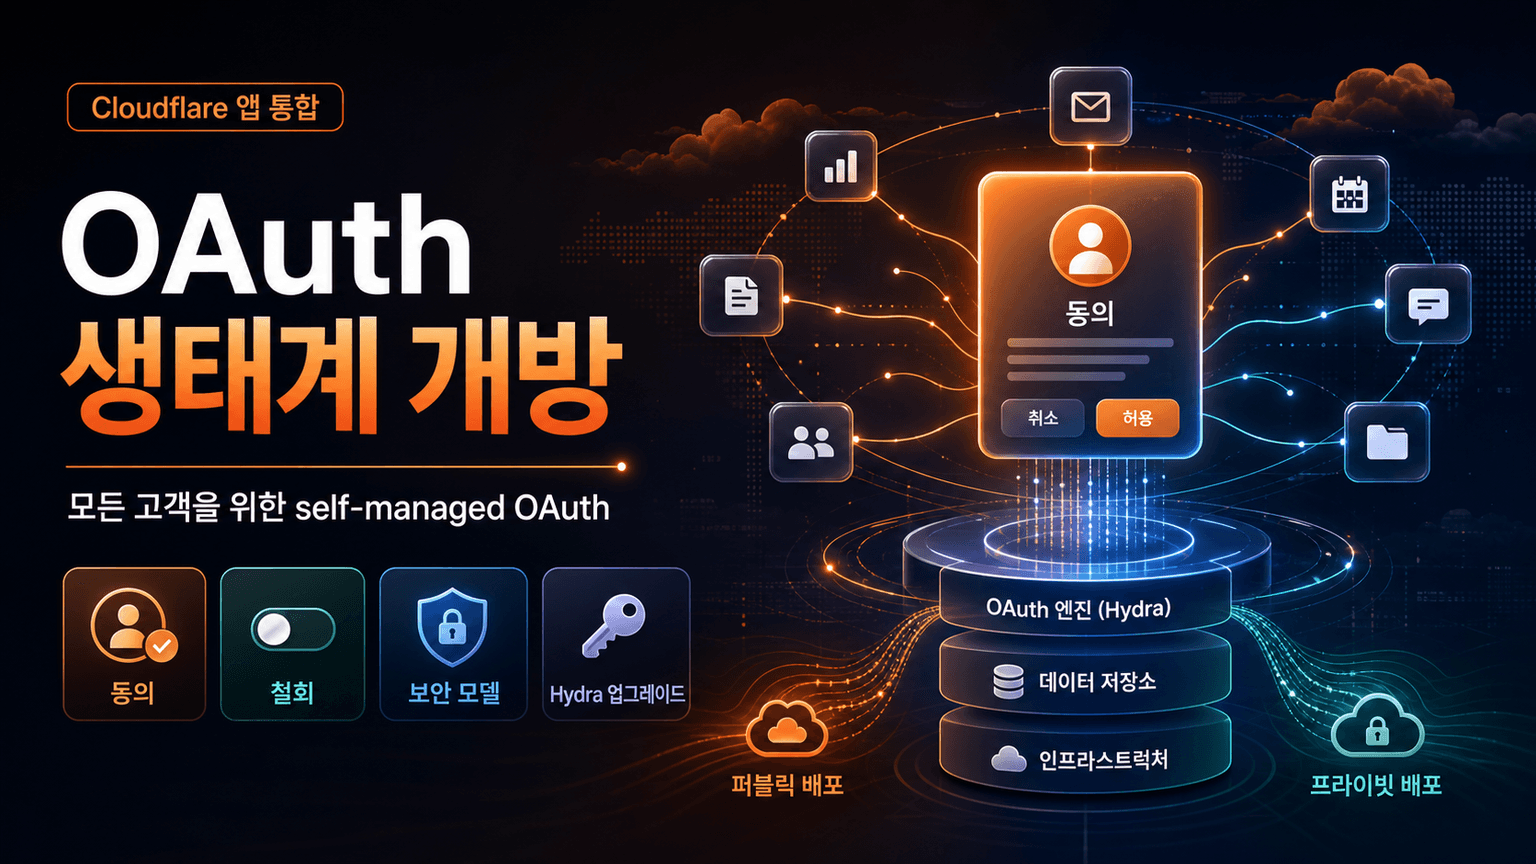
Cloudflare는 모든 고객이 자체 OAuth 애플리케이션을 만들 수 있도록 self managed OAuth를 공개하면서, 이를 뒷받침하기 위해 동의·철회·보안 모델과 Hydra 기반 OAuth 엔진을 대규모로 업그레이드했다.
CUGA는 에이전트 앱에서 반복되는 계획·실행·도구 호출·상태 관리·정책 처리를 하네스가 맡고, 개발자는 도구 목록과 프롬프트에 집중하도록 해 주는 IBM의 오픈소스 에이전트 하네스입니다.
교차 출처 저장소 API는 브라우저 AI 앱이 모델과 웹어셈블리 파일을 암호학적 해시로 식별해 출처가 달라도 하나의 검증된 사본을 공유하도록 제안함으로써, 캐시 격리로 인한 중복 다운로드와 저장 공간 낭비를 줄이려는 초기 단계의 웹 API다.
공개된 원문은 ‘중국 메모리 업체와 마이크로소프트의 중국 모델 활용 유인’을 제목과 짧은 문제 제기로 제시하지만, 실제 분석 본문은 Stratechery Plus 구독자 영역에 가려져 있다.
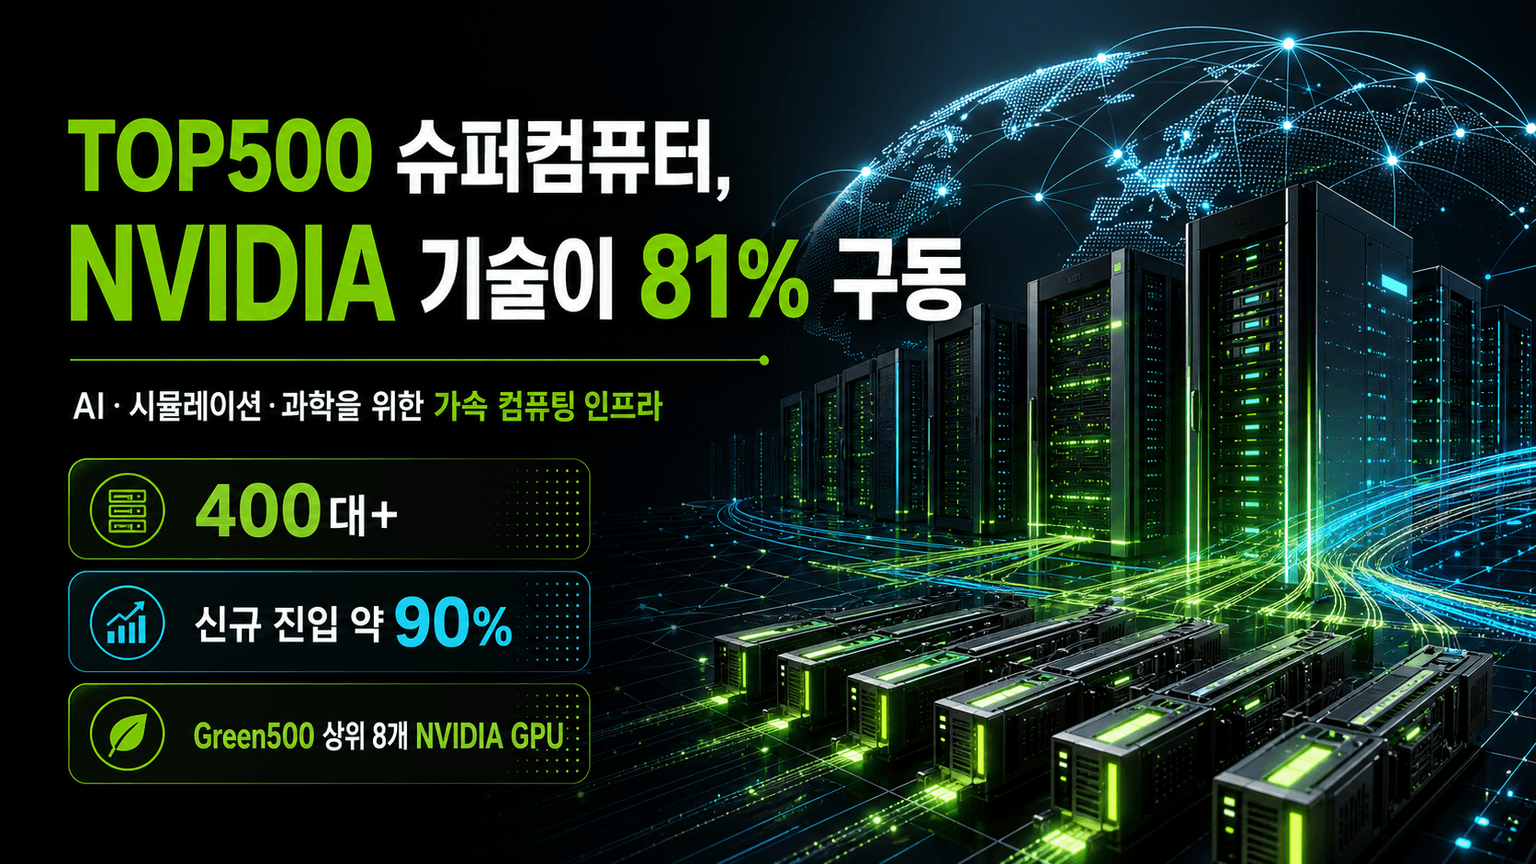
NVIDIA 기술은 최신 TOP500 슈퍼컴퓨터의 81%와 신규 진입 시스템의 약 90%를 차지하며, AI·시뮬레이션·과학을 위한 가속 컴퓨팅 인프라의 핵심 기반으로 확대되고 있다.