이 태그와 연결된 문서를 한곳에서 모아보고, 함께 자주 등장하는 연관 태그까지 이어서 탐색할 수 있습니다.
연관 태그
총 682건 중 265-288건
엔비디아는 베라 CPU를 차세대 CPU·GPU 설계용 EDA 워크플로에 배치하고, 케이던스·시놉시스와의 최적화를 통해 선택된 검증 작업에서 최대 1.5배의 성능 향상을 확인했다.
DGX Spark는 단순한 AI PC가 아니라, 데이터센터식 AI 서비스 구조를 로컬에서 개발·검증하고 상위 GPU 환경으로 확장하는 개인용 AI 개발자 플랫폼이다.
광통신 진영이 메모리를 노리는 이유는 광 연결로 연산과 메모리의 물리적 결합을 풀어 HBM 중심 구조를 외부 메모리 풀과 계층형 구조로 재편할 수 있기 때문이다.
Mad Money 07/24/26의 핵심은 신고가·내부자 매수·공매도 같은 신호를 즉시 매매 지시로 받아들이지 않고, 펀더멘털 조사와 분할매매 규율을 결합해 투자 후보를 선별하는 것이다.
구글 프로즌 V2 보도가 사실이라면, AI 반도체 판도는 엔비디아의 범용 GPU 독주에서 전력 효율을 앞세운 커스텀 칩과 혼합하는 구조로 이동할 가능성이 크다.
Stanford MS&E435가 제시한 AI 슈퍼사이클의 GPU 경제는 제한된 전력·메모리·반도체로 더 많은 토큰과 유용한 지능을 생산해 막대한 컴퓨트 투자를 회수하는 효율 경쟁이다.
엔비디아는 시그래프에서 신경 렌더링, 인공지능 물리, 세계 모델, 시뮬레이션과 에이전트 기반 창작 도구를 연결해 디지털 콘텐츠 제작과 물리 인공지능 개발의 범위를 넓혔다.
브리스톨 마이어스 스퀴브는 베라 루빈 기반의 두 번째 DGX 슈퍼팟을 구축해 전 세계 과학자에게 대규모 연산과 통합된 생물학 AI 도구를 제공하고, 신약 발굴 전 과정의 예측·학습·에이전트형 업무를 확장한다.
알파벳은 제미나이의 전력당 토큰 생성 효율을 높이기 위해 기존 인공지능 칩보다 6~10배 효율적일 수 있는 서버용 칩 ‘프로즌 v2’를 개발 중인 것으로 전해졌다.
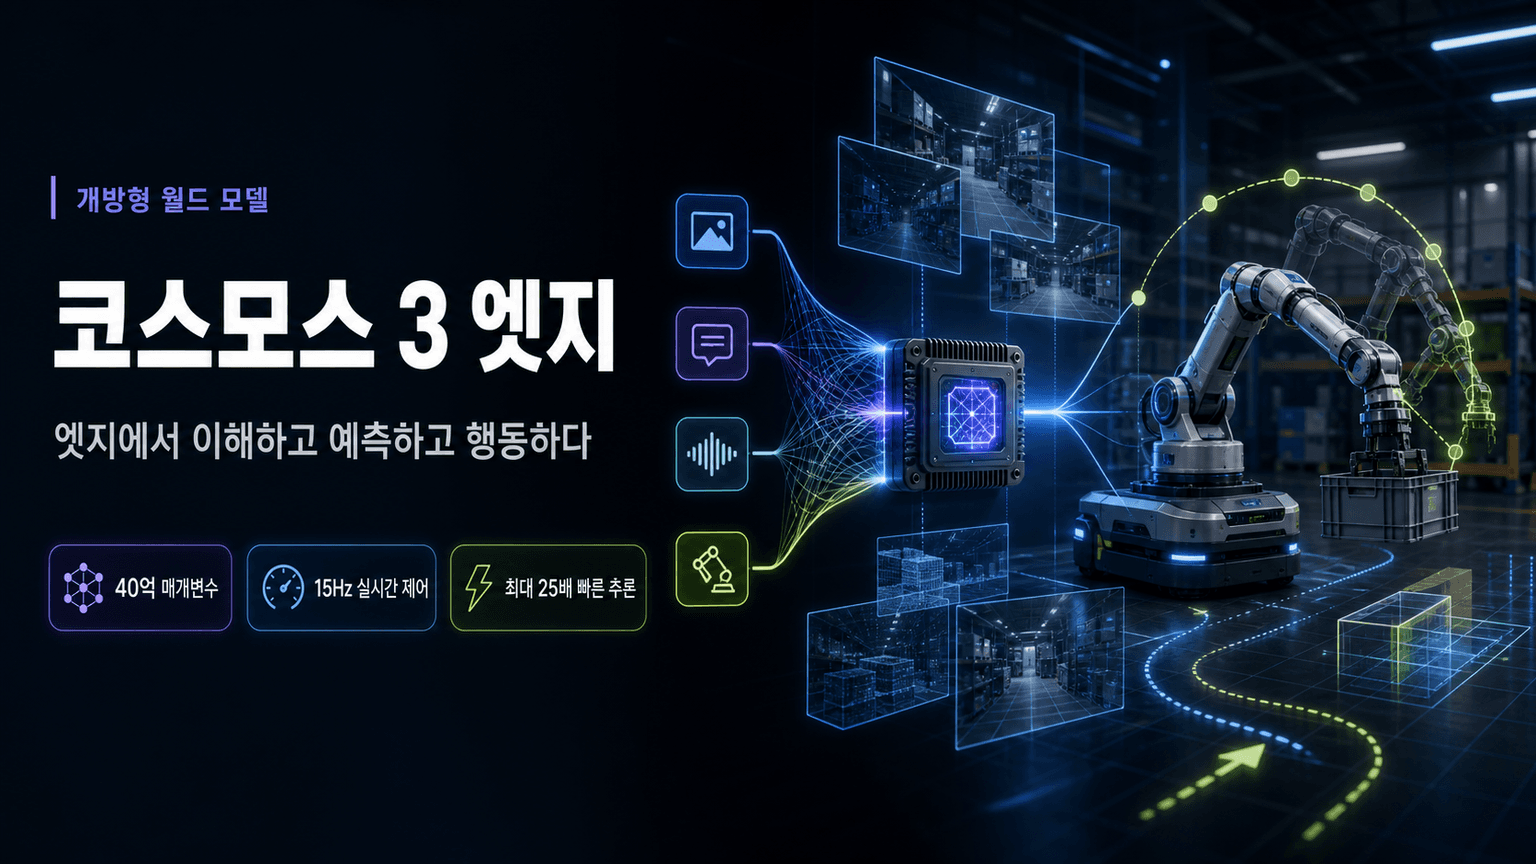
코스모스 3 엣지는 제한된 메모리의 엣지 장치에서 장면 이해, 미래 예측, 행동 생성을 실시간으로 수행하도록 설계된 40억 매개변수 개방형 월드 모델이다.
The Open Source AI Reality를 중심으로, 토큰 단가 하락만으로는 경제성을 판단할 수 없다. 모델마다 같은 업무에 필요한 토큰 수가 다르므로, 기업은 단가가 아니라 품질·속를 핵심 판단 포인트로 압축 정리한다.
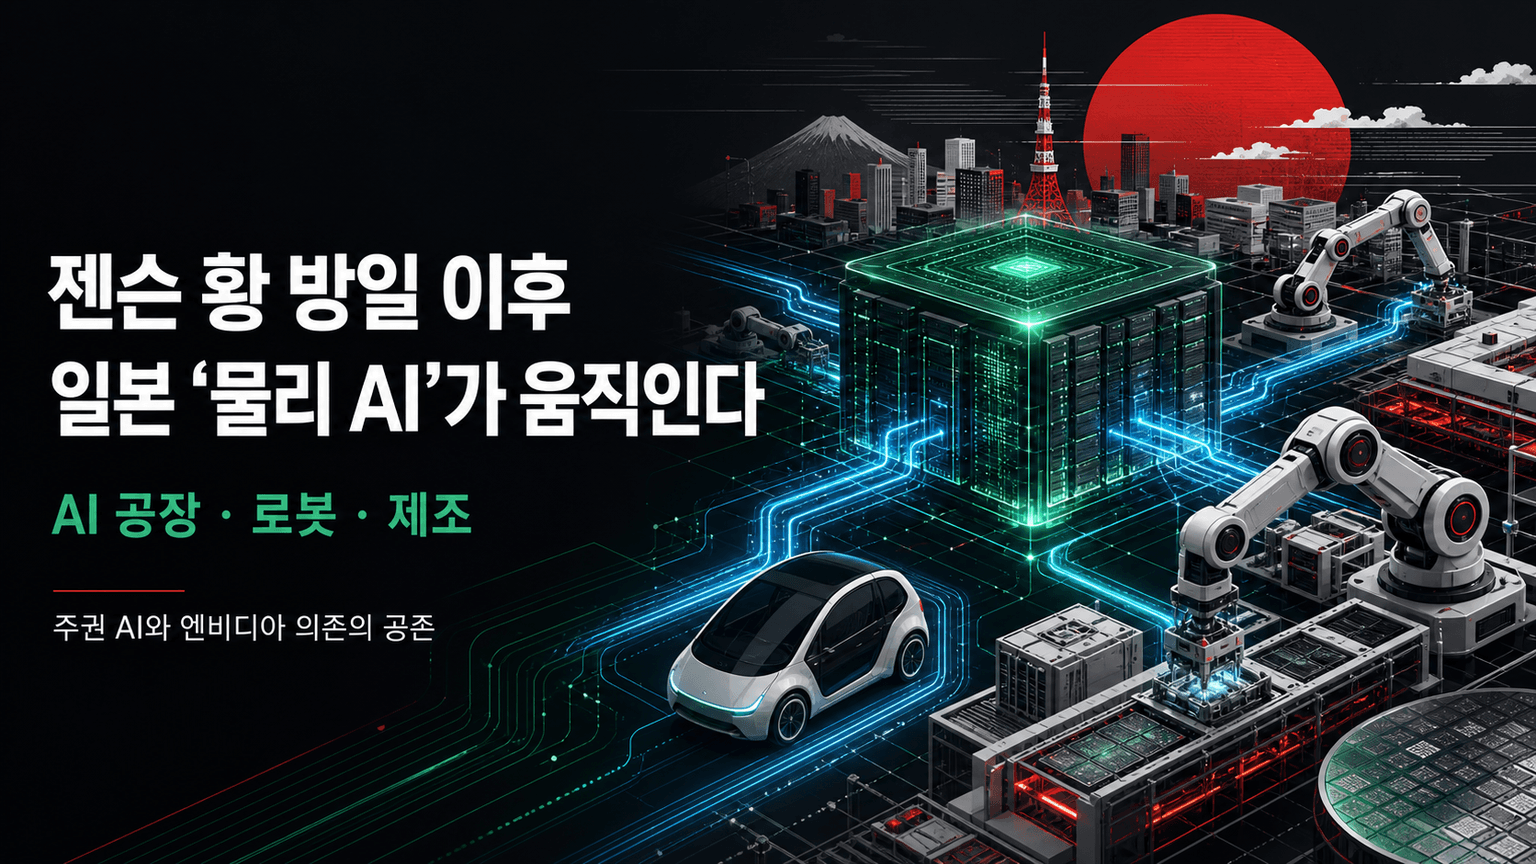
젠슨 황의 도쿄 방문은 일본의 국가 인공지능 인프라, 로봇 연합, 도요타 제조·차량 시스템을 엔비디아의 연산·모델·엣지 반도체와 연결하며 물리 인공지능을 일본 산업 전략의 중심에 놓았다.
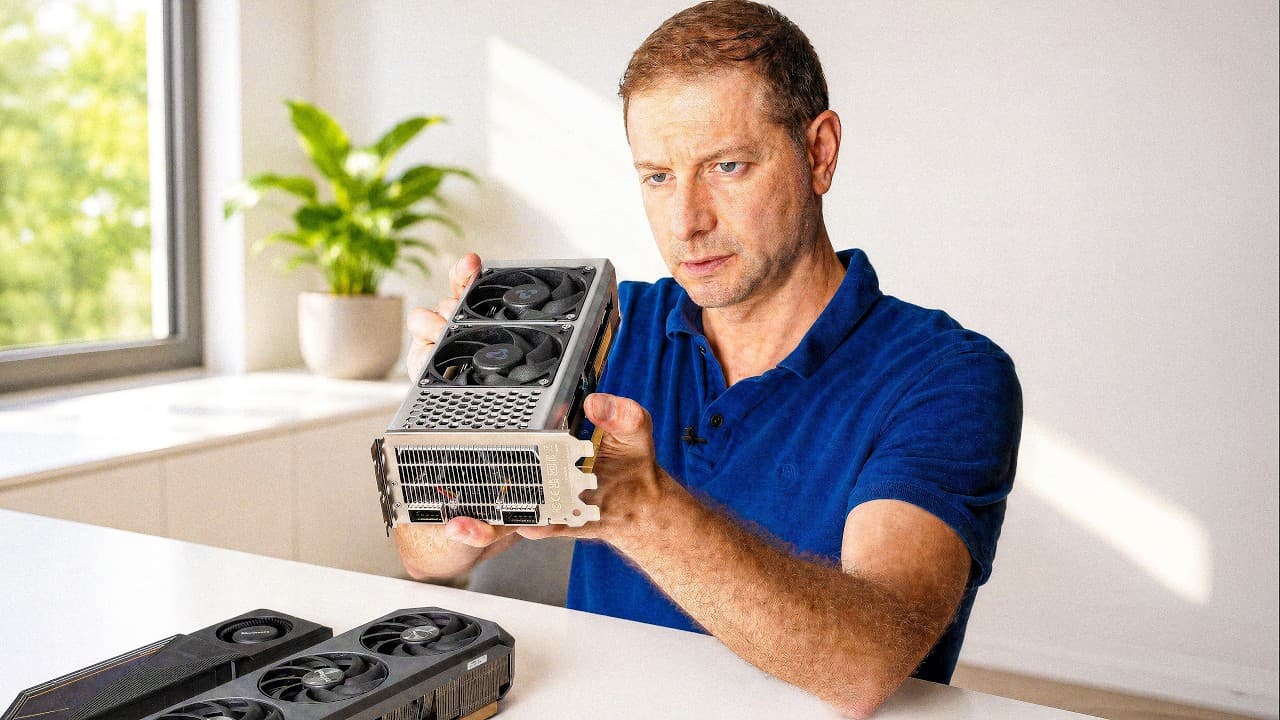
The Non NVIDIA AI Card Everyone’s Ignoring를 중심으로, Wormhole N300은 화면 출력용 GPU가 아니라 로컬 AI 추론 전용 가속기다. 2개 칩, 24GB 메모리, 약 1,400를 핵심 판단 포인트로 압축 정리한다.
NVIDIA Nemotron 3 Embed는 RTEB 전체 1위의 8B 모델과 효율 중심의 1B 변형을 함께 제공해 검색 정확도, 에이전트 토큰 비용, 배포 성능의 균형을 겨냥한 임베딩 모델 제품군이다.
AI 반도체 사이클은 끝난 것이 아니라 메모리 선행 이후 커스텀 칩·네트워킹·첨단 패키징·실시간 추론으로 주인공이 바뀔 수 있는 자금 순환 국면입니다.
NVIDIA는 Nemotron 같은 오픈 모델이 기업과 국가가 자체 데이터·업무 기준에 맞춰 AI를 통제하고 맞춤화하며, 폐쇄형 모델과 조합해 비용과 성능을 최적화할 수 있게 한다고 설명한다.
아마존 세이지메이커 AI 스튜디오의 새 추론 추천 사용자 인터페이스는 생성형 인공지능 모델의 워크로드 설정부터 실제 장비 벤치마크, 결과 비교, 운영 엔드포인트 배포까지를 코드 없이 연결합니다.
긴 프롬프트의 사전 채우기와 토큰 생성을 별도 GPU 풀로 분리하고 KV 캐시를 EFA 기반 RDMA로 전달해, 대규모 LLM 스트리밍 추론의 첫 토큰 시간과 토큰 간 지연을 독립적으로 최적화하는 방법을 설명한다.
Amazon SageMaker AI의 서버리스 모델 맞춤화를 이용하면 인프라를 직접 관리하지 않고도 NVIDIA Nemotron 3 Nano와 Super를 SFT, RLVR, RLAIF 방식으로 기업 데이터와 업무에 특화할 수 있다.
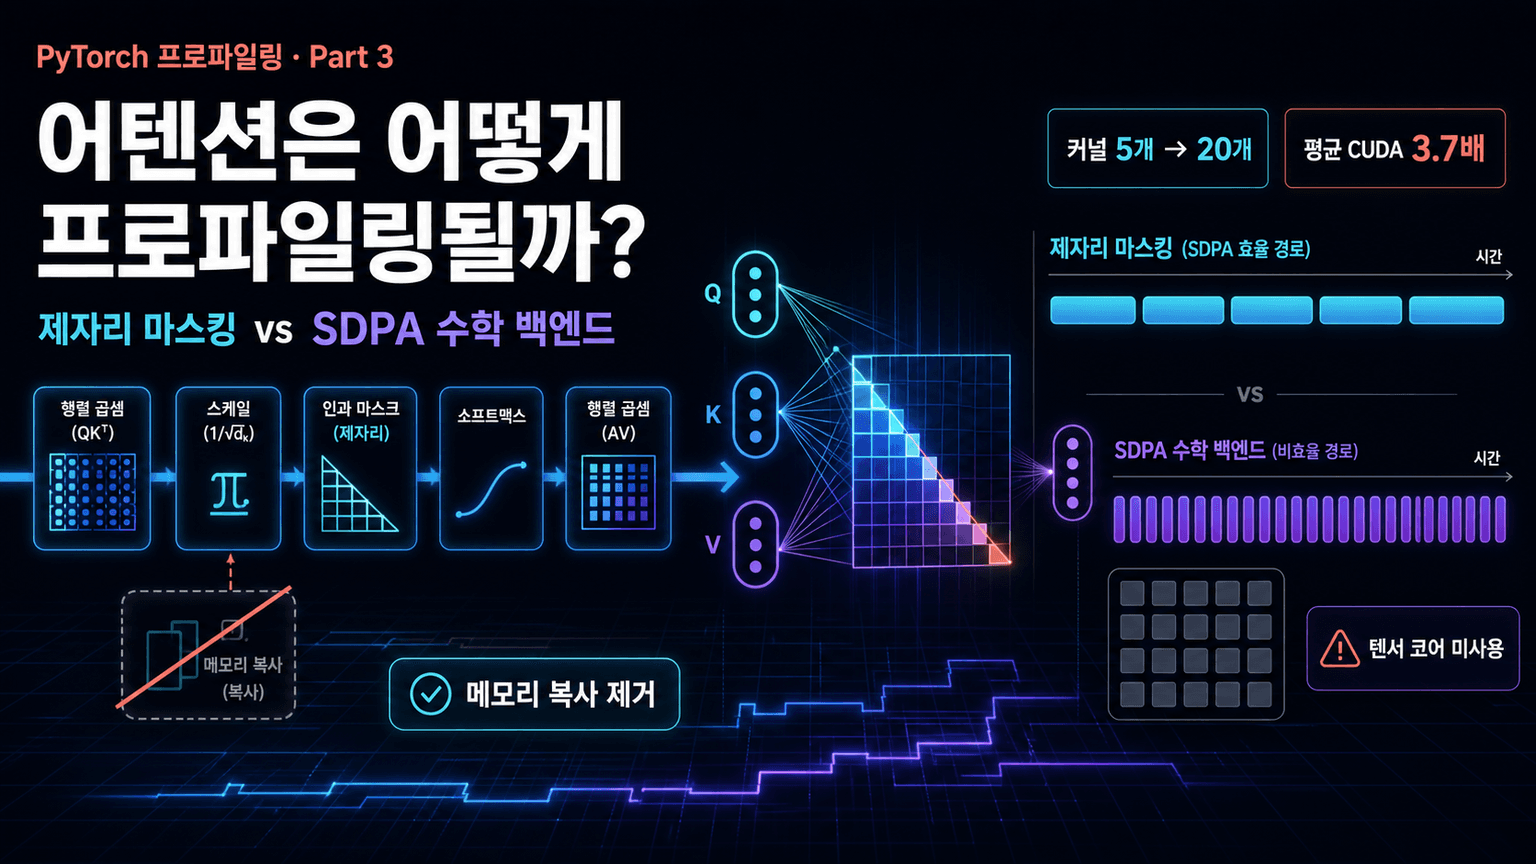
파이토치 프로파일러로 어텐션 구현을 비교한 결과, 제자리 마스킹은 불필요한 메모리 복사를 제거했지만 SDPA 수학 백엔드는 텐서 코어 미사용과 매 호출 마스크 생성으로 인해 단순 구현보다 3.7배 느렸다.
SK하이닉스는 AI용 고대역폭 메모리 수요를 바탕으로 미국 증시에서 외국 기업 사상 최대인 265억 달러를 조달했으며, 미국 정부는 한국에 집중된 메모리 반도체 생산시설의 미국 이전·확대를 요구하고 있다.
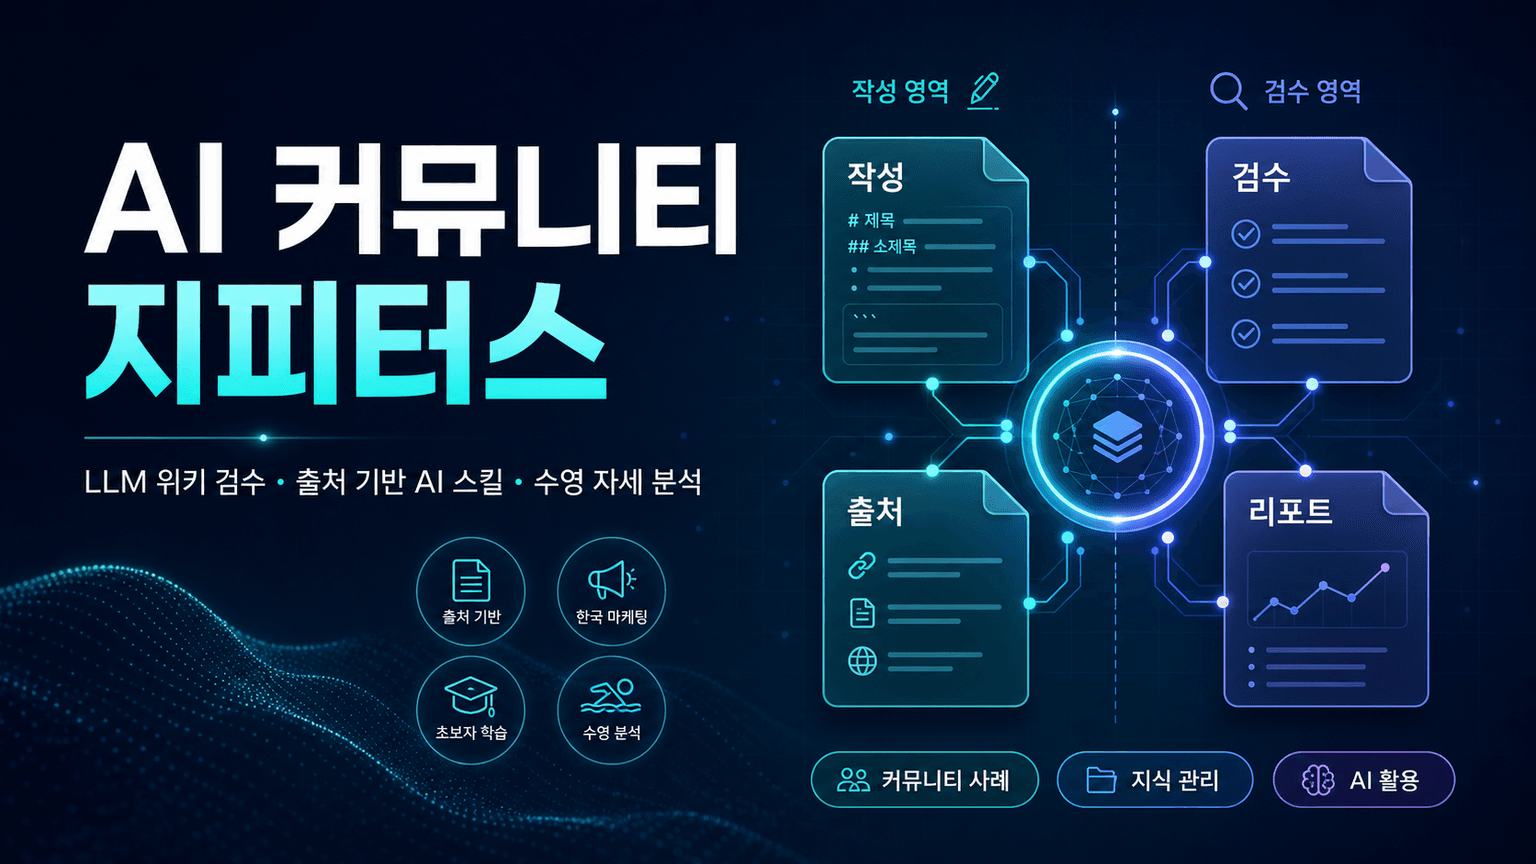
지피터스 커뮤니티 글들은 LLM 위키 운영의 검수 구조, 한국 마케팅용 출처 기반 AI 스킬, AI 입문 소감, Gemini 기반 수영 자세 교정기 제작 사례를 공유한다.
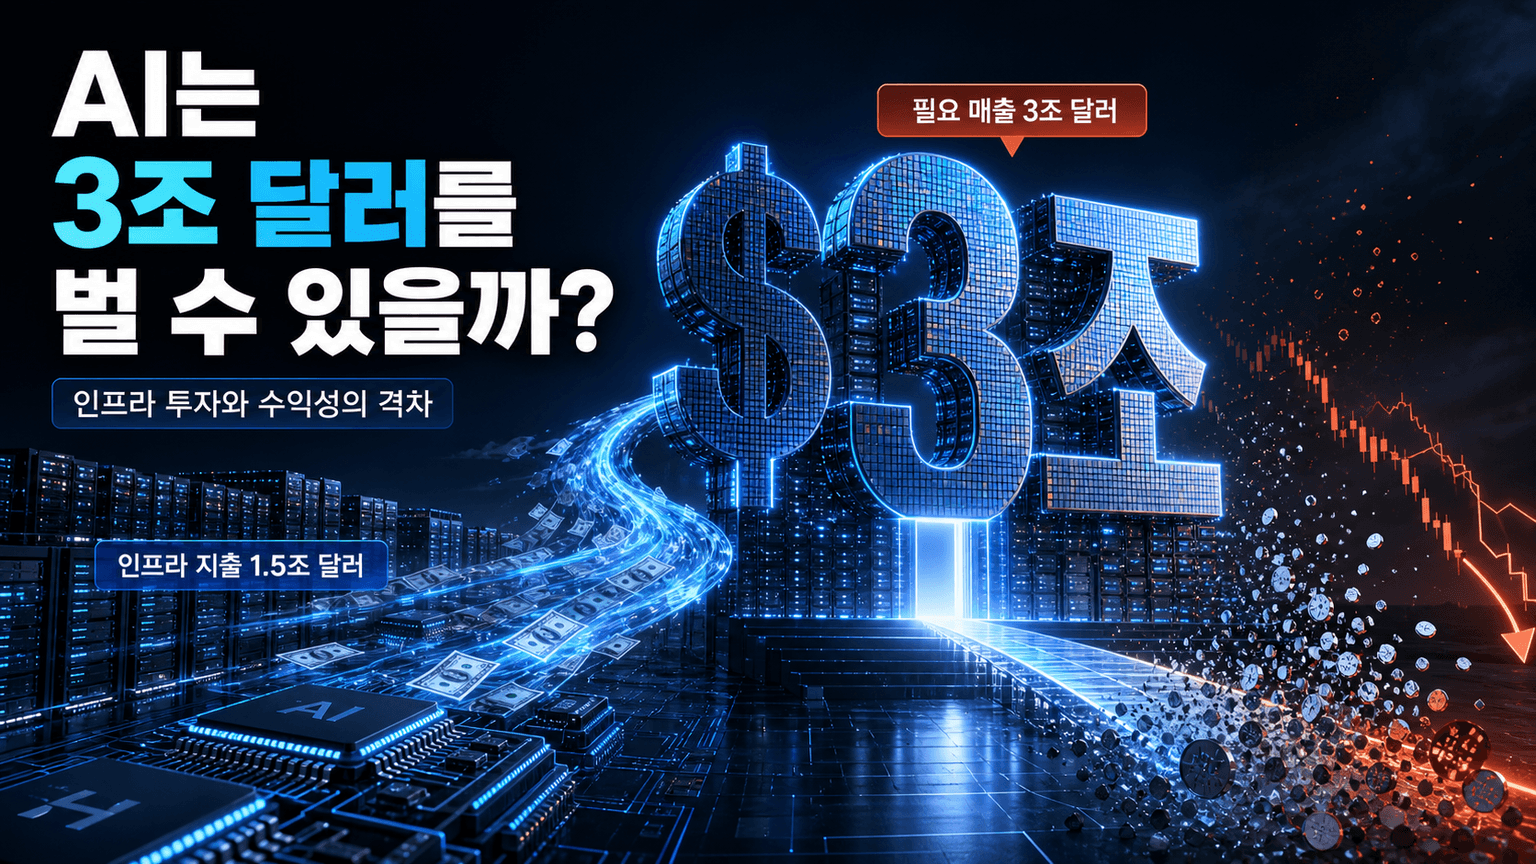
AI 인프라에 투입된 막대한 자본을 정당화하려면 업계가 3조 달러를 벌어야 하지만, 저가 모델 확산과 토큰 가격 하락이 투자금 회수와 거시경제의 위험 요인으로 떠오르고 있다.
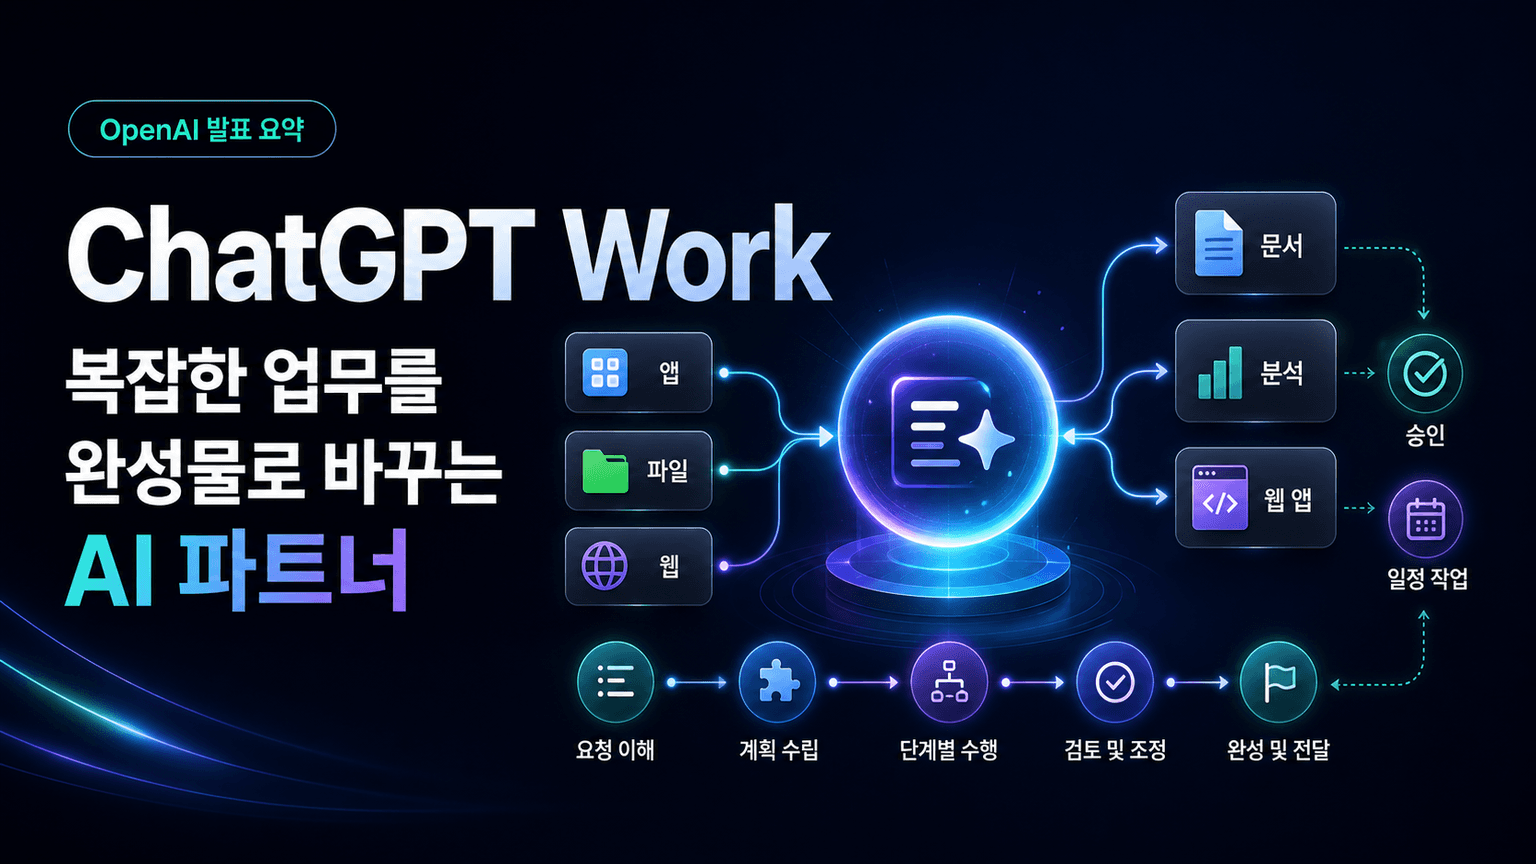
OpenAI는 앱·파일·웹을 넘나들며 복잡한 프로젝트를 단계별로 수행하고 문서·분석·웹 앱 같은 완성물을 만드는 에이전트형 기능인 ChatGPT Work를 공개했습니다.