이 작성자와 연결된 문서를 한곳에서 모아보고, 관련 태그를 따라 같은 맥락의 문서를 이어서 탐색할 수 있습니다.
자주 함께 등장한 태그
총 16건 중 1-16건
많은 VRAM을 갖춘 AI 머신도 여러 코딩 에이전트를 동시에 돌리려면 강한 CPU가 필요하며, 실제 성능은 모델 서버의 대기열까지 함께 살펴야 한다.
I Gave Local AI and the Cloud the Exact Same Job를 중심으로, 로컬 환경은 512GB 통합 메모리를 갖춘 Mac Studio 4대를 RDMA와 Thunderbolt 5 메시로 연결해 대형 Ki를 핵심 판단 포인트로 압축 정리한다.
RTX Pro 6000을 Strix Halo 미니 PC에 연결한 결과, Vulkan과 모델 레이어 분할로 AMD·Nvidia 메모리를 함께 사용해 단일 GPU에 담기지 않는 122B 모델까지 실용적인 속도로 구동할 수 있었다.
M5 Max는 개발 생산성과 대용량 로컬 AI에서 Razer Blade 18을 크게 앞서며, Blade 18의 진짜 경쟁력은 RTX 5090 메모리에 들어가는 중형 AI 모델과 Windows 전용 GPU 작업에 있다.
What Computer Should You Buy for Local AI를 중심으로, 모델 크기와 양자화, VRAM 용량, 속도 우선순위, 예산, 폼팩터가 모두 선택을 바꾸기 때문에 모든 사용자에게 통하는 로컬 AI를 핵심 판단 포인트로 압축 정리한다.
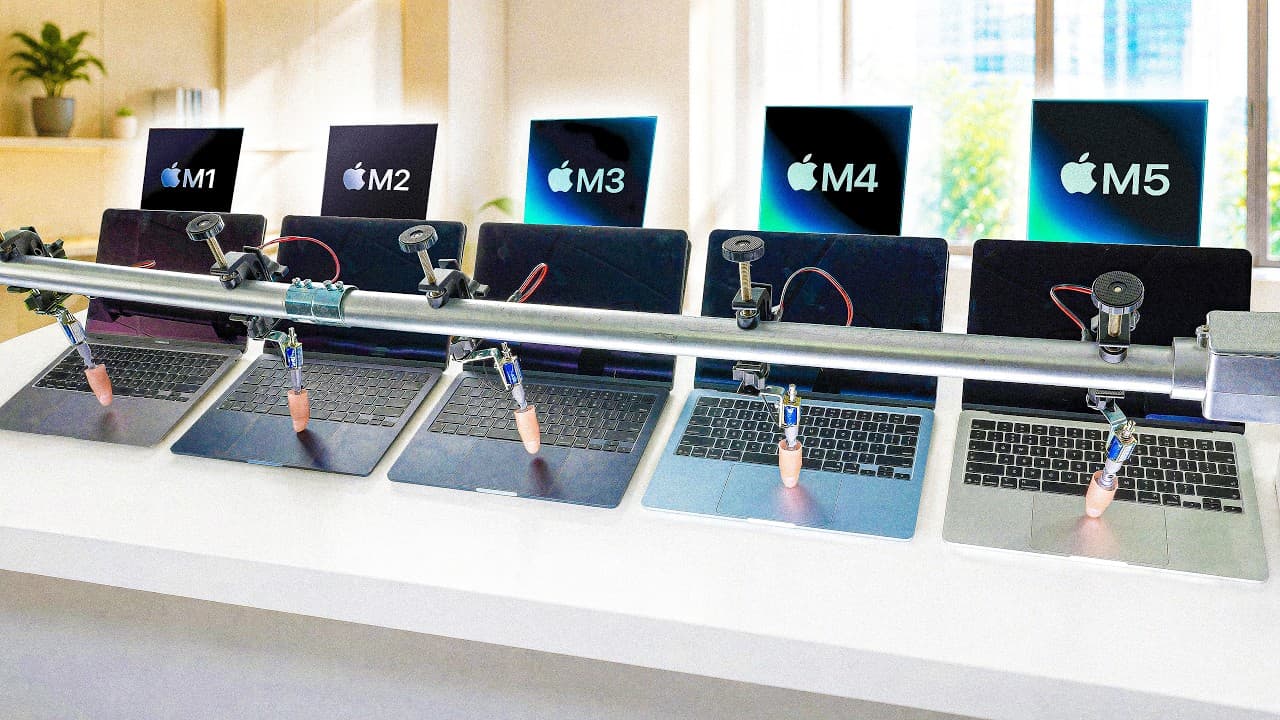
M5 MacBook Air는 외형보다 SSD·외부 디스플레이·로컬 AI 성능이 크게 달라졌지만, M4 사용자에게는 가격 차이를 감수할 만큼 결정적인 업그레이드는 아니다.
두 대의 Ryzen AI Halo는 10GbE 기반 모델 분할로 400B급 AI 모델을 실제 구동할 수 있지만, 실용성은 메모리 용량보다 추론 방식과 동시 요청 처리 성능에 좌우된다.
The Non NVIDIA AI Card Everyone’s Ignoring를 중심으로, Wormhole N300은 화면 출력용 GPU가 아니라 로컬 AI 추론 전용 가속기다. 2개 칩, 24GB 메모리, 약 1,400를 핵심 판단 포인트로 압축 정리한다.
Local AI 성능은 OS 선택만으로 끝나지 않으며, Windows·WSL·Linux 차이보다 메모리 채널 구성과 GPU 활용 경로가 실제 체감 성능을 크게 좌우한다.
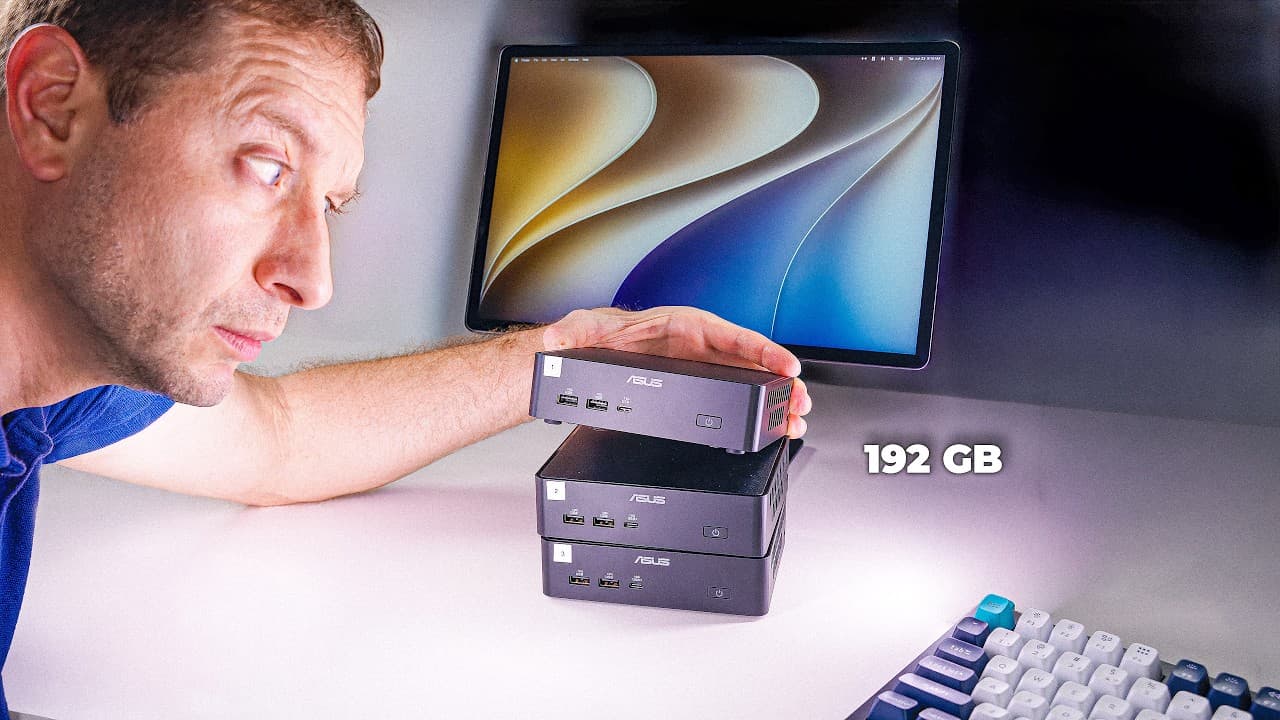
3 New PCs와 One Giant AI Model 실험의 결론은 “여러 대를 묶으면 더 빠르다”가 아니라, 큰 모델을 담는 용량 확장은 가능하지만 속도는 메모리 대역폭과 네트워크·분할 방식에 막힌다는 것이다.
I Thought Local AI Video Was Good를 중심으로, 로컬 AI 비디오는 개인 컴퓨터에서 비공개·무료로 영상과 음성 클립을 만들 수 있을 만큼 발전했지만, 현재 사례에서는 길이와 일관를 핵심 판단 포인트로 압축 정리한다.
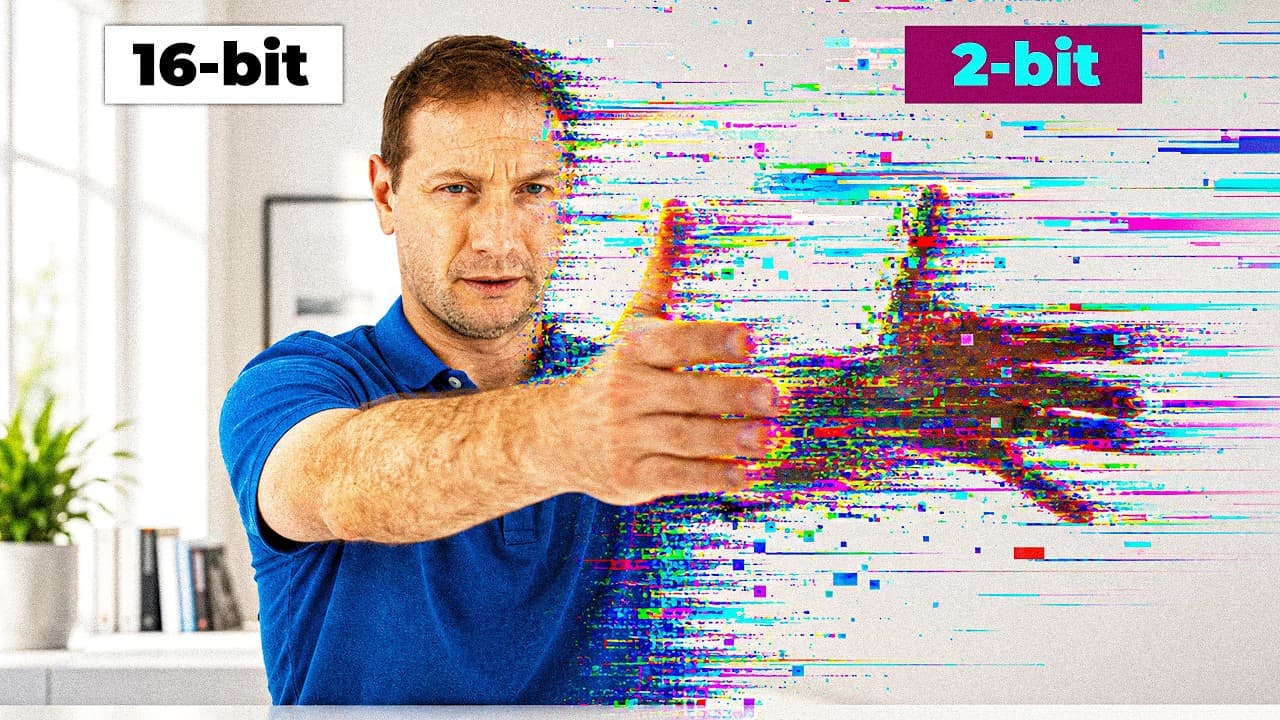
AI Video Model을 과도하게 압축하면 단순히 해상도가 낮아지는 수준이 아니라, 포맷 선택·인물 정체성·오디오 신뢰도까지 함께 무너지며 실전 기준은 대체로 Q4와 Q8 계열의 균형점에 있다.
Strix 후속 Gorgon Point 기반 SER 10은 M4 Pro를 전면 추월했다기보다, JavaScript 도구chain·멀티코어·로컬 AI 일부 영역에서 격차를 크게 좁힌 고용량 RAM mini PC 선택지다.
LLM Hoarding 문제의 핵심은 모델 자체보다 중복 저장·불투명한 캐시·경로 관리이며, Model Shelf와 외장 NVMe 저장소는 로컬 AI 모델 라이브러리를 정리하는 해법으로 제시된다.
Everything looks fine at 4 bit처럼 4 bit 양자화 모델은 겉보기 출력이 멀쩡해도, 벤치마크가 잘 포착하지 못하는 사실 오류와 국소적 능력 붕괴를 숨길 수 있다.
M5 Max는 로컬 AI에서 단순 토큰 생성 성능 경쟁이 아니라 프롬프트 처리와 모델 로딩 병목을 크게 줄인 세대이며, 128GB 안에서 끝나는 워크로드라면 일부 구간에서는 M3 Ultra급 데스크톱보다 더 매력적인 선택지가 될 수 있다.