I Waited Two Years for This Mini PC…Then I Tested It
Quick Summary
I Waited Two Years for This Mini PC…Then I Tested It를 중심으로, 영상의 Q10은 Snapdragon X2 Elite 18코어, 메모리 32GB, 저장장치 512GB 구성이다. 취소된 개발 키트를 핵심 판단 포인트로 압축 정리한다.
영상 보기
클릭 전까지는 가벼운 미리보기만 먼저 불러옵니다.
🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 결론
I Waited Two Years for This Mini PC…Then I Tested It를 중심으로, 영상의 Q10은 Snapdragon X2 Elite 18코어, 메모리 32GB, 저장장치 512GB 구성이다. 취소된 개발 키트를 핵심 판단 포인트로 압축 정리한다.
📌 핵심 요점
- 영상의 Q10은 Snapdragon X2 Elite 18코어, 메모리 32GB, 저장장치 512GB 구성이다. 취소된 개발 키트 이후 실제 구매 가능한 Snapdragon 데스크톱이라는 점이 출발점이다.
- CPU 실측은 경쟁력이 있었다. Speedometer는 48.6으로 M4 Mac Mini의 47.8을 소폭 앞섰고, ARM 네이티브 Python 테스트는 21.76초로 비교 기기 중 가장 빨랐다. .NET 빌드는 77초로 M4 Pro의 66초에는 못 미쳤다.
- 실행 환경이 성능을 크게 바꿨다. Python은 x64 실행 시 50.43초였지만 ARM 버전에서 21.76초로 줄었다. 웹 도구 테스트는 x64 Node 8.15회/초, ARM Node 11.8회/초, Chrome 49.89회/초였으며, 마지막 수치는 실행 환경이 달라 직접 비교에 주의해야 한다.
- 로컬 AI에서는 하드웨어 사양과 실제 활용 사이의 간극이 컸다. 발표자는 Hexagon NPU 구동에 실패했고, OpenCL GPU가 사용할 수 있는 메모리는 약 15GB였다. 시험한 모델에서는 CPU 생성 속도가 GPU보다 빨랐다.
- 구매 판단은 용도에 따라 갈린다. 발표자는 ARM 호환성이 확보된 Windows 개발에는 긍정적이지만, 작은 모델의 AI 추론에서는 더 저렴한 기본형 Mac Mini가 유리하다며 AI 목적 구매는 권하지 않았다.
🧩 배경과 문제 정의
발표자는 약 2년 전 Snapdragon X Elite 개발 키트를 주문했지만 제품이 취소되는 경험을 했다. 이후 기다리던 상용 Snapdragon 미니 PC가 등장하자, 합성 벤치마크의 높은 점수가 실제 개발 작업과 로컬 AI에서도 이어지는지 확인한다.
검증의 중심은 Windows ARM의 실용성이다. Q10을 기존 개발 키트, AMD·Intel 미니 PC, M4 계열 Mac Mini 등과 비교하면서 CPU 성능뿐 아니라 ARM 네이티브 실행, 전력과 소음, AI 메모리 접근 및 백엔드 지원을 살핀다. 영상 중간에는 AI 서비스 홍보 구간도 포함된다.
🕒 시간순 섹션별 상세정리
1. 취소된 개발 키트 이후 등장한 상용 미니 PC
- 발표자는 취소된 Snapdragon X Elite 개발 키트를 소개하고, 실제 구매 가능한 Windows ARM 데스크톱이 Mac Mini의 대안이 될지 질문한다. [00:36]
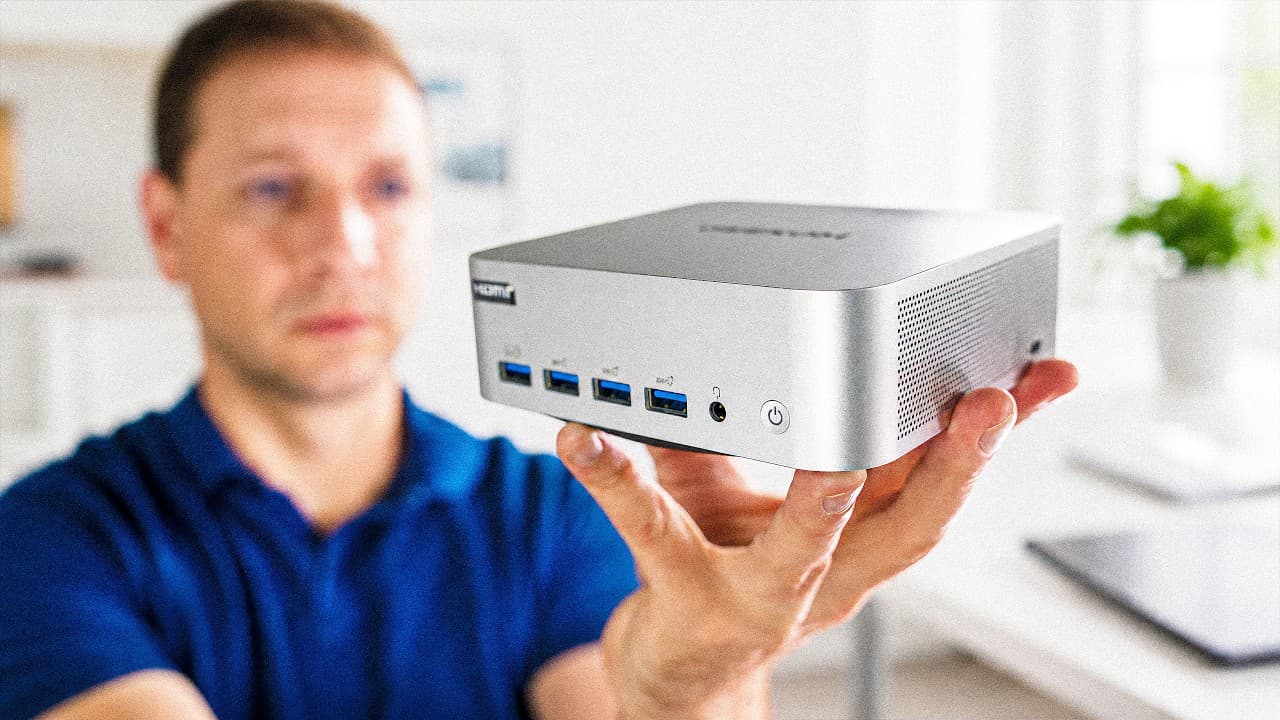
- Q10의 구성은 X2 Elite, 메모리 32GB, 저장장치 512GB다. USB4 포트 3개, 2.5GbE, Wi-Fi 7과 외장 180W 전원 어댑터를 보여준다. [01:14]
2. X2 Elite의 사양과 개발 환경
- 시험 칩은 18코어 구성으로 최대 부스트 4.7GHz이며, 발표자가 구분한 5GHz Extreme 모델은 아니다. 메모리 대역폭은 152GB/s로 묶인다. [02:20]
- Adreno X290 GPU와 80 TOPS Hexagon NPU를 보여준다. GPU의 전성비 개선 수치는 Qualcomm의 주장으로 드러난다. [02:44]
- Visual Studio, .NET, Node, Python의 ARM64 네이티브 지원을 언급하며 실제 속도 검증으로 논점을 옮긴다. [02:54]
3. 여러 AI 모델을 묶는 서비스 홍보
- 발표자는 작업별로 여러 AI 모델을 사용한다며 Abacus AI의 Chat LM을 보여준다. 모델 선택·자동 라우팅과 콘텐츠 제작 기능에 관한 홍보가 계속된다. [03:45]
- 앱 제작, 에이전트, 호스팅 및 데이터베이스 등을 설명하고 월 10달러부터라는 구독 가격을 안내한다. 이 구간은 Q10의 성능 측정과 구분되는 서비스 홍보다. [04:09]
4. Windows ARM 개발 기기의 과거와 기다림
- Project Voltera는 600달러, 32GB 메모리 구성의 개발 기기로 묶인다. 발표자는 네이티브 개발 도구 확산에 기여했지만 현재 기준으로는 느리다고 평가한다. [05:02]
- 2024년 주문한 900달러 Snapdragon 개발 키트는 취소·환불됐지만 하드웨어는 보유했다. 과거 시험에서는 큰 소음과 최대 137W 수준의 소비전력이 관찰됐다고 회고한다. [05:45]
- 발표자는 상용 미니 PC가 2025년에 나올 것이라는 자신의 예상이 틀렸으며, 2026년에 실제 제품을 살 수 있게 됐다고 드러낸다. [06:00]
5. 합성 벤치마크와 브라우저 성능
- 발표자가 제시한 Geekbench 비교에서 Q10은 AMD·Intel 비교 기기를 앞서고 M4 Pro에 근접한다. 다만 이전 개발 키트 경험을 들어 합성 점수만으로 실사용 성능을 판단하지 않는다. [07:12]
- Speedometer 결과는 Q10 48.6, M4 Mac Mini 47.8, M4 Pro 45, AMD 비교 기기 37이다. 브라우저 중심 작업에서는 좋은 결과를 보였다. [07:56]
6. Node와 Chrome에서 갈린 웹 도구 성능
- 오래된 웹 도구 벤치마크의 첫 결과는 기하평균 8.15회/초였다. 발표자는 x64 Node가 Prism 변환 계층을 통해 실행되고 있었음을 확인한다. [09:22]
- ARM64 Node v24로 바꾼 뒤에도 결과는 11.8회/초에 머물렀다. 발표자가 제시한 AMD 28회/초와 이전 개발 키트 22회/초보다 낮았다. [09:57]
- HTML 버전을 Chrome에서 실행하자 49.89회/초가 나왔다. 발표자도 이 수치를 다른 기기의 Node CLI 결과와 비교하는 것은 동일 조건 비교가 아니라고 명시한다. [10:53]
7. NET 대형 컴파일과 소음·전력
- 실제 코드를 포함한 10만 개 네임스페이스로 대형 .NET 컴파일을 시험한다. 이전 개발 키트는 86초, M4는 106초였다고 보여준다. [11:19]
- Q10은 빌드를 77초에 완료해 M4 Pro의 66초 다음으로 빨랐다. 시험 중 약 109W를 관찰했고, 기기는 따뜻하지만 매우 조용했다고 평가한다. [11:50]
8. Python에서 확인한 네이티브 실행 효과
- CPU 사용률을 높이는 Python 프랙털 연산은 x64 버전에서 50.43초가 걸렸다. 팬 소리가 들리기 시작했지만 여전히 조용하다는 평가다. [12:43]
- ARM 실행 파일로 다시 측정하자 21.76초로 줄었다. M4 Pro 23.2초, 이전 개발 키트와 AMD 기기 각각 28.9초, M4 31.4초보다 빨랐고, 소비전력은 약 120~125W였다. [13:32]
9. NPU 구동 실패와 GPU 메모리 제약
- llama.cpp의 Hexagon 백엔드로 NPU를 사용하려 했지만 드라이버 단계에서 진행하지 못했다. 발표자는 자신의 설정 문제일 가능성도 언급한다. [14:01]
- 총메모리는 32GB지만 시험한 OpenCL 환경에서 GPU가 접근할 수 있는 용량은 약 15GB였다. 큰 모델은 CPU에서 실행하게 됐다. [14:28]
- 작은 Llama 모델에서 CPU는 초당 41토큰, GPU는 31토큰이었다. 발표자는 시험한 모든 모델에서 CPU가 GPU보다 빨랐다고 드러낸다. [14:46]
10. 모델 크기와 메모리에 따른 로컬 AI 성능
- 발표자는 토큰 생성 속도의 체감 차이를 설명한 뒤 비교 결과를 제시한다. 작은 Llama 모델에서 Q10은 41토큰/초, M4는 46토큰/초, M4 Pro는 101토큰/초였으며 Mac은 MLX를 사용했다. [15:53]
- M4 Pro의 우위에는 메모리 대역폭도 영향을 준다고 보여준다. Q10에서 27B급 밀집 모델은 약 5~6토큰/초였고, 일부 파라미터만 활성화하는 MoE 모델은 더 빨랐다. [16:30]
- GPT-OSS 20B는 약 35토큰/초, 소개한 Qwen 모델은 약 27토큰/초였다. 약 22GB 크기의 모델이 32GB Q10에는 들어가지만 16GB Mac Mini에는 들어가지 않는다는 용량상의 차이도 짚어 본다. [16:52]
11. 긴 컨텍스트의 한계와 최종 구매 판단
- 약 1만 6천 토큰의 긴 입력에서는 첫 출력까지 53초가 걸렸다. 동시 사용 상황에서는 사용자별 속도가 약 7토큰/초로 떨어져, 발표자는 한 사람이 책상에서 쓰는 용도에 적합하다고 평가한다. [17:22]
- Windows 개발자에게는 기다리던 제품이라는 결론이지만, 기본형 Mac Mini가 더 저렴하고 작은 AI 모델에서도 빠르다며 AI 목적 구매는 권하지 않는다. [17:48]
- 18코어와 32GB를 활용하는 일반 개발에는 긍정적으로 평가하면서 ARM 소프트웨어 호환성 확인을 당부한다. 이전 미니 PC 비교 영상을 안내하고 영상을 마친다. [18:09]
🧾 결론
- Q10은 개발 키트가 예고했던 Windows ARM 미니 PC의 가능성을 실제 제품과 개발 작업 성능으로 보여줬다.
- 강한 CPU가 모든 작업의 우위를 보장하지는 않는다. 네이티브 실행 여부, 런타임, AI 백엔드에 따라 결과가 크게 달라졌다.
- ‘Mac Mini 킬러’라는 평가는 Windows 개발이라는 조건에서 나온 발표자의 판단이다. 빌드, AI 추론, 가격을 함께 보면 일괄적인 우위는 아니다.
📈 투자·시사 포인트
- Windows ARM의 경쟁력을 평가할 때는 칩 성능과 함께 개발 도구의 네이티브 지원 및 실제 실행 경로를 확인필요가 있다.
- AI PC의 TOPS와 총메모리만으로 사용자 경험을 설명하기 어렵다. 드라이버, GPU 접근 가능 메모리, 추론 프레임워크가 제품 가치를 좌우한다.
- 메모리 용량과 대역폭은 서로 다른 구매 기준이다. 32GB는 큰 모델을 담는 데 유리했지만, 영상에서 M4 Pro의 높은 생성 속도는 대역폭과 소프트웨어 환경의 중요성을 보여줬다.
- 단일 제품 리뷰만으로 기업 실적이나 시장점유율 변화를 판단할 수는 없다. 이 영상은 개발용 ARM 데스크톱의 가능성과 소프트웨어 과제를 확인하는 자료로 활용할 수 있다.
⚠️ 불확실하거나 확인이 필요한 부분
- Q10의 정확한 판매 가격, 지역별 구성, 비교 기기의 세부 설정은 전사문에 충분히 제시되지 않는다. 가격 대비 성능의 정밀한 계산은 어렵다.
- Chrome 웹 도구 결과와 다른 기기의 Node CLI 결과는 동일 조건 비교가 아니다. ARM Node가 기대보다 느렸던 원인도 확정되지 않았다.
- NPU 구동 실패와 OpenCL의 약 15GB 메모리 접근 한계는 발표자의 시험 환경에서 관찰한 결과다. 모든 드라이버와 백엔드에 동일하게 적용되는지는 확인이 필요하다.
- 자막 기반 정리: 타임스탬프가 있는 자막을 기준으로 정리했으며, 고유명사·수치·인용은 원문 확인 필요 시 별도 검증한다.
- 영상 속 주장: 발표자의 해석·전망·비교는 확인된 외부 사실이 아니라 영상 속 주장으로 분리해 읽는다.
- 검증 필요: 수치, 기업 실적, 정책·시장 전망은 발행 전 최신 자료로 별도 검증이 필요하다.
✅ 액션 아이템
- 구매 전에 사용하는 IDE, 패키지, 확장 기능과 필수 프로그램의 Windows ARM 호환성을 확인한다.
- Node와 Python의 설치 버전뿐 아니라 실제 실행 중인 프로세스가 ARM64인지 확인한다.
- 자신의 프로젝트로 빌드와 CLI 작업을 측정하고, 비교 기기에도 동일한 런타임·버전·테스트 조건을 적용한다.
- 로컬 AI가 목적이라면 목표 모델의 메모리 요구량, 백엔드 지원, 첫 토큰 지연과 생성 속도를 직접 확인한다.
❓ 열린 질문
- ARM 네이티브 Node와 Chrome 사이의 큰 성능 차이는 어떤 런타임 설정이나 구현 차이에서 발생했을까?
- 드라이버와 추론 백엔드가 개선되면 Hexagon NPU 및 Adreno GPU의 활용도는 얼마나 달라질까?
- 같은 메모리 용량과 가격 조건으로 비교해도 Q10의 Windows 개발용 경쟁력은 유지될까?