이 태그와 연결된 문서를 한곳에서 모아보고, 함께 자주 등장하는 연관 태그까지 이어서 탐색할 수 있습니다.
연관 태그
총 721건 중 697-720건
이 글은 폴 포드와 댄 시퍼의 대화를 통해 클로드 오퍼스 4.5가 코딩 경험을 크게 바꾸는 동시에, 프롬프트 편향·훈련 데이터 공개·직업 정체성의 흔들림 같은 불편한 질문을 드러냈다고 정리한다.
AnyLanguageModel은 Apple 플랫폼에서 로컬 모델과 클라우드 LLM을 하나의 Swift API로 다루게 해 통합 부담을 줄이려는 패키지다.
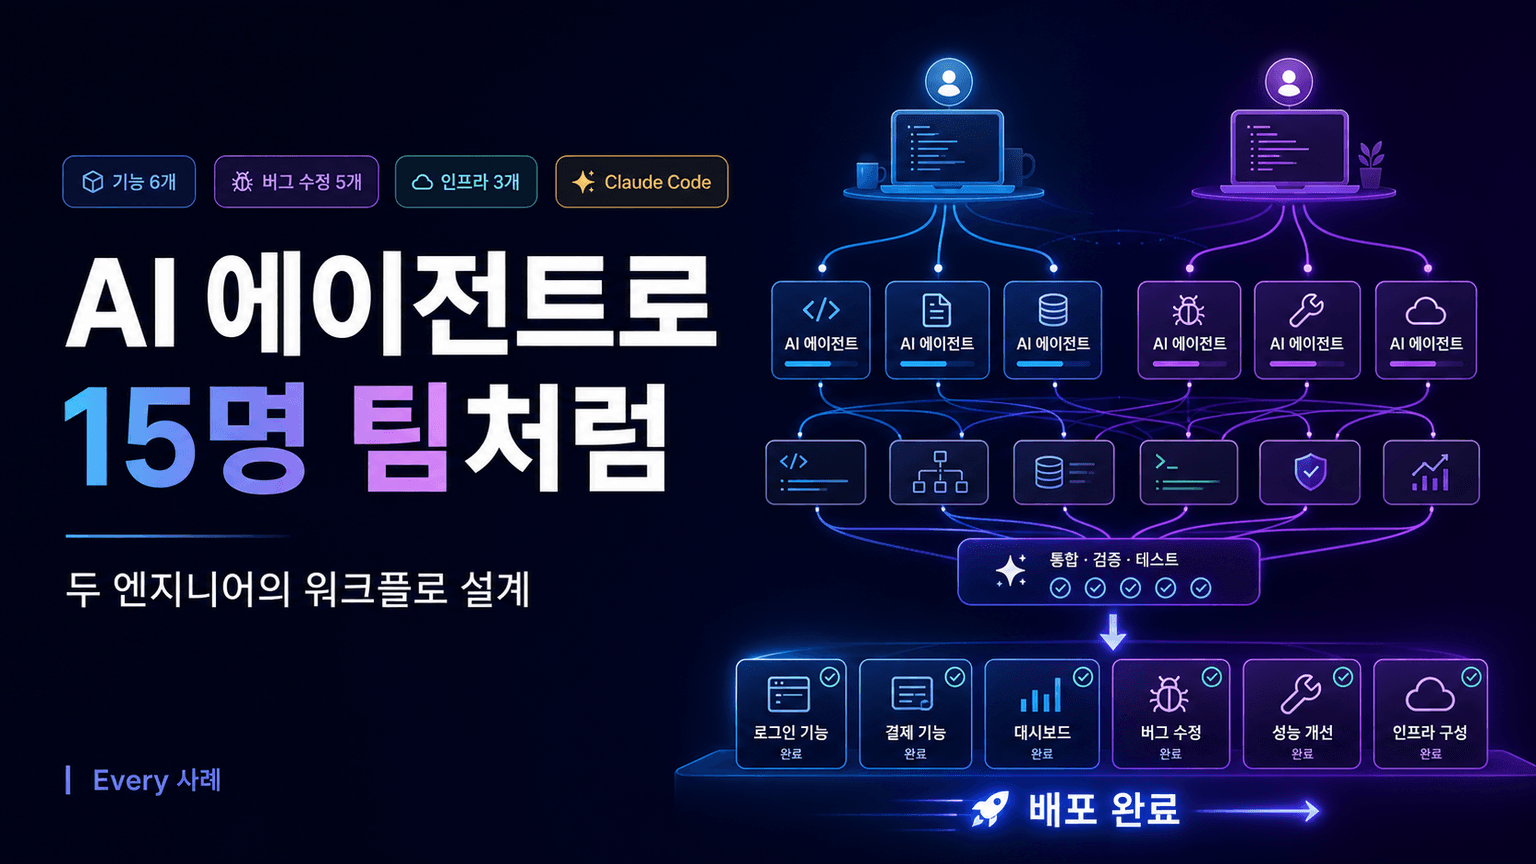
Every의 두 엔지니어는 AI 에이전트 기반 워크플로를 설계해 한 주 동안 기능 6개, 버그 수정 5개, 인프라 업데이트 3개를 처리한 사례를 소개한다.
Judge Arena는 LLM 평가자들을 익명·무작위 대결 방식으로 비교하고, 사람들의 투표를 Elo 리더보드로 집계해 어떤 모델이 더 나은 ‘판사’인지 벤치마킹하려는 플랫폼이다.
OpenAI와 Anthropic은 서로의 공개 모델에 내부 안전성·미스얼라인먼트 평가를 적용한 첫 공동 파일럿 결과를 공개하며, 모델별 강점과 취약점, 평가 협력의 필요성을 정리했다.
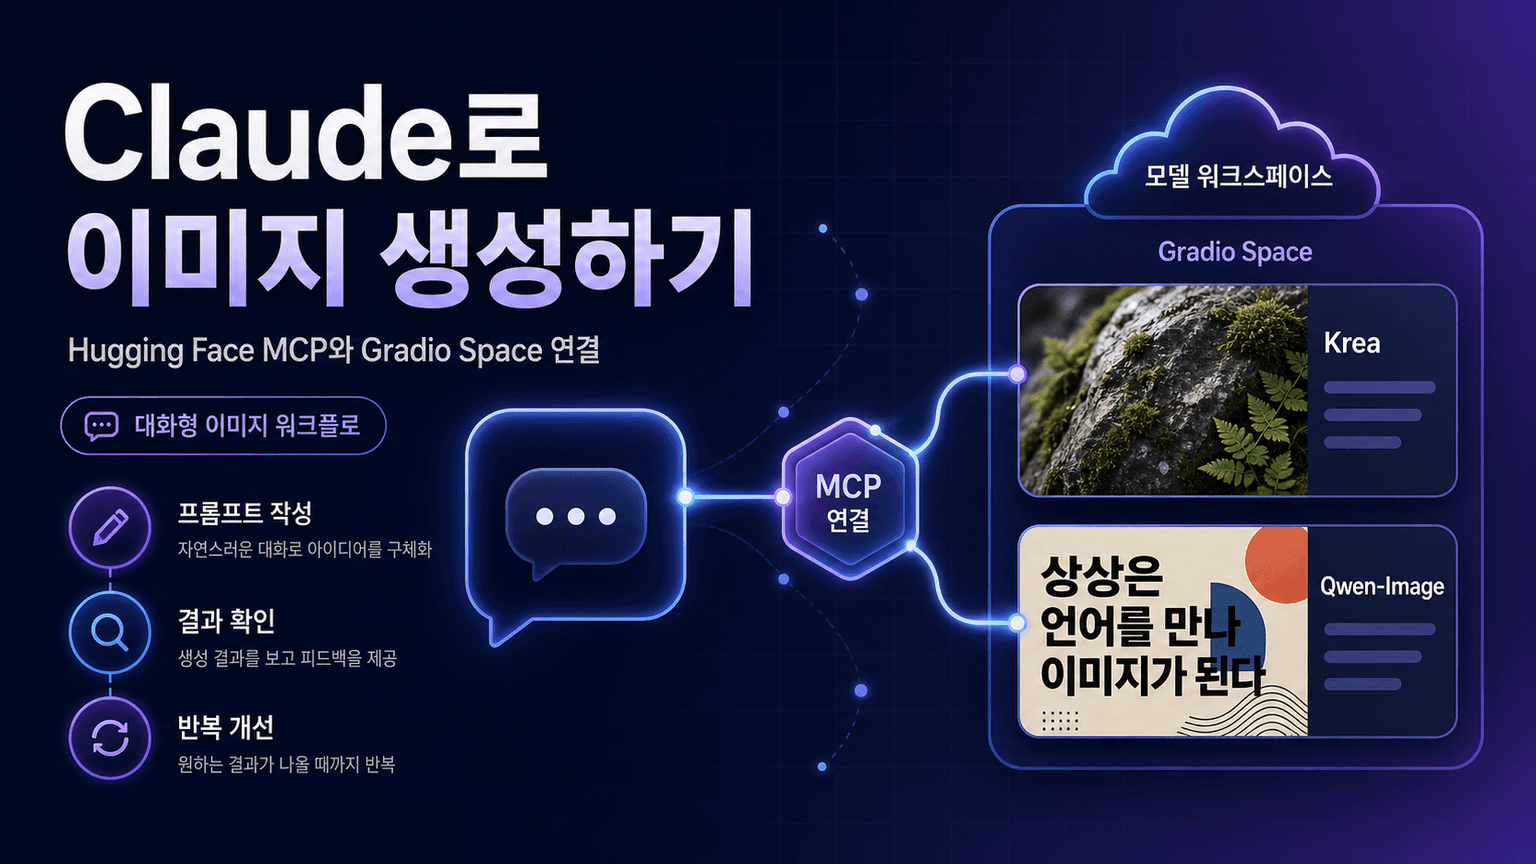
Claude에 Hugging Face MCP 서버와 이미지 생성용 Gradio Space를 연결하면 프롬프트 작성, 결과 확인, 반복 개선을 대화 안에서 수행하며 Krea와 Qwen Image 같은 최신 모델을 활용할 수 있다.
ScreenEnv는 Docker 기반의 격리된 우분투 데스크톱과 직접 제어 API·MCP 연동을 제공해 GUI 에이전트의 개발, 테스트, 배포를 단순화하는 Python 라이브러리다.
김이나 프로버는 중간 보조정리를 재귀적으로 생성·선별·결합하는 테스트 시점 강화학습 탐색과 린 오류 기반 교정 기능을 통해 미니에프투에프에서 92.2%의 최고 통과율을 기록한 형식 정리 증명 모델이다.
Open Researcher는 정해진 워크플로를 늘리는 대신 Anthropic의 interleaved thinking과 Firecrawl 웹 데이터 도구를 결합해 연구 과정에서 AI가 스스로 다음 행동을 판단하도록 만든 오픈소스 연구 에이전트다.
이 글은 CodeAgent의 유연한 코드 실행 방식에 구조화된 JSON 출력을 결합하면, 충분히 강한 모델에서 파싱 안정성과 추론 명시성이 높아져 여러 벤치마크 성능이 개선된다고 설명한다.
Microsoft는 Build에서 에이전트가 컴퓨터, 앱, 다른 에이전트, 인터넷과 연결될 수 있도록 개방형 ‘에이전틱 웹’ 인프라를 구축하겠다는 비전을 제시했다.
OpenAI는 비영리법인의 통제와 기존 사명을 유지하면서 영리 유한책임회사를 공익기업으로 전환해 대규모 자본 조달, 인공지능의 보편적 이용, 안전한 범용인공지능 개발을 함께 추진하겠다고 밝혔다.
제공된 source body는 ‘에이전트 프레임워크를 어떻게 생각할 것인가’라는 본문이 아니라, Webflow 기반 페이지의 전역 CSS·반응형 레이아웃·표·블로그 카드·리치 텍스트 스타일을 정의한 스타일 코드입니다.
HELMET은 장문맥 언어 모델을 실제 응용 과제에서 다양성·통제 가능성·신뢰성을 기준으로 종합 평가하며, 단순 합성 과제만으로는 드러나지 않는 모델별 강점과 장문 입력에서의 성능 저하를 밝히는 벤치마크다.
Open R1은 DeepSeek R1에서 공개되지 않은 데이터셋과 학습 코드를 재구성해, 추론 모델의 증류·순수 강화학습·다단계 학습 과정을 누구나 검증하고 재현할 수 있도록 만들려는 오픈 프로젝트다.
DeepSeek R1의 공개는 중국 생성 AI의 추격, 오픈 웨이트 모델의 공급망 중요성, 기반 모델 가격 하락, 그리고 강화학습 기반 추론 모델·컴퓨터 사용 에이전트의 부상을 동시에 부각시켰다.
OpenAI는 o1 계열 추론 모델이 추론 시점에 더 오래 ‘생각’하도록 계산 자원을 늘리면 여러 적대적 공격에 대한 성공 확률이 낮아질 수 있다는 초기 증거를 제시했다.
smolagents는 언어 모델이 외부 도구를 코드로 조합·실행하도록 지원해, 복잡한 다단계 에이전트 워크플로를 단순하게 구축하는 라이브러리다.
빅 벤치 오디오 평가 결과, 음성을 직접 처리하는 모델은 텍스트 기반 추론보다 정확도가 크게 낮았으며 추론이 중요한 환경에서는 음성 인식·텍스트 추론·음성 합성을 연결한 파이프라인이 더 우수했다.
BAAI는 정적 벤치마크와 사용자 투표형 아레나의 한계를 보완하기 위해 대형 언어모델들이 다국어로 직접 토론하며 추론력·논증력·언어 능력을 드러내는 FlagEval Debate를 제안한다.
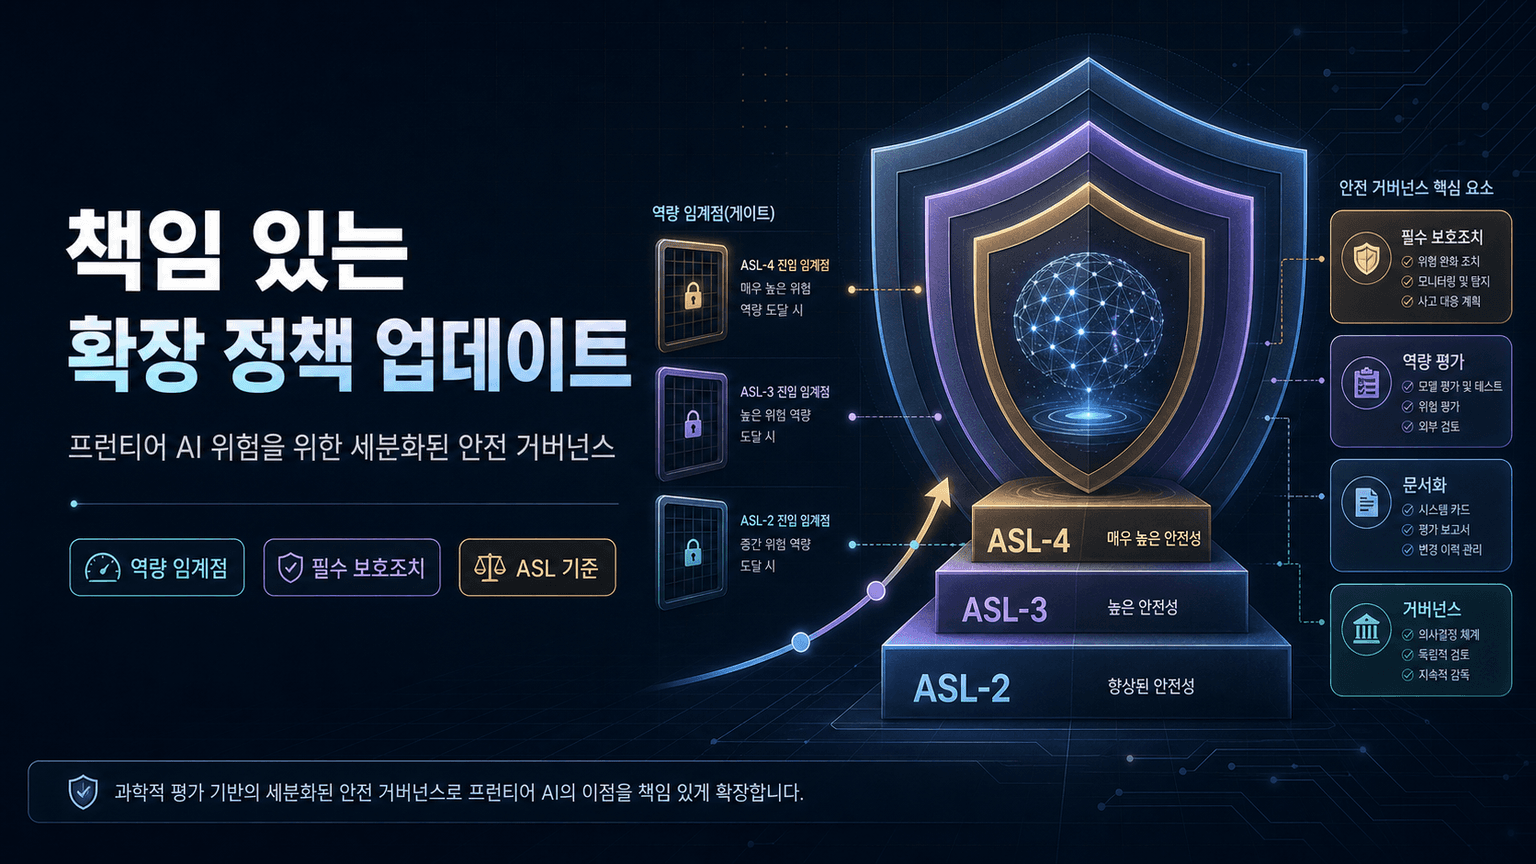
Anthropic은 프런티어 AI의 재앙적 위험을 관리하기 위해 Responsible Scaling Policy를 더 유연하고 세분화된 위험 거버넌스 체계로 업데이트했다.
Epoch AI는 최신 데이터 확장을 바탕으로, 프런티어 AI 모델의 학습 컴퓨트가 최근 연간 약 4~5배 속도로 증가해 왔다고 결론짓는다.
바이든 행정부의 AI 행정명령은 국방·비상권한에 근거해 일부 기초 모델의 보고·시험을 요구하고, 연방기관이 안전·프라이버시·차별·경쟁력·국제표준 관련 기준을 마련하도록 지시한 조치다.
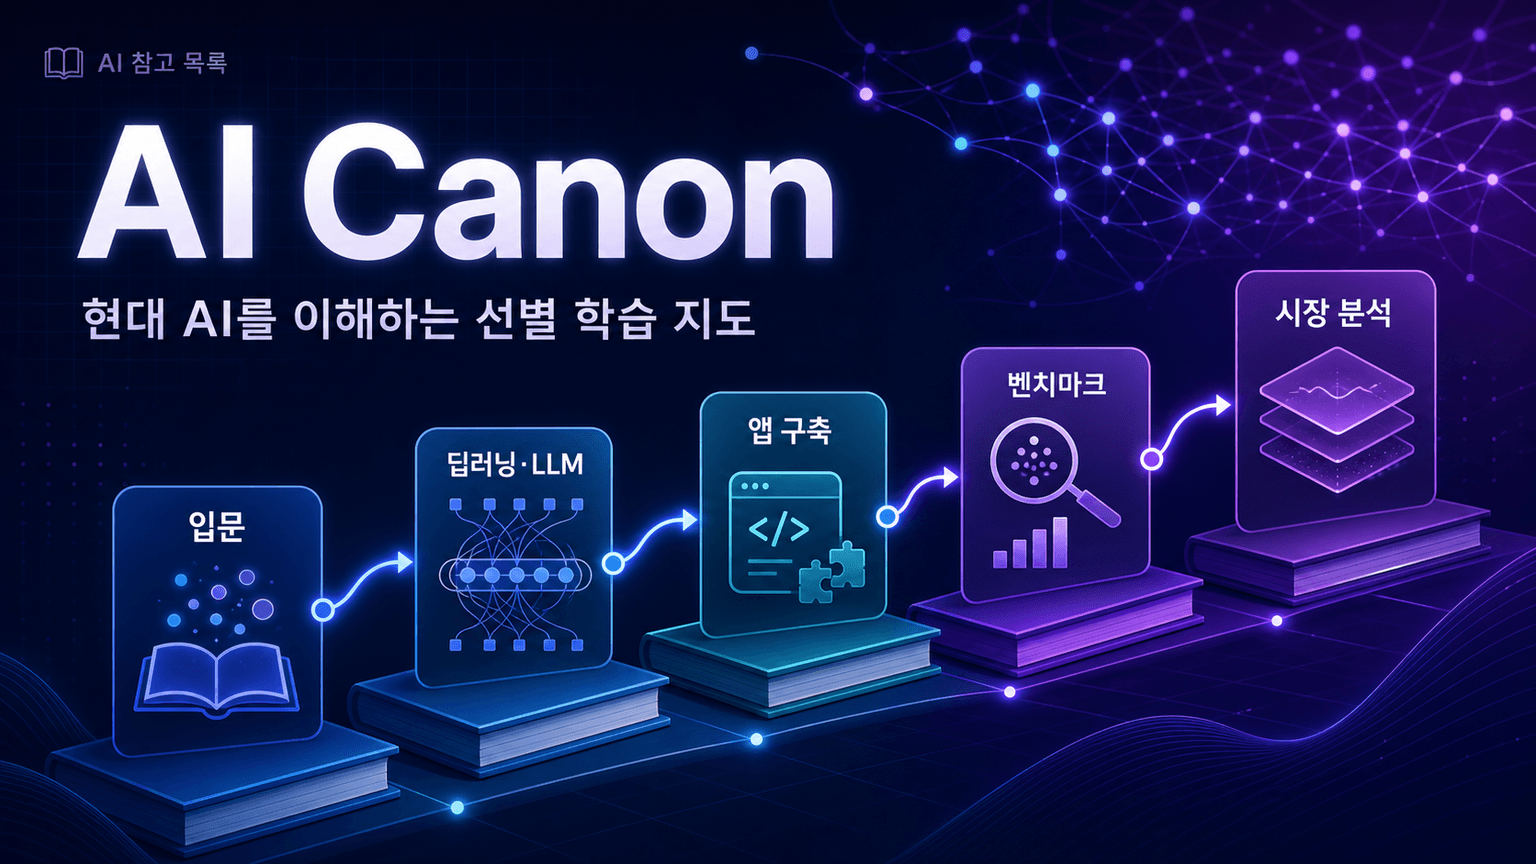
a16z의 ‘AI Canon’은 현대 AI를 이해하기 위해 영향력이 컸던 논문, 글, 강의, 실무 가이드, 시장 분석 자료를 단계별로 묶은 선별 참고 목록이다.