New in LangSmith: Engine v2, Managed Deep Agents, Fine-Tuning, and more
Quick Summary
LangSmith는 Engine v2, Managed Deep Agents v0.8, Trajectories, Fine Tuning, Custom Apps를 통해 에이전트 운영부터 문제 탐지·평가·특화 모델 학습까지 이어지는 개발 과정을 확장했다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
LangSmith는 Engine v2, Managed Deep Agents v0.8, Trajectories, Fine-Tuning, Custom Apps를 통해 에이전트 운영부터 문제 탐지·평가·특화 모델 학습까지 이어지는 개발 과정을 확장했다.
📌 핵심 요약
- LangSmith Engine v2는 운영 트레이스와 저장소를 활용하는 레드팀 테스트, 오류율·지연 시간·비용 추세 및 비효율 탐지, 수정안 자동 검증을 추가했다. 수정안 자동 검증은 LangSmith Deployment에서 실행되는 에이전트를 대상으로 하며, 사람의 검토와 배포 전에 수행된다.
- Managed Deep Agents v0.8은 기존 에이전트 메모리에 인증된 사용자별 메모리를 추가하고, 에이전트·사용자 소유 자격 증명을 지원한다. Slack 파일 전송, JSON 웹훅을 받는 HTTP 채널, Parallel 기반 내장 웹 검색도 제공한다.
- LangSmith Trajectories는 주 에이전트와 하위 에이전트의 사람·AI·도구 메시지를 시간순 대화 화면으로 모아 디버깅과 도메인 전문가의 검토를 돕는다. LangSmith 온라인 평가기도 Trajectories를 채점할 수 있다.
- LangSmith Fine-Tuning은 고품질 작업 예제로 오픈 모델을 지도 미세조정(SFT)하도록 지원한다. CLI인 smithtune은 Trajectories 기반 데이터 준비, Baseten 또는 Fireworks를 통한 학습, LangSmith 평가, 모델 서빙과 애플리케이션 연결을 지원하며, 특정 작업의 품질·비용·지연 시간 개선 가능성을 제시하지만 본문에 구체적인 벤치마크 수치는 없다.
- Custom Apps는 LangSmith API와 템플릿, 앱 내 채팅 또는 코딩 에이전트 안내를 활용해 맞춤 인터페이스를 만들고 워크스페이스에 게시하도록 지원한다. 주요 용도는 주석 작업, 실험 비교, 트레이스 검토이며, 전체 발표는 런타임과 관측·평가를 강화해 기업별 도메인 특화 에이전트 개발을 지원하는 데 초점을 맞춘다.
🧩 주요 포인트
- Engine v2의 사전 탐지와 수정안 검증 → 문제 발견부터 수정까지의 작업을 자동화하되, LangSmith Deployment라는 적용 조건과 사람의 검토 단계를 유지한다.
- Managed Deep Agents v0.8의 사용자별 메모리·자격 증명과 채널 확장 → 사용자 맥락을 분리하면서 다양한 접점에서 에이전트를 운영할 기반을 넓힌다.
- Trajectories의 세션 정리, Fine-Tuning의 학습 연결, Custom Apps의 맞춤 검토 → 운영 데이터를 평가와 특화 모델 개선에 재사용하는 흐름을 강화하며, 실제 품질·비용·지연 시간 효과는 개별 작업에서 확인할 필요가 있다.
🧠 상세 정리
1. 런타임과 관측·평가를 잇는 개발 방향
2026년 9월 25일 Jacob Talbot이 게시한 이 발표는 Interrupt NYC에 모인 수백 명의 AI 엔지니어에게 소개한 LangSmith 업데이트를 정리한다. 업데이트의 두 축은 에이전트 운영에 필요한 런타임과, 행동을 이해하고 품질을 측정하는 관측·평가다. 런타임은 메모리, 채널, 도구, 안전한 실행 환경 등을 제공하며, 관측·평가는 사용 과정에서 에이전트를 개선하도록 돕는다. 그 위의 지능 계층은 비즈니스 로직, 트레이스, 평가 및 운영 데이터를 활용해 개발과 개선의 순환을 가속한다는 구상이다. 원문은 이를 통제력과 유연성, 거버넌스를 갖춘 도메인 특화 에이전트를 개발하고 기업이 자체 지능을 소유하도록 지원하는 방향으로 설명한다.
2. Engine v2의 사전 문제 탐지와 수정안 검증
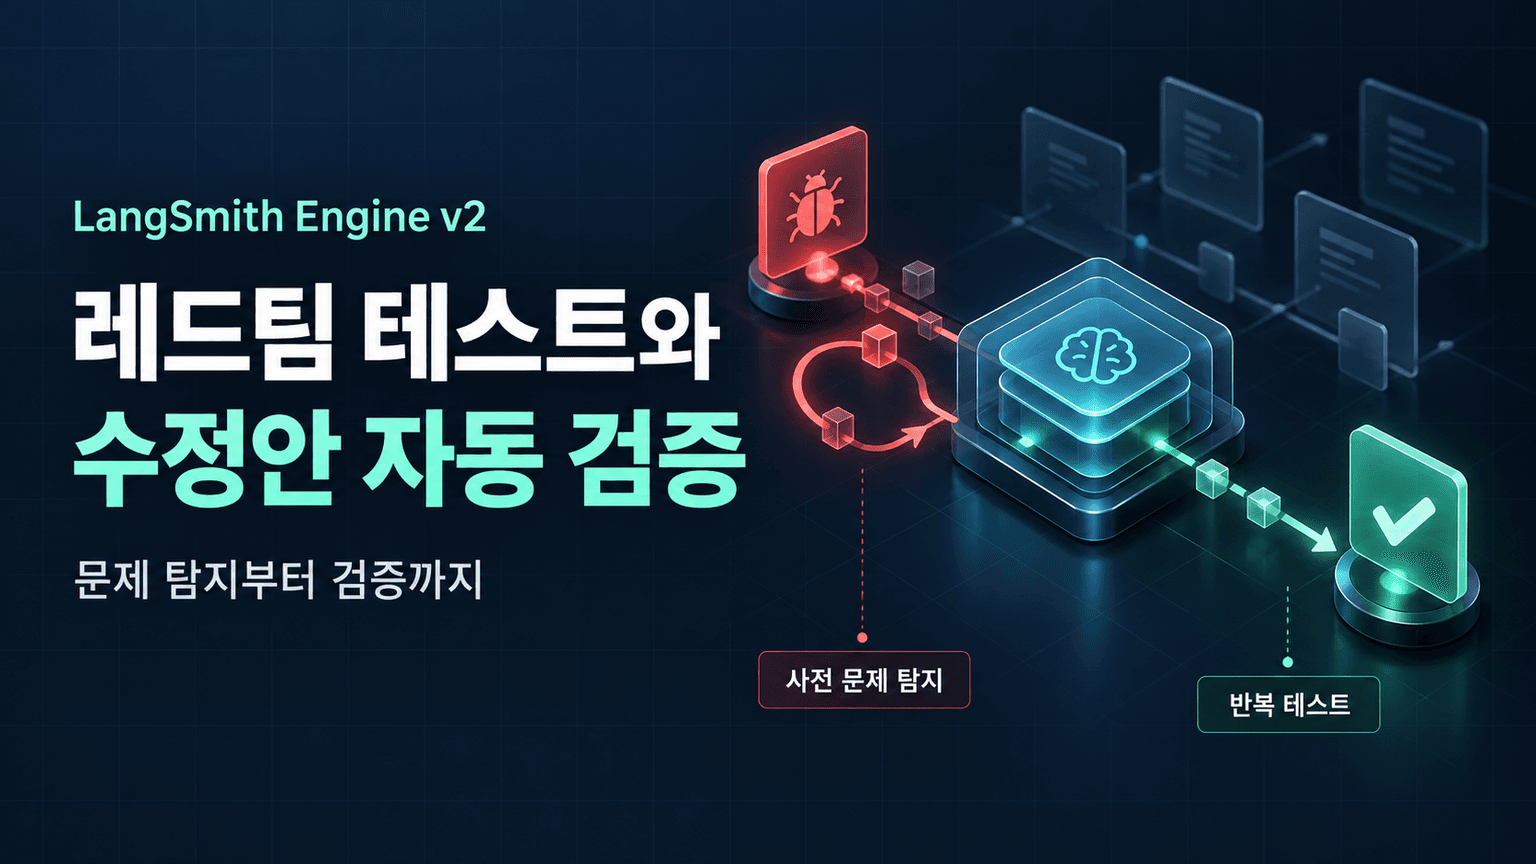
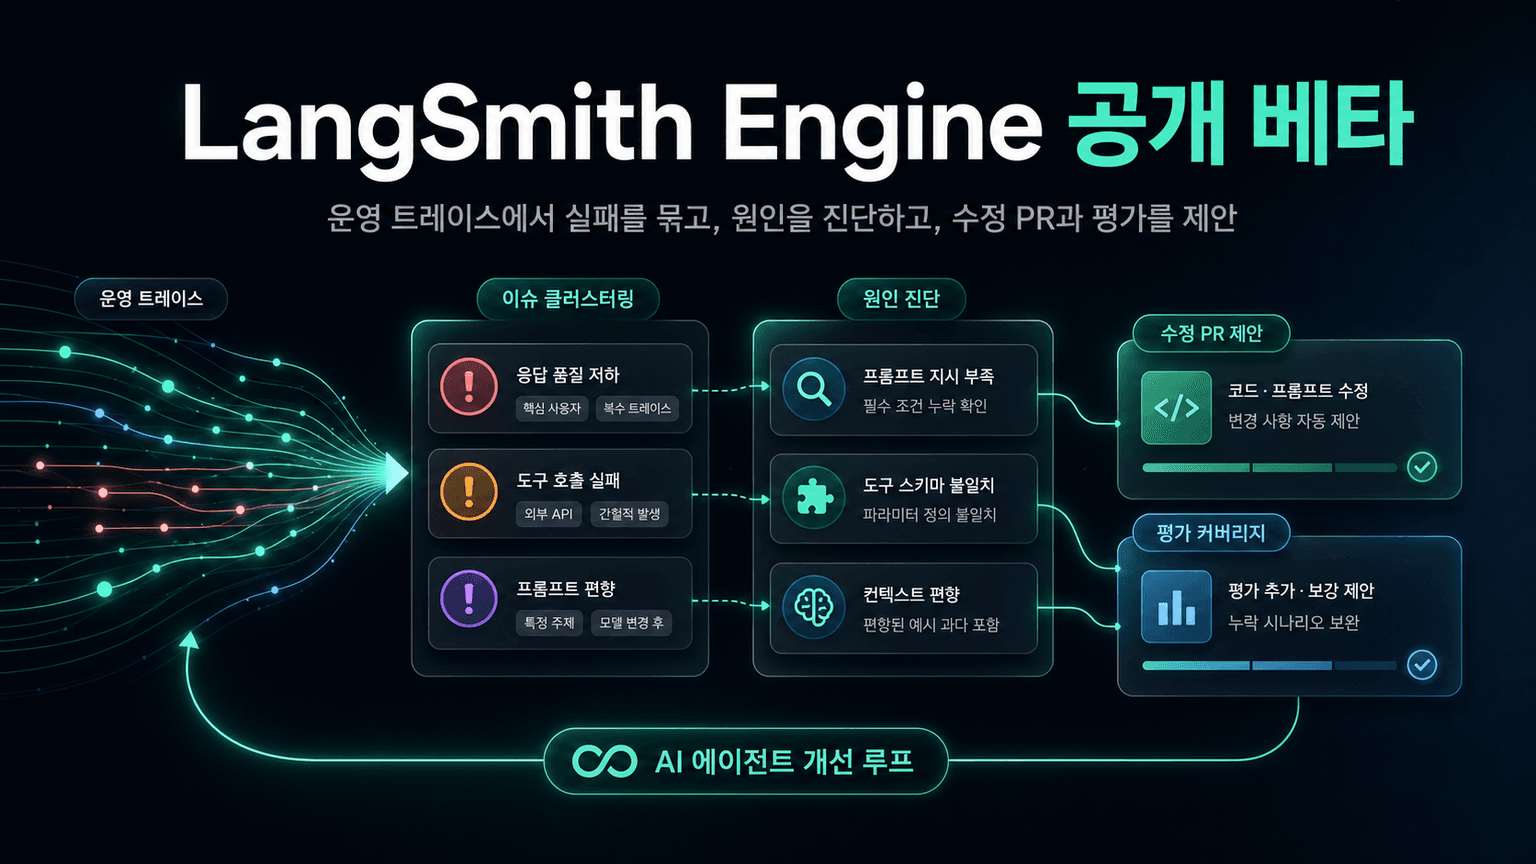
LangSmith Engine은 문제 발견, 원인 분석, 수정 제안, 테스트, 배포 및 회귀 모니터링으로 이어지는 작업을 자동화하는 플랫폼 내 에이전트이며, 원문에 따르면 5월 출시 이후 6천만 개가 넘는 트레이스 분석과 수만 건의 문제 진단을 도왔다. Engine v2의 레드팀 기능은 운영 트레이스와 저장소를 바탕으로 아직 운영 환경에서 나타나지 않은 문제의 가설을 만들고 시험해, 확인된 실패를 검토 대상으로 제시한다. 탐지 범위도 오류와 미충족 사용자 요청에서 오류율·지연 시간·비용 추세, 반복 도구 호출과 불필요하게 긴 실행 경로까지 확대됐다. LangSmith Deployment에서 실행되는 에이전트에 대해서는 문제 입력을 재실행해 오류를 확인하고, 더 넓은 평가 세트로 후보 수정안을 시험한다. 만족스러운 수정안은 사용자에게 제시되며, 사용자는 한 번의 클릭으로 PR을 열 수 있어 사람의 검토와 배포 이전에 검증이 이루어진다. 자체 호스팅 LangSmith의 다음 릴리스에서는 Engine용 BYOK를 지원할 예정이라고 밝혔다.
3. Managed Deep Agents v0.8의 메모리·인증·접점 확장
Managed Deep Agents는 Deep Agents 하네스와 관리형 인프라를 결합하며, v0.8은 운영 과정의 메모리, 인증, 채널 및 도구 관리 문제에 대응한다. 기존의 지속성 있는 에이전트 메모리에 인증된 사용자별 메모리를 추가해, 호출자별 맥락을 공유 에이전트 메모리와 분리해 저장하도록 했다. 런타임은 두 계층 사이에서 내용을 복사하지 않으며, 각 계층에 접근 정책을 정의해 사용자 정보가 대화에 유출되지 않도록 통제할 수 있다. GitHub와 Notion 같은 외부 연결에는 에이전트 소유 자격 증명과 사용자 소유 자격 증명을 모두 지원한다. Slack에서는 로그, 스프레드시트, 계약서, 스크린샷 등의 파일 전송을 지원하고, 새 HTTP 채널은 JSON 웹훅을 보낼 수 있는 서비스와 연결된다. Parallel 기반 웹 검색도 사전 구축 도구로 제공해 별도의 공급업체 계정, API 키 또는 맞춤 도구 설정 없이 최신 정보에 접근하도록 했다.
4. Trajectories로 읽기 쉬워진 에이전트 세션
장시간 실행되는 에이전트 세션에는 여러 대화 턴, 도구 호출, 재시도 및 하위 에이전트 인계가 포함되어 전체 트레이스가 길고 복잡하게 중첩될 수 있다. LangSmith Trajectories는 이런 세션을 대화 형태로 보여주며, 주 에이전트와 하위 에이전트에 걸친 사람·AI·도구 메시지를 시간순으로 모은다. 이를 통해 팀이 행동이 달라지거나 문제가 발생한 지점을 빠르게 파악하도록 돕는 것이 목적이다. 에이전트를 직접 만들지 않은 도메인 전문가도 실행 메타데이터를 해석하는 부담을 줄이고 세션을 채점하거나 문제를 표시하고 주석을 달 수 있다. LangSmith 온라인 평가기 역시 Trajectories를 채점할 수 있으므로, 이 화면은 사람이 읽기 쉬운 검토 수단이면서 세션 전반의 행동을 평가하고 개선하는 입력으로도 활용된다.
5. Fine-Tuning으로 운영 기록을 특화 모델 학습에 연결
LangSmith Fine-Tuning은 팀이 미세조정 파이프라인을 직접 구축하지 않고도 오픈소스 모델을 자체 데이터로 학습할 수 있도록 제공된다. 원문은 이렇게 학습한 모델이 특정 작업에서 범용 프런티어 모델과 같거나 더 나은 성능을 내면서 비용과 지연 시간을 크게 낮출 수 있다고 주장하지만, 이를 모든 작업에 보장하지는 않는다. 지원 방식은 고품질 작업 예제를 이용하는 지도 미세조정(SFT)이며, CLI인 smithtune이 Trajectories를 학습에 유용한 데이터로 전환하는 과정을 돕는다. 구체적으로 데이터셋 구축과 준비, Baseten 또는 Fireworks를 통한 모델 학습, LangSmith를 통한 결과 평가, 미세조정 모델의 서빙과 애플리케이션 연결을 지원한다. 자체 내부 벤치마크 결과에 대해서는 긍정적으로 평가하며 별도 설명을 안내하지만, 이 본문에는 비교 조건이나 구체적인 성능·비용 수치가 제시되어 있지 않다.
6. Custom Apps와 기업별 맞춤 개선 흐름
LangSmith는 트레이스 검토, 실험 비교, 주석 작성 및 평가 분석을 위한 기본 인터페이스를 제공하지만, 고객들은 각자의 작업 방식과 품질 기준에 맞는 화면을 요구했다고 설명한다. Custom Apps는 LangSmith 데이터 위에 맞춤 인터페이스를 구축하고 게시하며 실행할 수 있도록 이 요구에 대응한다. 팀은 데이터를 내보내거나 별도 내부 도구를 유지하는 대신, LangSmith API에 템플릿, 앱 내 채팅 또는 코딩 에이전트 안내를 활용해 앱을 만들고 워크스페이스에 게시할 수 있다. 게시된 앱은 반복 작업을 위한 공유 인터페이스가 되며, 집중된 주석 작업 화면, 버전이나 데이터 구간별 출력 비교, 애플리케이션 특성에 맞춘 트레이스 검토 등에 활용된다. 발표는 이러한 맞춤화와 운영·평가·학습 기능을 기업이 해결하려는 구체적인 문제에 맞춰 에이전트와 애플리케이션을 개발하고 자체 지능을 소유하도록 돕는다는 목표로 연결하며 마무리한다.
🧾 핵심 주장 / 시사점
- Engine v2는 이미 발생한 오류의 분석에서 잠재적 실패의 사전 탐지로 범위를 넓히지만, 수정안은 사람에게 제시되는 구조이므로 자동 검증과 사람의 검토가 함께 작동한다.
- 사용자별 메모리와 자격 증명은 Managed Deep Agents v0.8의 개인별 맥락 활용을 뒷받침하며, 채널 확장은 이 맥락을 활용하는 에이전트가 사용자와 만날 수 있는 접점을 넓힌다.
- Trajectories는 검토 가능한 세션 표현과 Fine-Tuning 학습 데이터의 연결점이다. 다만 학습 과정의 통합 지원 자체가 특정 작업에서의 품질·비용·지연 시간 개선을 입증하는 것은 아니다.
✅ 액션 아이템
- LangSmith Deployment에서 실행되는 에이전트에 Engine v2의 사전 탐지와 수정안 자동 검증을 적용할 수 있는지 검토하고, 사람의 검토 단계와 연결 방식을 확인한다.
- Managed Deep Agents v0.8의 사용자별 메모리·자격 증명을 활용할 때 사용자 맥락 분리 요구와 Slack·HTTP 채널의 운영 적합성을 검토한다.
- Trajectories 기반 Fine-Tuning의 후보 작업을 선정하고, LangSmith 평가를 통해 품질·비용·지연 시간 개선 여부를 확인한다.
❓ 열린 질문
- Engine v2의 수정안 자동 검증은 LangSmith Deployment에서 실행되는 에이전트의 문제를 어느 범위까지 해결하며, 사람의 검토에서는 무엇을 확인해야 하는가?
- Managed Deep Agents v0.8의 사용자별 메모리·자격 증명은 필요한 사용자 맥락 분리와 다양한 채널의 운영 요구를 충족하는가?
- Trajectories 기반 Fine-Tuning은 대상 작업에서 범용 모델 대비 품질·비용·지연 시간을 얼마나 개선하는가?