Agent Evaluation Metric for multi-turn conversations
Quick Summary
AEM은 다중 턴 에이전트의 정확성을 사실 일치성·완전성으로 분해하고 턴별로 평가해, 실패의 근본 원인과 후속 턴의 연쇄 실패를 구분하는 평가 프레임워크다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
AEM은 다중 턴 에이전트의 정확성을 사실 일치성·완전성으로 분해하고 턴별로 평가해, 실패의 근본 원인과 후속 턴의 연쇄 실패를 구분하는 평가 프레임워크다.
📌 핵심 요약
- 다중 턴 대화에서는 한 번의 잘못된 도구 호출이 이후 턴으로 전파되므로, 최종 결과나 전체 점수만으로는 오류가 시작된 턴과 영향을 받은 턴을 구분하기 어렵다.
- AEM은 정확성을 사실 일치성(truthfulness)과 완전성(completeness)으로 나누며, 응답 턴과 도구를 호출하는 행동 턴에 공통으로 적용한다. 행동 턴에서는 도구·작업 선택의 구조적 정확성도 확인한다.
- 원문은 각 턴을 통과·실패로 판정하고 전체 턴 중 통과한 비율을 기본 AEM 점수로 사용한다. 가중 평균, 중요 턴 실패에 따른 점수 상한, 하위 지표별 임계값 등 다른 합성 규칙도 허용한다.
- 사실 일치성은 임베딩 유사도 또는 LLM-as-judge를 통한 의미 비교로 평가할 수 있다. 예시 임계값 0.5는 조정된 최적값이 아니며, 도메인의 오탐·미탐 허용 수준에 맞춰 설정해야 한다.
- prior_action_failed는 앞선 실패 턴의 출력을 사용했기 때문에 발생한 연쇄 실패를 표시한다. 5턴 판매 보고서 예시에서는 2턴에 revenue 대신 profit을 전달한 것이 근본 원인이며, 3~5턴은 그 영향을 이어받는다.
🧩 주요 포인트
- 정확성을 사실 일치성·완전성으로 분리 → 점수 하락을 구체적인 품질 차원과 연결하고, 같은 분해·평가·합성 방식으로 안전성·지시 유지·추론 깊이까지 확장할 수 있는 구조를 제시한다.
- 의미 비교와 조정 가능한 합성 규칙을 결합 → 표현이 다른 동등한 답을 인정하면서 도메인별 오류 허용 수준과 중요 턴의 비용을 평가에 반영할 수 있다.
- prior_action_failed로 의존 관계에 따른 실패를 구분 → 5턴 판매 보고서 예시처럼 여러 실패가 하나의 잘못된 매개변수에서 시작됐음을 드러내 수정 대상을 좁힌다.
🧠 상세 정리
1. 다중 턴에서 정확성 오류가 전파되는 문제
다중 턴 에이전트의 정확성은 앞선 턴의 작은 오류가 뒤따르는 작업 전체를 오염시킬 수 있다는 점에서 평가하기 어렵다. 원문은 사용자가 판매 보고서를 만든 뒤 이를 수정하는 5턴 대화를 예로 들며, 에이전트가 2턴에서 올바른 작업을 선택하고도 revenue 대신 profit을 매개변수로 전달하는 상황을 제시한다. 이 오류는 3~5턴에 조용히 전파되지만, 최종 결과만 확인하는 과업 수준 평가는 전체 상호작용을 실패로 처리할 뿐 실제로 어느 턴을 고쳐야 하는지 보여주지 못한다. 따라서 평가에는 결과의 성공 여부뿐 아니라 오류가 처음 발생한 위치와 그 오류를 물려받은 후속 턴을 구별하는 능력이 필요하다는 것이 글의 출발점이다.
2. 기존 종합 평가의 가치와 분해 평가의 필요성
원문은 기존 에이전트 평가 도구가 제공하는 목표 달성 점수, LLM-as-judge 품질 평가, 일부 도구의 추적 기록 수준 원인 분석을 유용한 기능으로 인정한다. 다만 이러한 접근은 대체로 품질을 하나의 신호로 다루므로, 목표 달성률이 70퍼센트라는 결과만으로는 사실 오류와 정보 누락, 잘못된 도구 선택을 구분하기 어렵다고 지적한다. 과업 수준 지표는 어떤 품질 차원이 무너졌는지 보여주기 어렵고, 단일 턴 지표는 오류의 턴 간 전파를 놓치며, 종합 점수는 새로운 평가 차원을 추가할 때도 한계를 갖는다. AEM은 이름이 붙은 하위 지표를 독립적으로 측정하고 전체 대화 흐름 안에서 턴별로 평가한 뒤 다시 합성하는 방식으로 이 공백을 메우려 한다.
3. 정확성을 구성하는 사실 일치성과 완전성
AEM은 에이전트 품질을 독립적으로 측정할 수 있는 하위 지표들의 복합 지표로 정의하며, 이 글에서는 첫 번째 적용 차원으로 정확성을 다룬다. 사실 일치성은 도구 호출의 매개변수 값이나 자연어 응답의 진술이 기대한 내용과 사실적으로 일치하는지 확인하고, 완전성은 필수 매개변수 또는 사용자가 요청한 정보가 빠짐없이 포함됐는지 확인한다. 도구와 작업을 올바르게 선택했는지는 이 두 하위 지표를 떠받치는 구조적 기반이며, 글이 강조하는 핵심 기여는 불투명한 단일 점수보다 이러한 분해 방식 자체에 있다. 같은 분해·평가·합성 패턴은 안전성, 지시 유지, 추론 깊이 같은 차원으로도 확장할 수 있다고 제시하지만, 제공된 본문에서 구체적으로 구현해 설명하는 대상은 정확성이다.
4. 응답 턴과 행동 턴을 아우르는 공통 계층
AEM에서 턴은 사용자에게 답하는 응답 턴과 도구를 호출하는 행동 턴으로 나뉘며, 두 유형 모두 사실 일치성과 완전성이라는 공통 기준으로 평가된다. 응답 턴에서는 답변이 질문 전체를 다루는지와 사실적으로 일치하는지를 확인하고, 행동 턴에서는 필요한 매개변수 키가 존재하는지와 매개변수 값이 의미상 올바른지를 구분해 확인한다. 행동 턴에는 올바른 도구와 작업을 선택했는지에 대한 구조적 점검이 추가되므로, 자연어 답변과 도구 호출의 차이를 유지하면서도 같은 평가 계층 안에서 다룰 수 있다. 이 글은 각 턴의 정확성을 통과 또는 실패로 처리하고 실패한 하위 지표와 필드를 명시하지만, 동일한 분해 구조에서 개별 주장이나 필드에 연속적인 점수를 부여하는 더 세밀한 평가도 가능하다고 설명한다.
5. 의미 비교와 임계값이 판정을 만드는 방식
원문은 응답과 매개변수 값을 정확한 문자열 일치만으로 평가하면 표현이 다른 동등한 내용을 잘못 처리할 수 있다고 설명하며, New York City와 NYC를 의미상 같은 값의 예로 든다. 제시된 사실 일치성 함수는 두 값이 완전히 같으면 즉시 통과시키고, 그렇지 않으면 의미 유사도 점수를 임계값과 비교해 판정하며, 평가기로는 빠르고 저렴한 임베딩 방식이나 더 섬세한 LLM-as-judge를 사용할 수 있다. 임베딩 방식은 인코더와 유사도 함수로 구성돼 상대적으로 투명한 반면, 디코더 기반의 판정 모델은 점수 산정 내부를 직접 들여다보기 어렵다는 차이도 제시한다. 높은 임계값은 실제 오류를 더 엄격하게 잡는 대신 의미상 동등한 표현을 오류로 볼 위험이 있고 낮은 임계값은 더 관대하므로, 예시의 0.5는 최적화된 값이 아니라 도메인의 오탐·미탐 허용 수준에 따라 조정할 출발점이다.
6. 완전성 검사와 점수 합성의 선택지
응답 턴의 완전성은 답변이 질문 전체를 다루는지를 의미적으로 판단하지만, 행동 턴의 완전성은 정답과 예측의 매개변수 키 집합을 비교하는 구조적 검사로 설명된다. 제시된 함수는 필수 키의 누락뿐 아니라 예상하지 않은 추가 키도 확인하며, 누락 집합과 추가 집합이 모두 비어 있어야 통과시키고 각각의 집합을 구체적인 실패 사유에 연결한다. 하위 지표별·턴별 판정을 전체 점수로 합성할 때 기본 규칙은 통과한 턴의 비가중 평균, 즉 전체 턴 중 통과한 비율이지만, 원문은 이 규칙 자체도 선택 가능한 구성 요소라고 강조한다. 오류 비용이 큰 턴에 더 높은 가중치를 주거나, 중요한 턴 하나의 실패가 점수 상한을 정하게 하거나, 하위 지표마다 별도 임계값을 두는 규칙도 허용해 평가 목적에 맞게 합성 방식을 바꿀 수 있다.
7. 실패 분류와 의존 관계에 따른 원인 귀속
실패 분류는 응답 턴의 사실 불일치를 inconsistent_response, 정보 누락을 incomplete_response로 표시하고, 행동 턴에서는 tool_mismatch와 action_mismatch로 도구 및 작업 선택 오류를 구분한다. 매개변수 문제는 missing_parameters, extra_parameters, inconsistent_parameter_values로 나눠 누락·추가·의미상 잘못된 값을 각각 식별하며, 두 턴 유형 모두에 적용되는 prior_action_failed는 앞선 실패로 인한 연쇄 효과를 뜻한다. 평가기는 실패가 해당 턴에서 시작됐으면 근본 원인으로 보고, 이미 실패한 턴의 출력을 소비했기 때문에만 실패했으면 prior_action_failed를 부여하므로, 5턴 예시에서는 2턴만 근본 원인이며 3~5턴은 이 표식을 이어받는다. 또한 단일 호출, 2단계, 3단계 이상의 복잡한 시퀀스로 행동 체인 길이를 추적하며, 원문은 긴 체인에 품질 저하가 주로 집중된다고 설명한다.
8. 평가 파이프라인과 제공된 예시의 범위
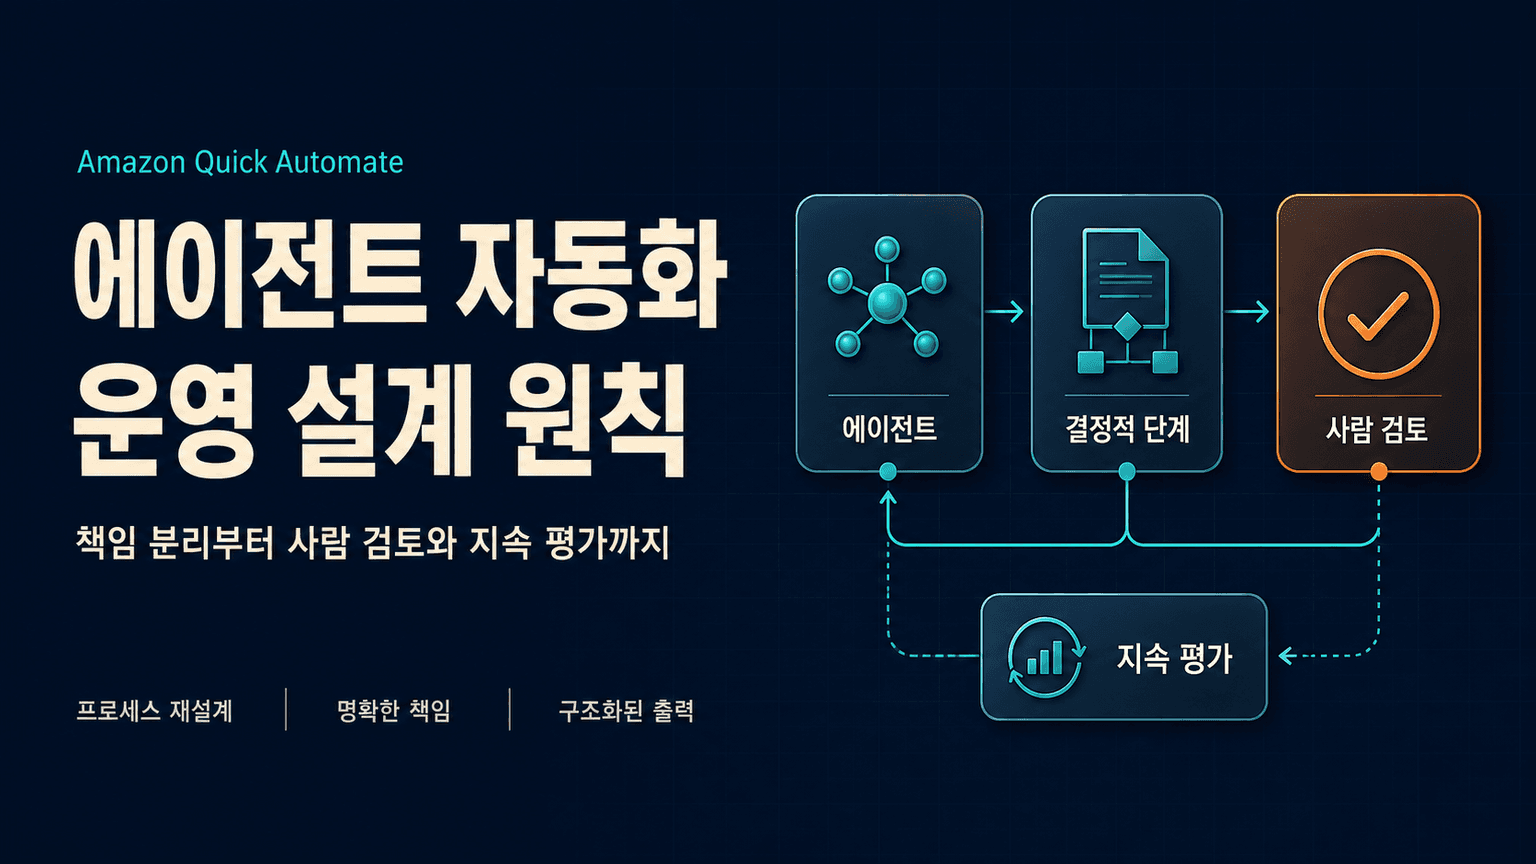
AEM은 주석이 달린 대화를 입력받아 턴별 점수와 실패 원인을 산출하고, 이를 분해 가능한 하나의 점수로 합성하는 반복 가능한 평가 파이프라인 안에서 동작한다. 원문은 이 흐름을 개발과 운영 전반에서 활용하는 구조로 소개하며, 전체 점수와 함께 각 턴의 실패가 어디에서 비롯됐는지를 연결해 볼 수 있다는 점을 강조한다. 앞서 나온 5턴 판매 보고서 사례의 예시 출력에는 success_rate가 0.2, test_pass가 false, first_failure_turn이 2로 제시돼 있으며, 이는 실측 성능 보고가 아니라 설명용 결과로 명시돼 있다. 다만 제공된 source_body는 이 JSON 예시의 다음 필드가 시작되는 부분에서 끊기므로, 그 뒤의 출력 내용이나 추가 구현·실험 결과는 확인할 수 없으며 이 정리도 확인 가능한 파이프라인 설명과 수치까지만 반영한다.
🧾 핵심 주장 / 시사점
- AEM의 진단 가치는 전체 점수뿐 아니라 사실 일치성·완전성의 구분과 턴별 실패 귀속을 함께 보존하는 데 있다. 같은 통과 비율이라도 실패한 차원과 발생 위치에 따라 수정 대상은 달라질 수 있다.
- prior_action_failed는 실패한 턴의 수와 독립적인 근본 원인의 수를 구분하게 한다. 후속 턴이 앞선 실패의 출력 때문에만 실패했는지 판단하는 의존 관계 분석이 이 구분의 핵심이다.
- 의미 비교의 임계값과 전체 점수의 합성 규칙은 모두 조정 가능한 선택지다. 따라서 AEM 점수를 해석할 때는 어떤 엄격도와 합성 방식으로 계산했는지도 함께 고려해야 한다.
✅ 액션 아이템
- 응답 턴과 행동 턴의 정확성을 사실 일치성·완전성으로 나누고, 행동 턴의 도구·작업 선택도 함께 점검.
- 의미 비교 임계값 0.5를 출발점으로 삼아 도메인의 오탐·미탐 허용 수준에 맞는 값을 검토.
- prior_action_failed와 근본 원인을 구분해, 5턴 판매 보고서 예시의 2턴처럼 오류가 시작된 턴을 우선 수정 대상으로 식별.
❓ 열린 질문
- 사실 일치성과 완전성 중 현재 다중 턴 에이전트의 정확성 저하를 더 크게 유발하는 차원은 무엇인가?
- 도메인의 오탐·미탐 허용 수준을 고려할 때 의미 비교 임계값 0.5를 어떻게 조정해야 하는가?
- prior_action_failed를 부여할 때 후속 턴의 실패가 앞선 실패 턴의 출력 때문에만 발생했는지 어떻게 판단할 것인가?