이 태그와 연결된 문서를 한곳에서 모아보고, 함께 자주 등장하는 연관 태그까지 이어서 탐색할 수 있습니다.
연관 태그
총 682건 중 649-672건
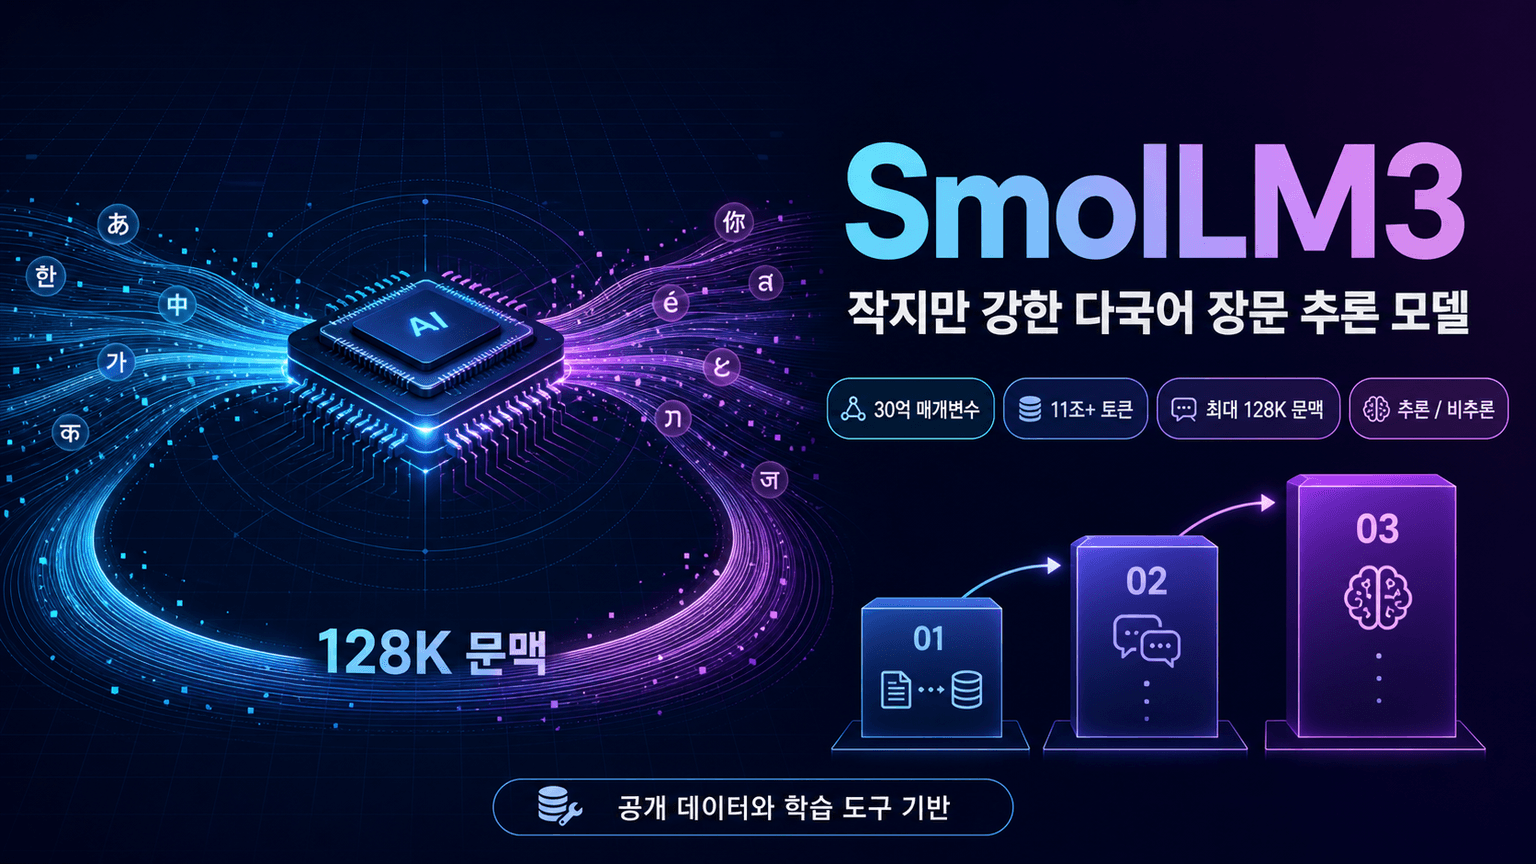
SmolLM3는 공개 데이터와 학습 도구로 구축한 30억 매개변수 모델로, 11조 개가 넘는 토큰의 단계별 사전학습과 장문·추론 중간학습을 결합해 다국어, 최대 128K 문맥, 추론·비추론 이중 모드를 지원한다.
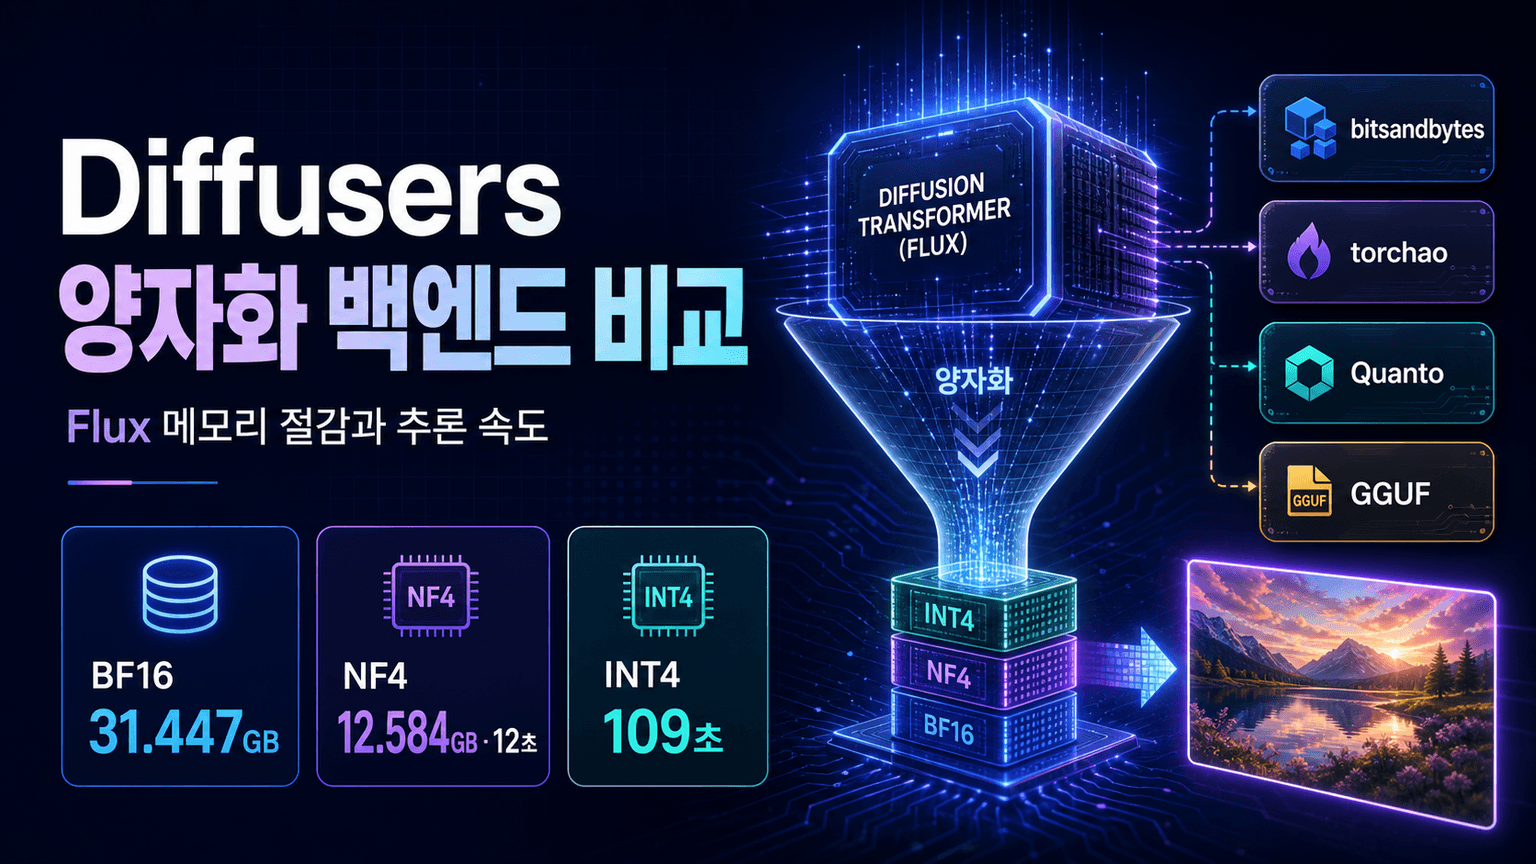
Diffusers는 Flux의 핵심 구성 요소를 여러 백엔드로 양자화해 이미지 품질을 크게 훼손하지 않으면서 메모리 사용량을 줄일 수 있으며, 정밀도와 백엔드에 따라 속도·메모리·사용 편의성의 차이가 뚜렷하다.
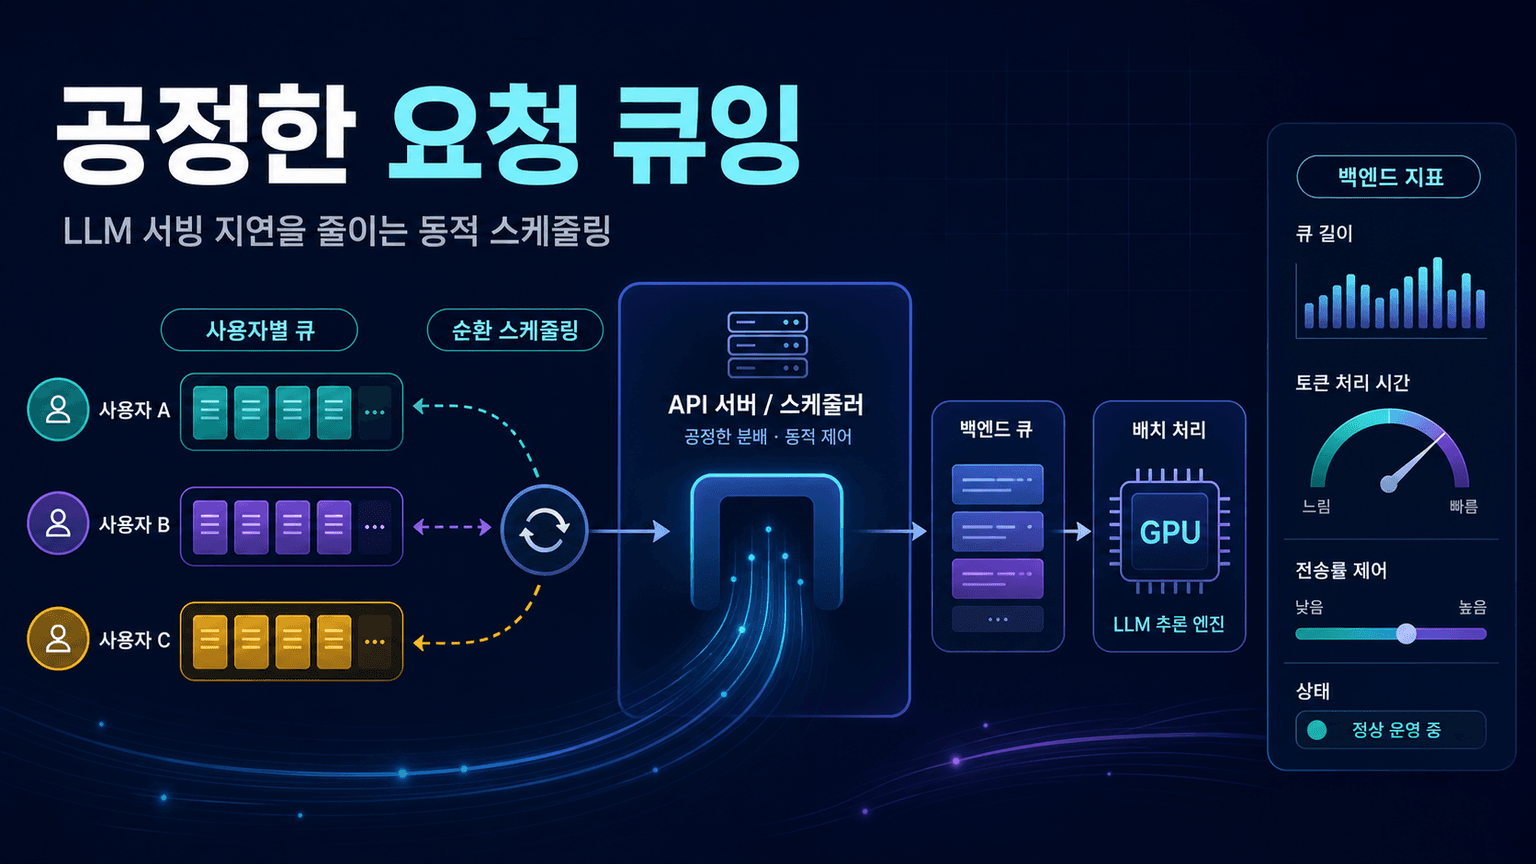
다중 사용자 환경의 대규모 언어 모델 서빙에서는 사용자별 공정 스케줄링과 백엔드 지표 기반의 동적 요청 제어를 결합해야 지연 시간을 줄이면서 그래픽 처리 장치 활용률을 유지할 수 있다.
Hugging Face와 NVIDIA는 연구기관과 기업이 필요한 시점·규모·기간에 맞춰 대규모 GPU 클러스터를 요청하고 학습 작업에 활용할 수 있는 Training Cluster as a Service를 발표했다.
생성형 AI는 빠르게 커지고 있지만, 지금 쓰이는 사용자 수·토큰 수·성장 비교 지표만으로는 실제 제품 가치와 사용 방식, 시장 변화를 제대로 설명하기 어렵다는 글입니다.
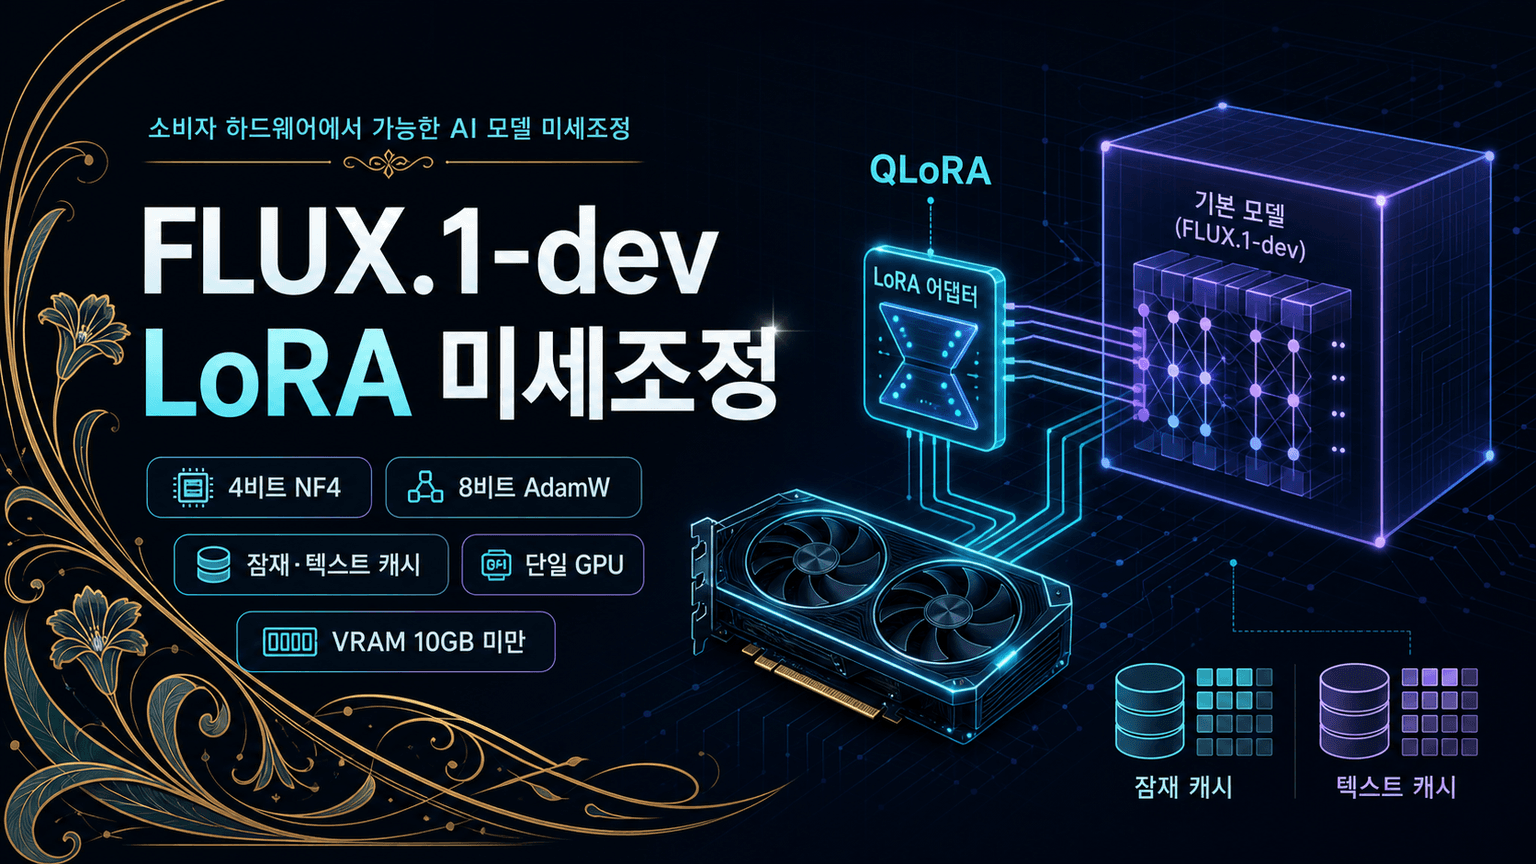
FLUX.1 dev의 트랜스포머를 4비트로 양자화하고 LoRA, 8비트 옵티마이저, 체크포인팅, 잠재 표현·텍스트 임베딩 캐시를 결합해 단일 GPU에서 약 10GB 미만의 VRAM으로 미세 조정하는 방법을 설명한다.
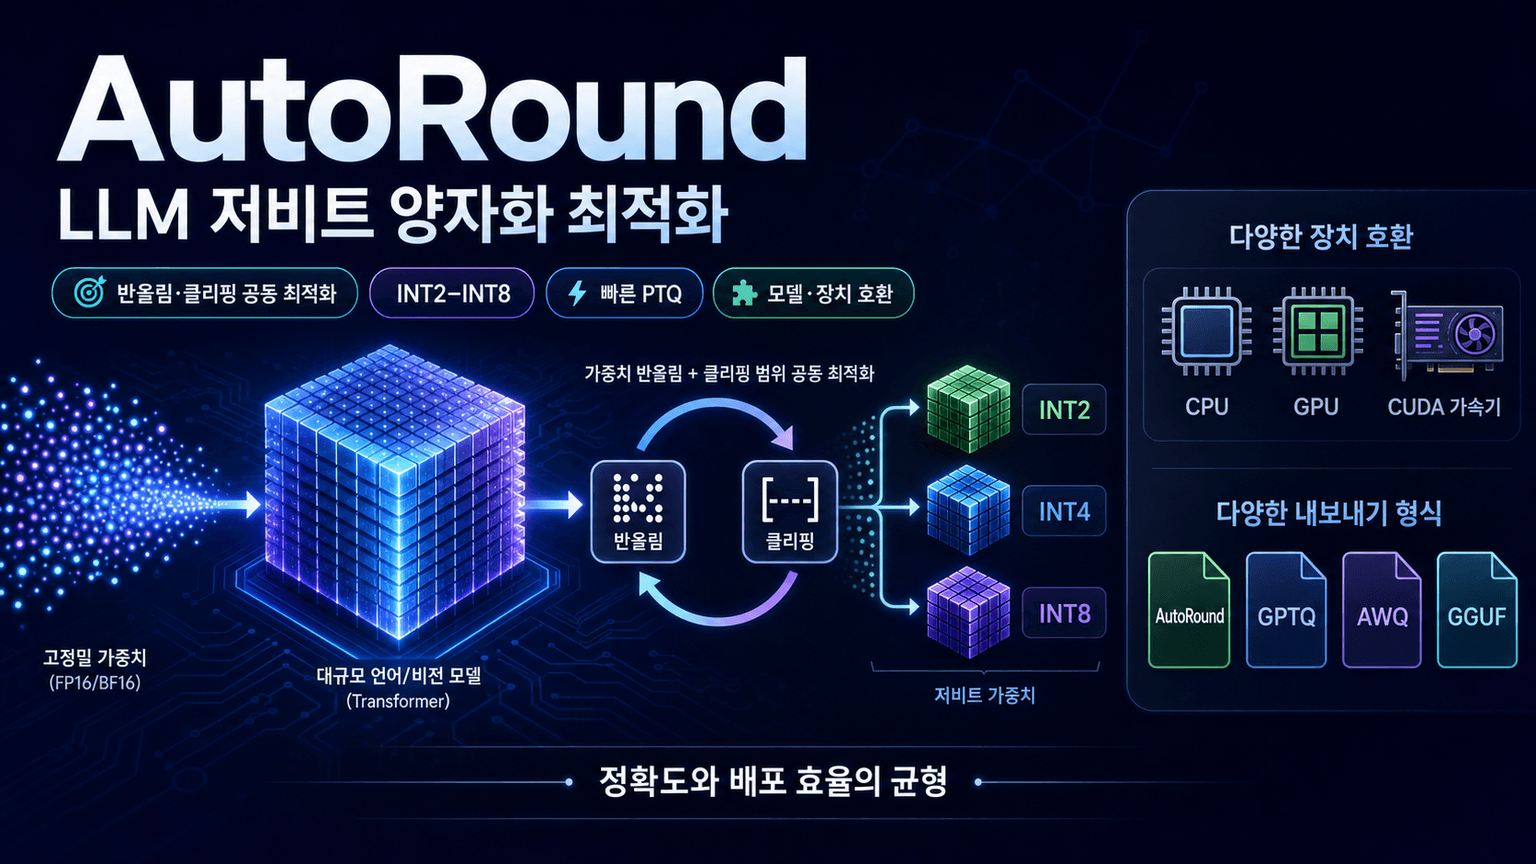
AutoRound는 가중치 반올림과 클리핑 범위를 함께 최적화해 낮은 비트에서도 정확도를 유지하면서 빠른 양자화와 폭넓은 모델·장치·출력 형식 호환성을 제공하는 인텔의 가중치 전용 학습 후 양자화 도구다.
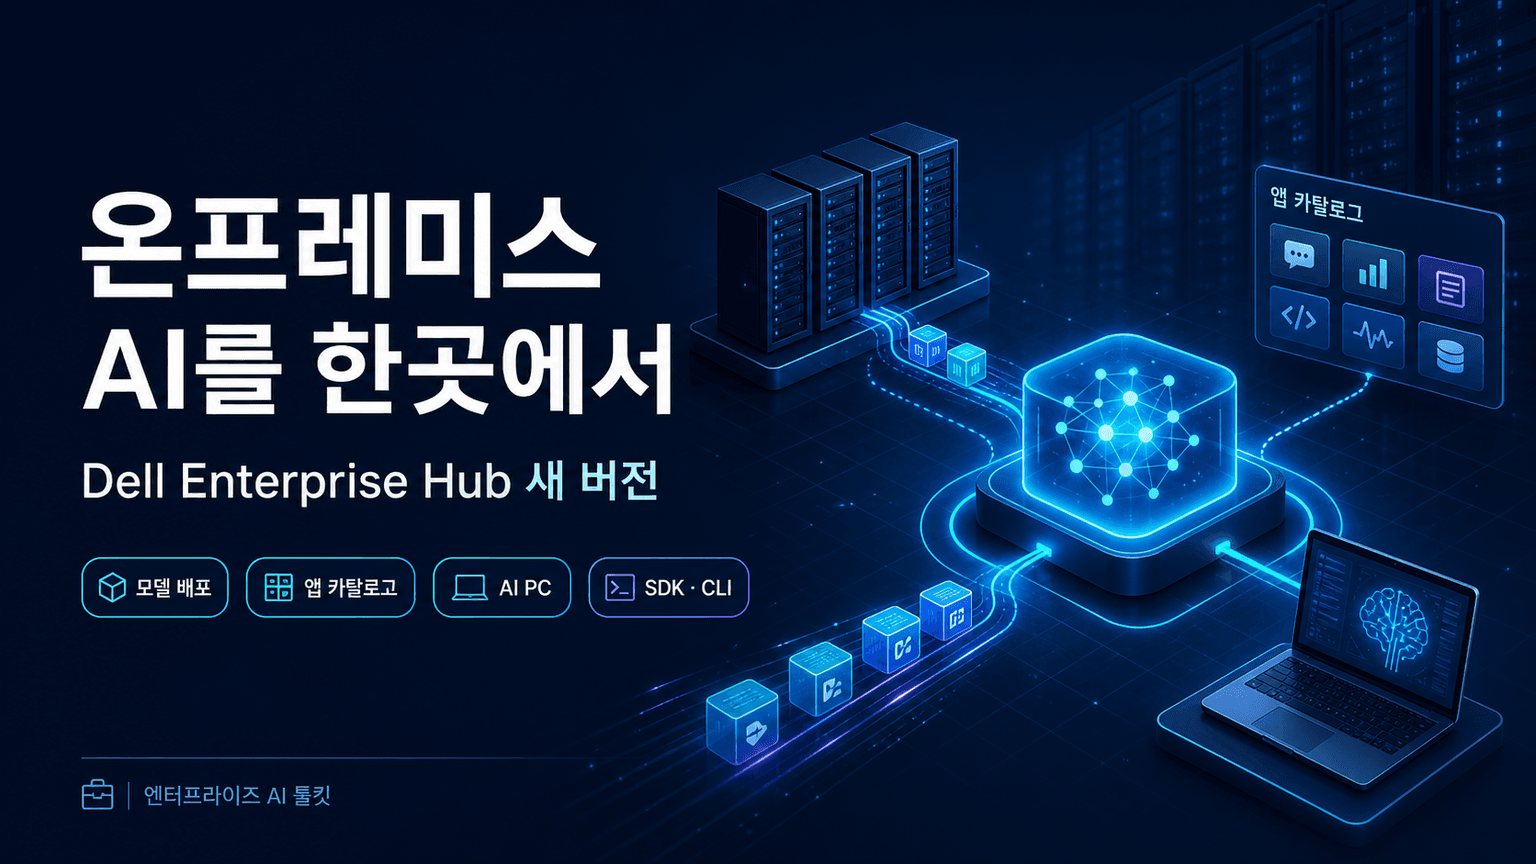
Dell Enterprise Hub의 새 버전은 Dell AI 서버와 AI PC에서 모델, 애플리케이션, 온디바이스 AI, SDK/CLI를 온프레미스로 빠르게 배포하도록 묶은 엔터프라이즈 AI 툴킷으로 소개된다.
허깅페이스는 vLLM과 GPU 최적화를 적용한 새로운 Whisper 추론 엔드포인트를 공개해 기존 버전 대비 최대 8배 빠른 처리 성능을 제공하면서도 전사 품질을 유지했다.
허깅페이스는 오픈소스 휴머노이드 로봇 기업 폴렌 로보틱스를 인수하고, 르로봇 생태계와 리치 2를 결합해 개방형 로봇 소프트웨어·하드웨어를 직접 제공하기 시작했다.
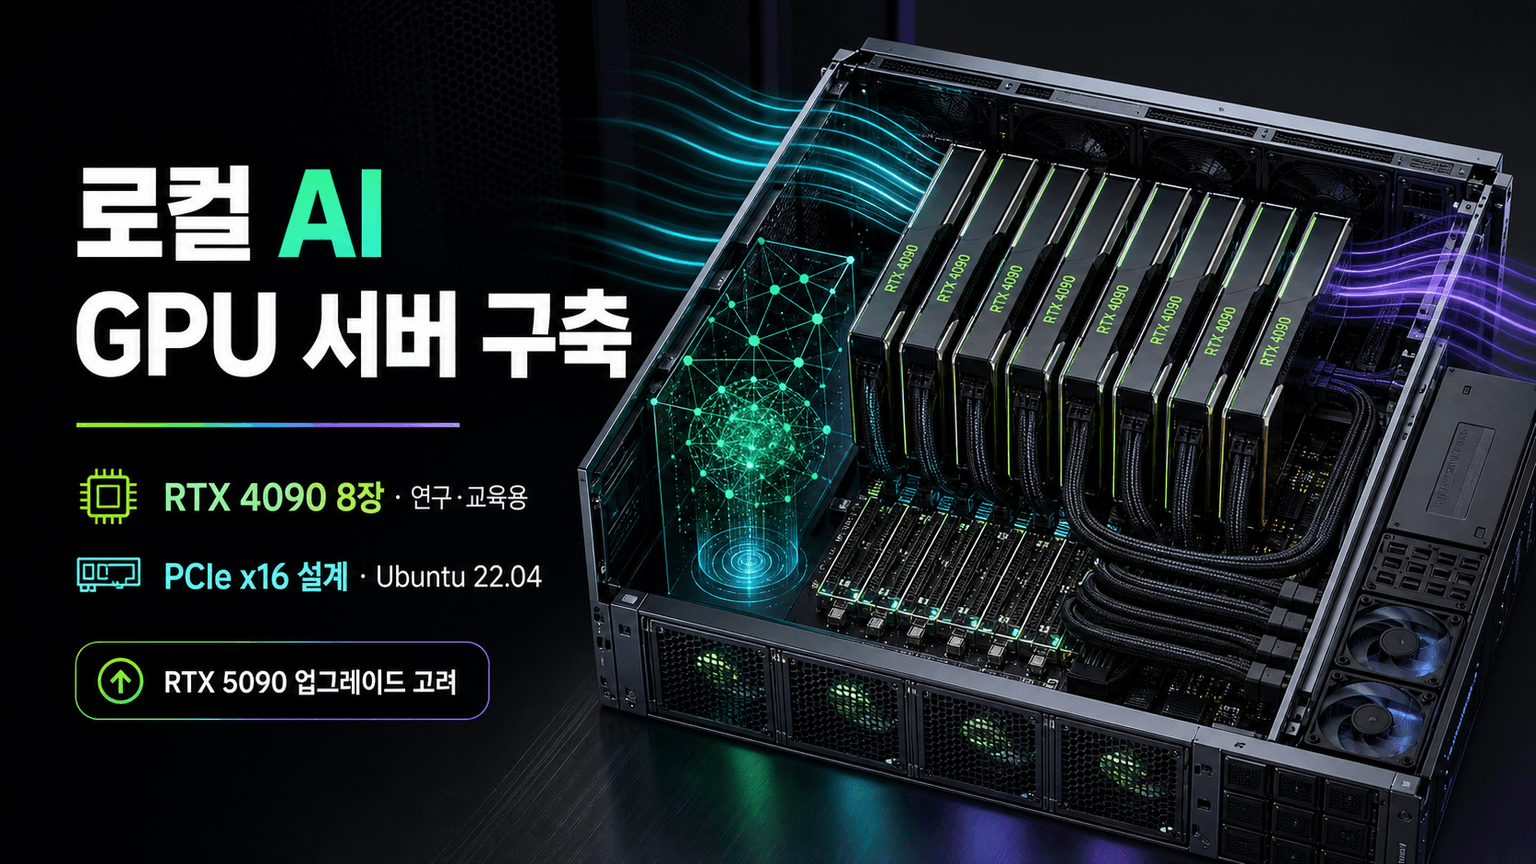
이 글은 RTX 4090 8장을 ASUS ESC8000A E12P 서버에 장착해 연구·교육용 로컬 AI GPU 서버를 구성한 이유와 하드웨어 설계, 조립 절차를 설명한다.
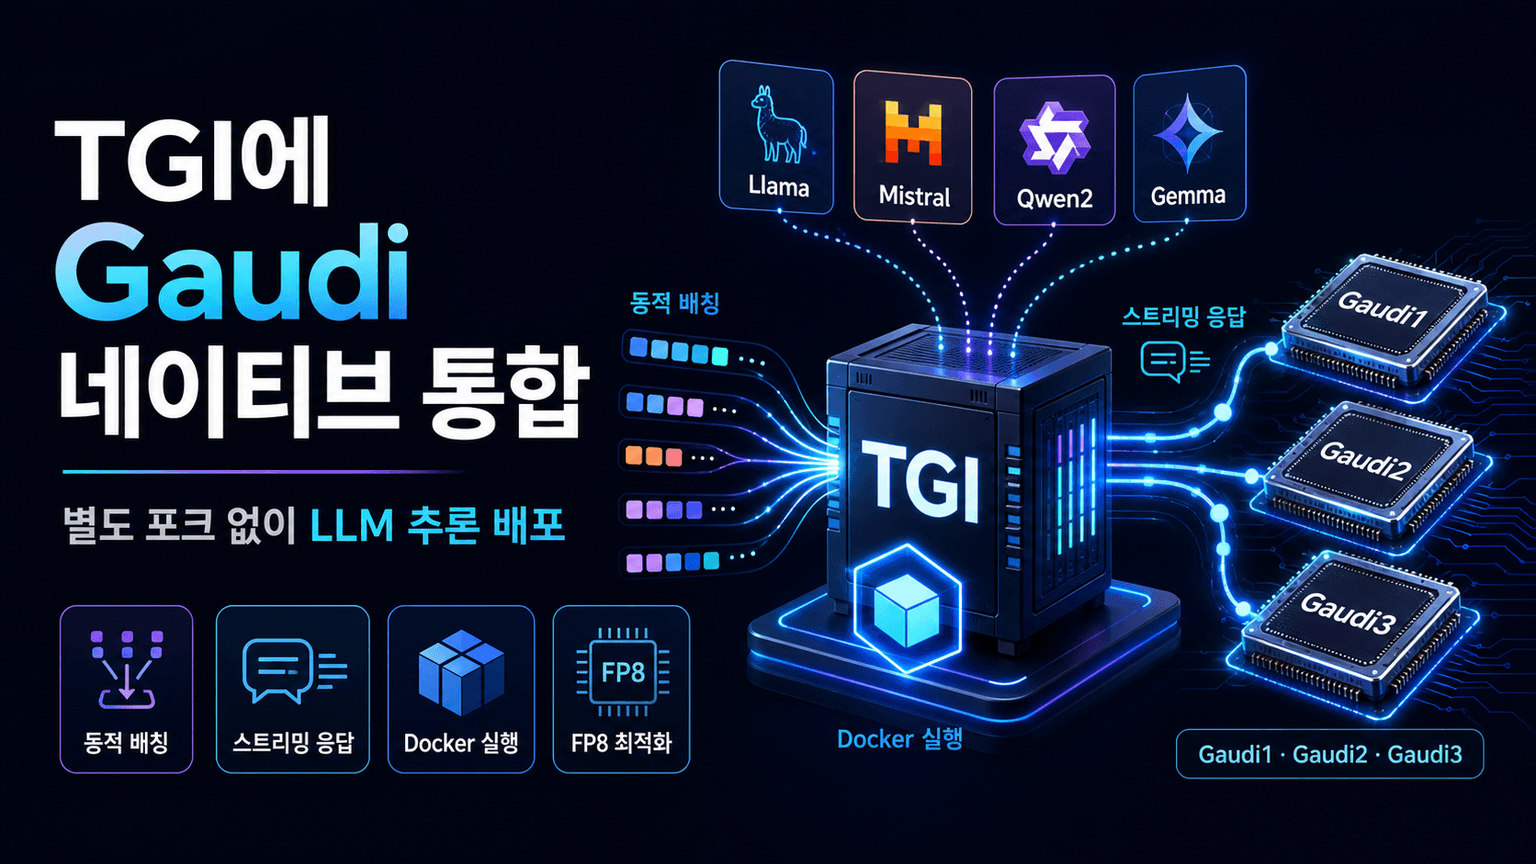
Hugging Face는 Intel Gaudi 하드웨어 지원을 Text Generation Inference(TGI) 본체에 네이티브로 통합해, 별도 포크 없이 Gaudi 기반 LLM 추론 배포를 사용할 수 있게 했습니다.
Hugging Face와 FriendliAI는 Hugging Face Hub의 “Deploy this model” 버튼 안에 FriendliAI Endpoints를 통합해 생성형 AI 모델 배포와 추론 운영을 더 빠르고 간단하게 만들었다.
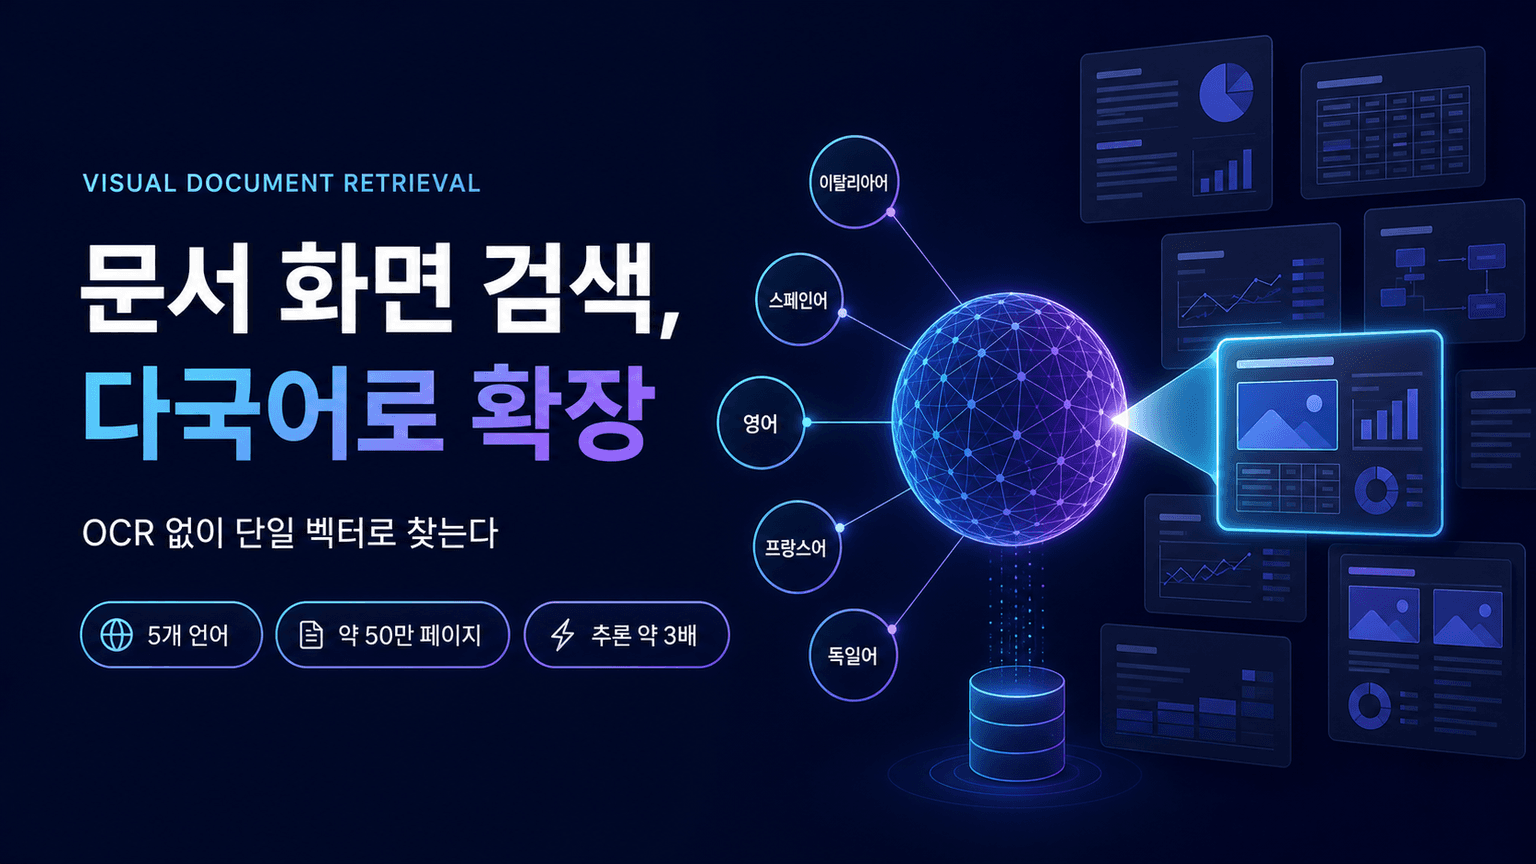
LlamaIndex는 문서 화면을 OCR 없이 단일 벡터로 표현하는 다국어 검색 모델과 약 50만 건 규모의 공개 학습 데이터를 선보였으며, 검색 성능·추론 속도·언어 간 검색·저장 효율을 함께 개선했다.
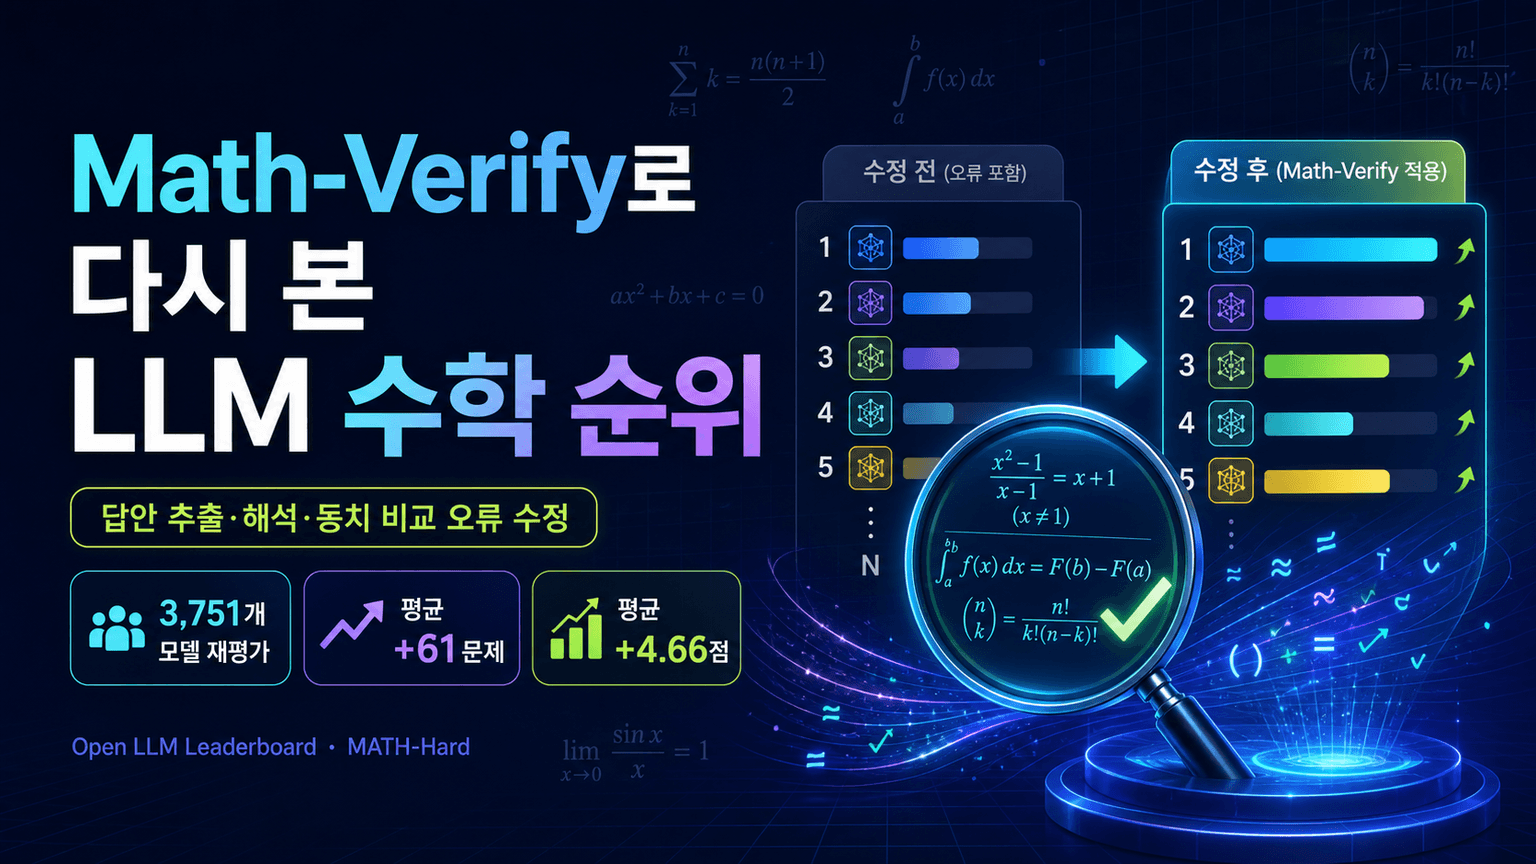
Math Verify로 수학 답안의 추출·해석·동치 비교 오류를 바로잡아 Open LLM Leaderboard의 3,751개 모델을 재평가한 결과, 점수와 순위가 대폭 달라졌다.
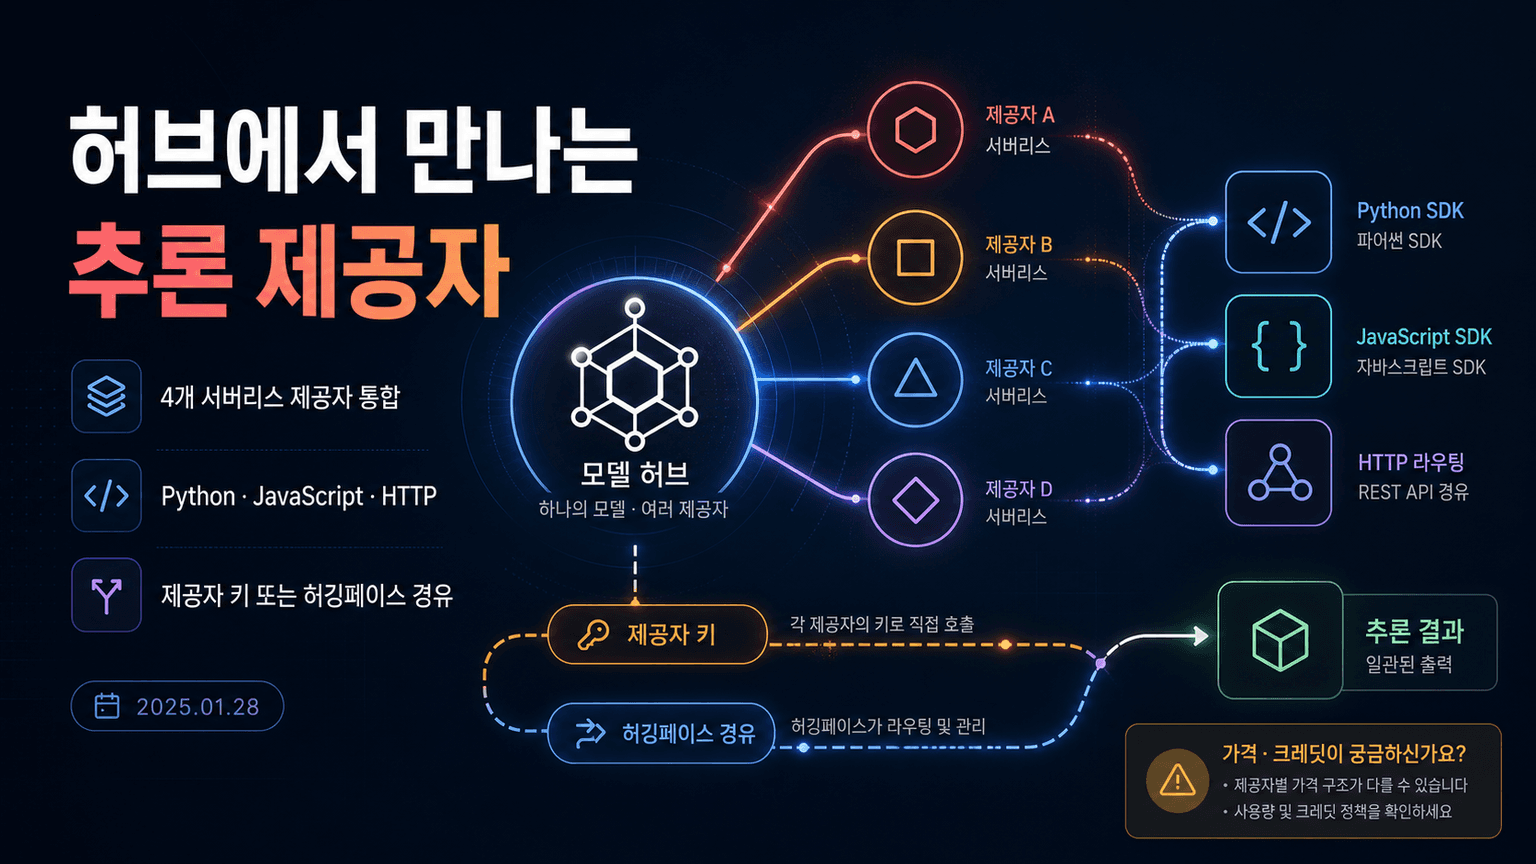
허깅페이스는 팔, 리플리케이트, 삼바노바, 투게더 에이아이의 서버리스 추론을 허브 모델 페이지와 파이썬·자바스크립트 SDK, HTTP 라우터에 통합하고, 자체 제공자 키와 허깅페이스 경유 방식 중 하나를 선택할 수 있게 했다.
Hugging Face는 TGI를 단일 프런트엔드로 유지하면서 TensorRT LLM, vLLM, llama.cpp 등 다양한 추론 엔진을 백엔드로 연결할 수 있는 멀티 백엔드 아키텍처를 소개했다.
지난 1년간 비전 언어 모델은 다중 모달 입출력, 추론, 소형화, 전문가 혼합 구조, 로봇 행동 제어와 전통적 시각 작업의 통합을 중심으로 더 강력하고 효율적인 형태로 발전했다.
이 글은 언어 모델의 다음 토큰 선택 과정에서 로짓을 직접 조정해 길이, 문맥 유지, 필수 문구, 선택형 답변 같은 생성 제약을 제어하는 방법을 NVIDIA의 LogitsProcessorZoo와 Hugging Face 생성 API 예시로 설명한다.
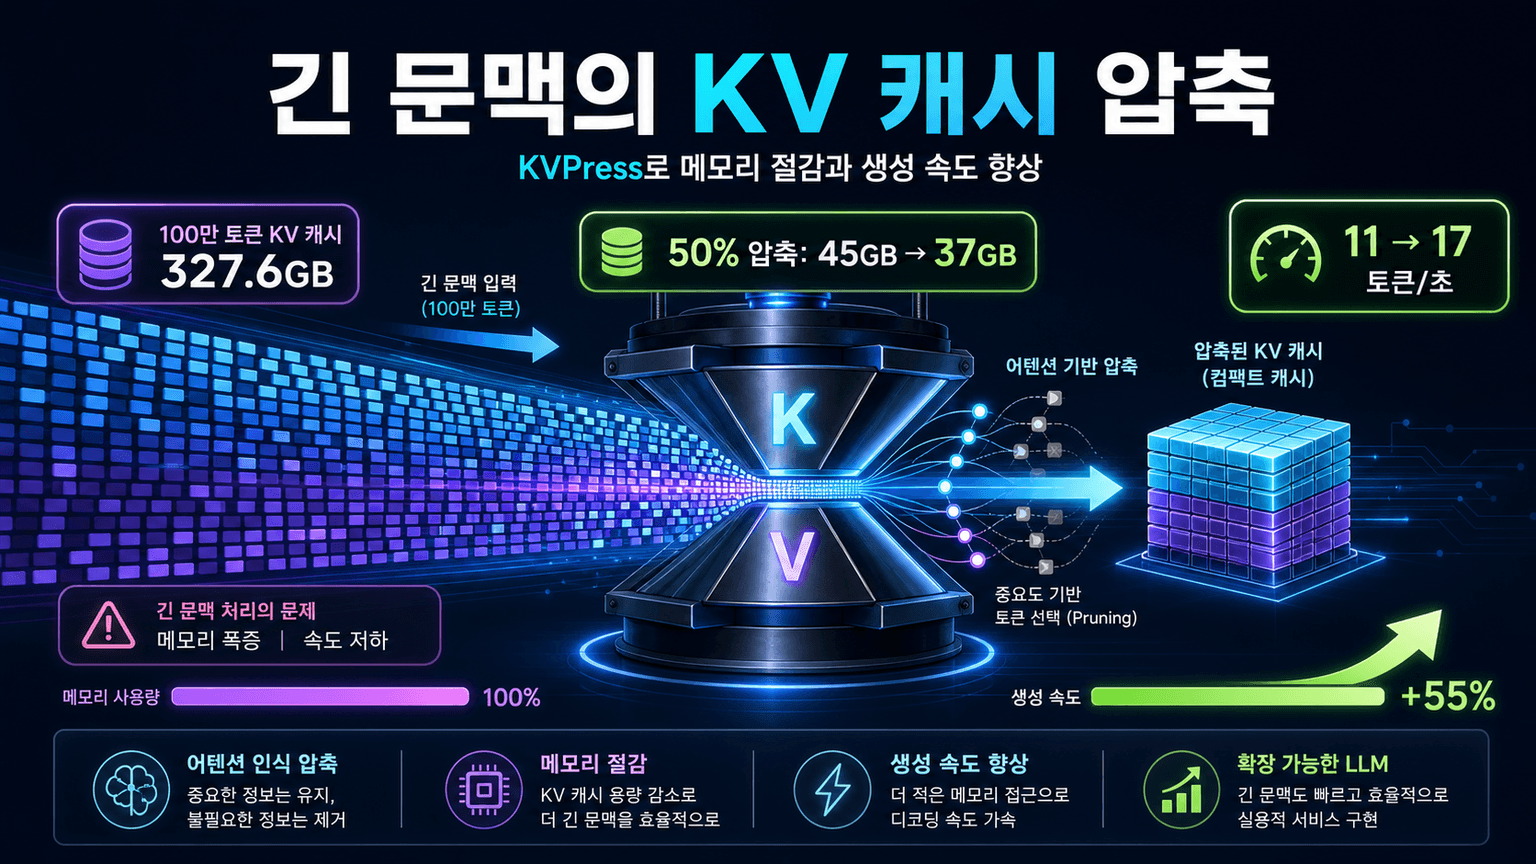
KVPress는 긴 문맥에서 선형으로 증가하는 키·값 캐시를 중요도 기반으로 압축해 메모리 사용량을 줄이고 생성 속도를 높이는 모듈형 도구다.
오픈AI는 일론 머스크가 영리 구조 자체에 반대했던 것이 아니라 2017년 영리 전환을 추진하면서 지분 과반, 절대적 통제권, 최고경영자 지위를 요구했고, 그 조건이 받아들여지지 않자 회사를 떠났다고 주장한다.
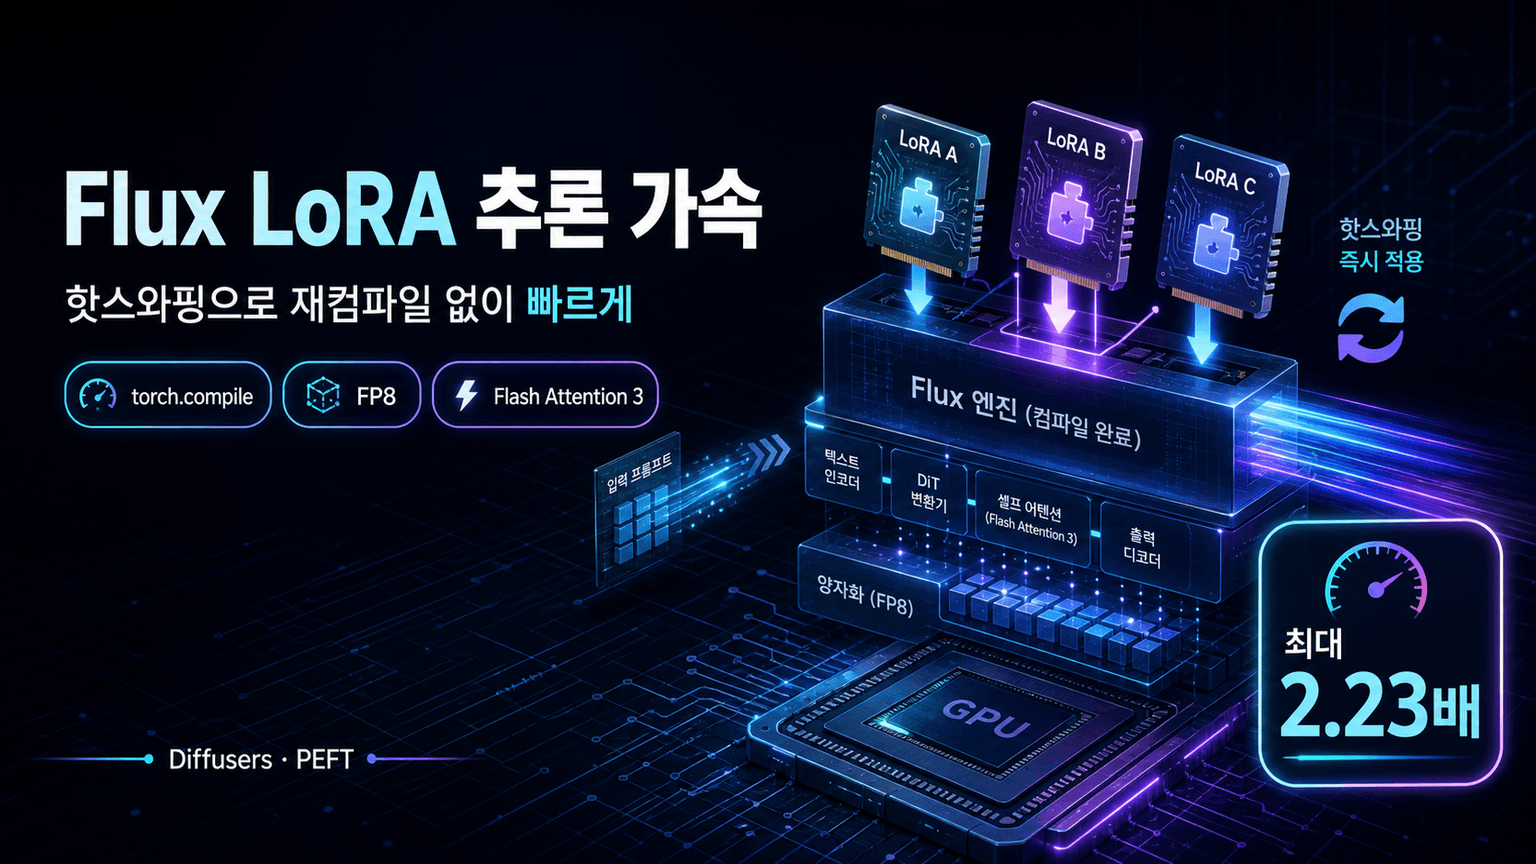
Diffusers와 PEFT의 LoRA 핫스와핑, torch.compile, FP8 양자화, Flash Attention 3를 조합해 Flux.1 Dev의 재컴파일 문제를 피하고 고성능 GPU에서 약 2.23배, RTX 4090에서 약 2.04배 빠른 LoRA 추론을 구현한 최적화 방법을 설명한다.
OpenAI o1 계열은 강화학습 기반의 숙고형 추론으로 안전 정책 준수와 탈옥 공격 저항성을 높였지만, 향상된 지능이 새로운 위험을 만들 수 있어 지속적인 정렬·스트레스 테스트·위험 관리가 필요하다.
EU AI Act는 오픈소스 AI에도 적용될 수 있으며, 개발자는 시스템·모델의 위험 수준과 공개 방식에 따라 투명성, 학습 데이터 요약, 저작권 및 개인정보 보호 의무를 준비해야 한다.