이 작성자와 연결된 문서를 한곳에서 모아보고, 관련 태그를 따라 같은 맥락의 문서를 이어서 탐색할 수 있습니다.
자주 함께 등장한 태그
총 10건 중 1-10건
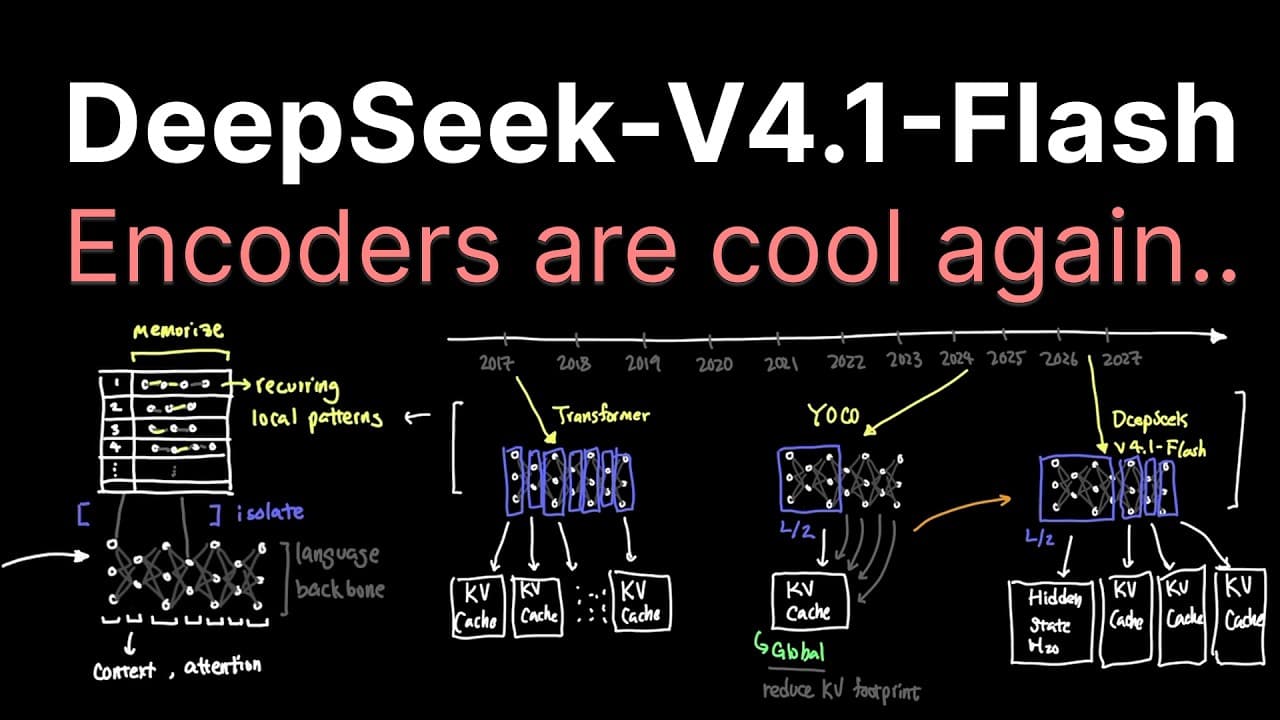
DeepSeek V4.1 Flash는 반복 패턴 저장, 입력 처리 분리, KV 캐시 재사용, 메모리 이동 최적화를 결합한 정교한 모델로 소개되지만, 토큰 효율과 지능의 개선은 과제로 남는다.
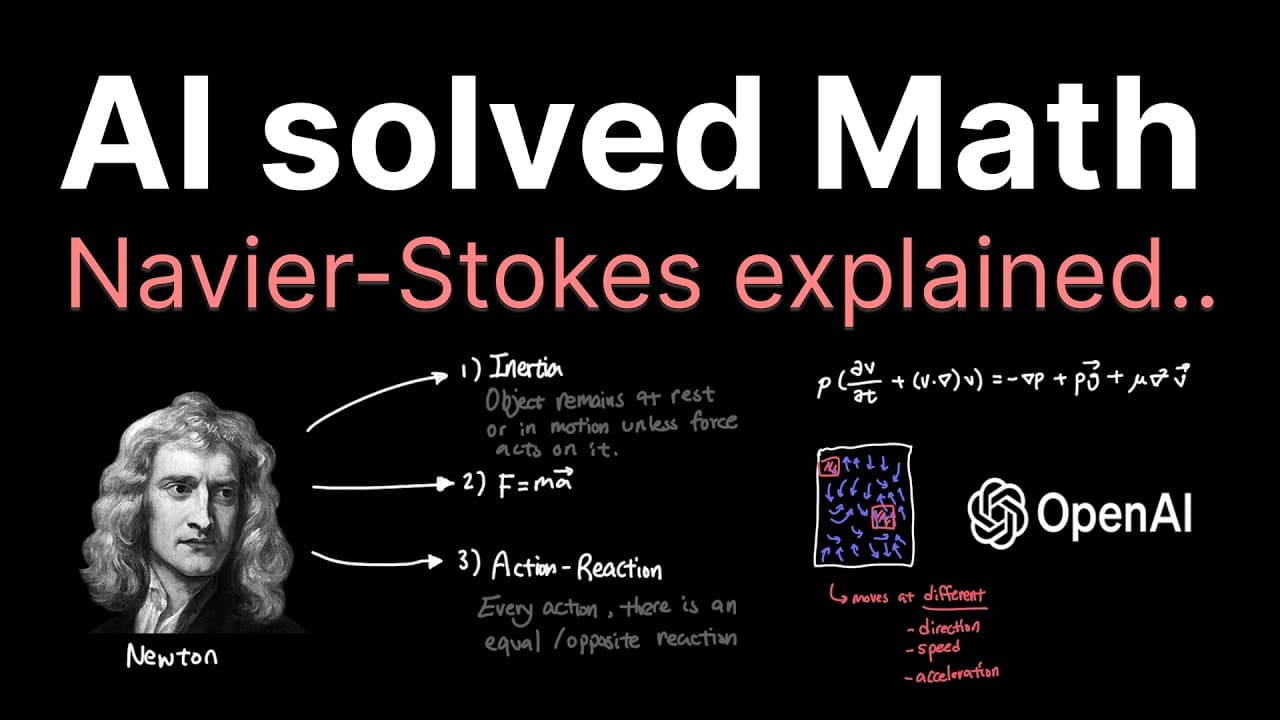
OpenAI solving Navier Stokes explained..를 중심으로, 뉴턴의 제2법칙을 유체에 적용하면 위치마다 다른 운동을 고려해야 한다. 나비에–스토크스 방정식은 압력·점성·중력 등이 유체의 밀도를 핵심 판단 포인트로 압축 정리한다.
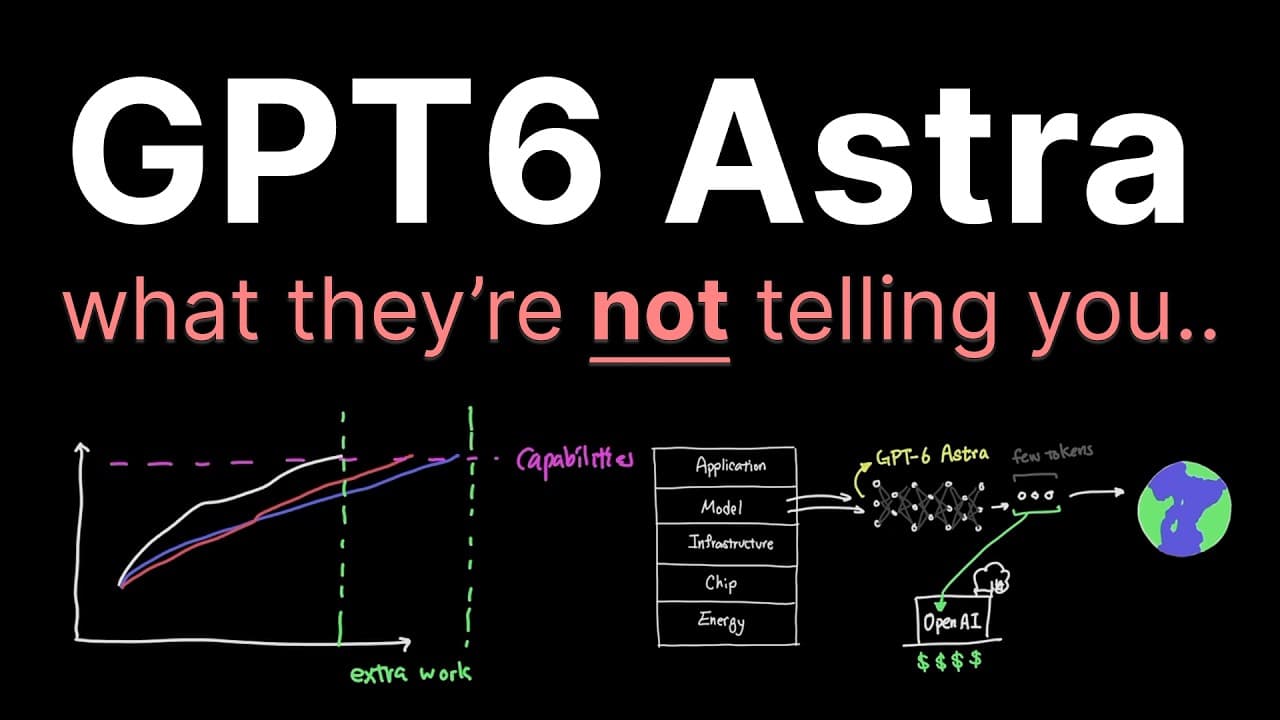
GPT 6 Astra의 의미를 분석하려면 벤치마크 최고점뿐 아니라 평가 환경, 토큰 효율, 실제 비용과 업무 유용성을 함께 봐야 한다.
Fable 5.1은 벤치마크 선두라는 이유만으로 최고의 선택이 되지는 않으며, 실제 가치는 하네스 조합과 작업 비용, 구독 한도까지 함께 따져야 한다.
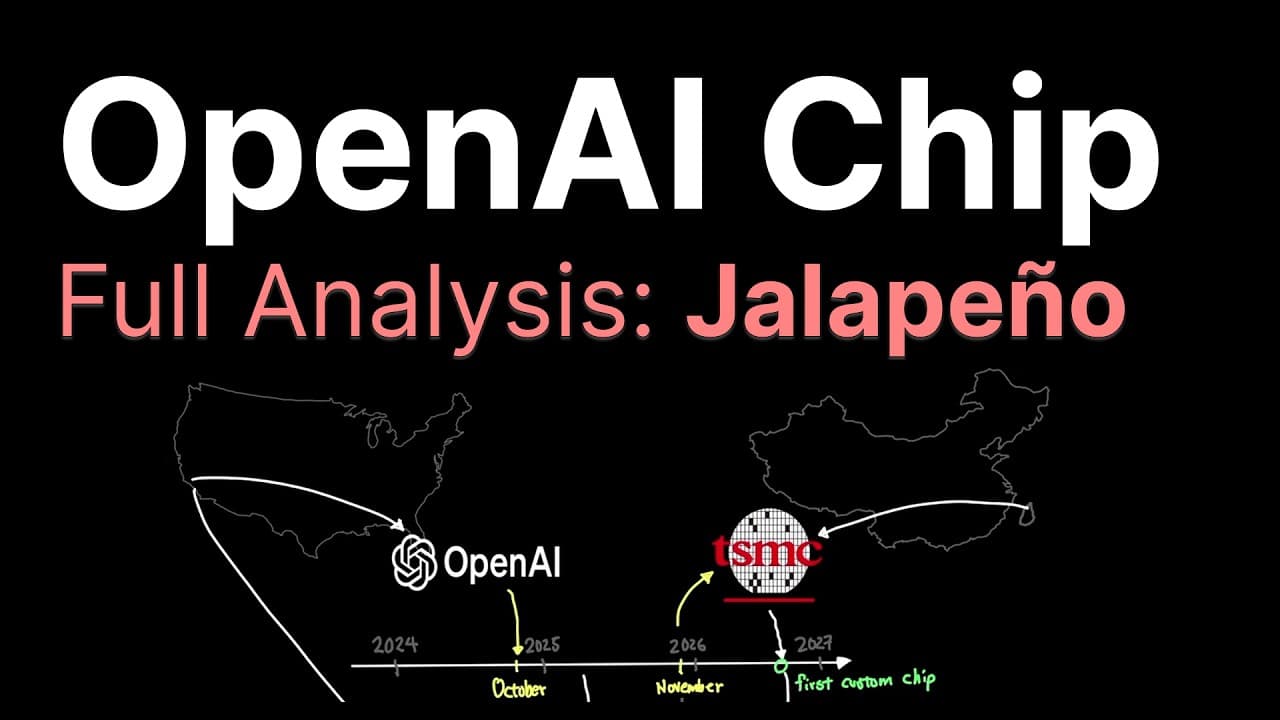
OpenAI Jalapeno는 추론 처리량과 전력 효율에 집중한 맞춤형 ASIC이지만, 제한된 예비 벤치마크만으로 Nvidia의 범용 GPU 지위를 대체했다고 판단하기는 이릅니다.
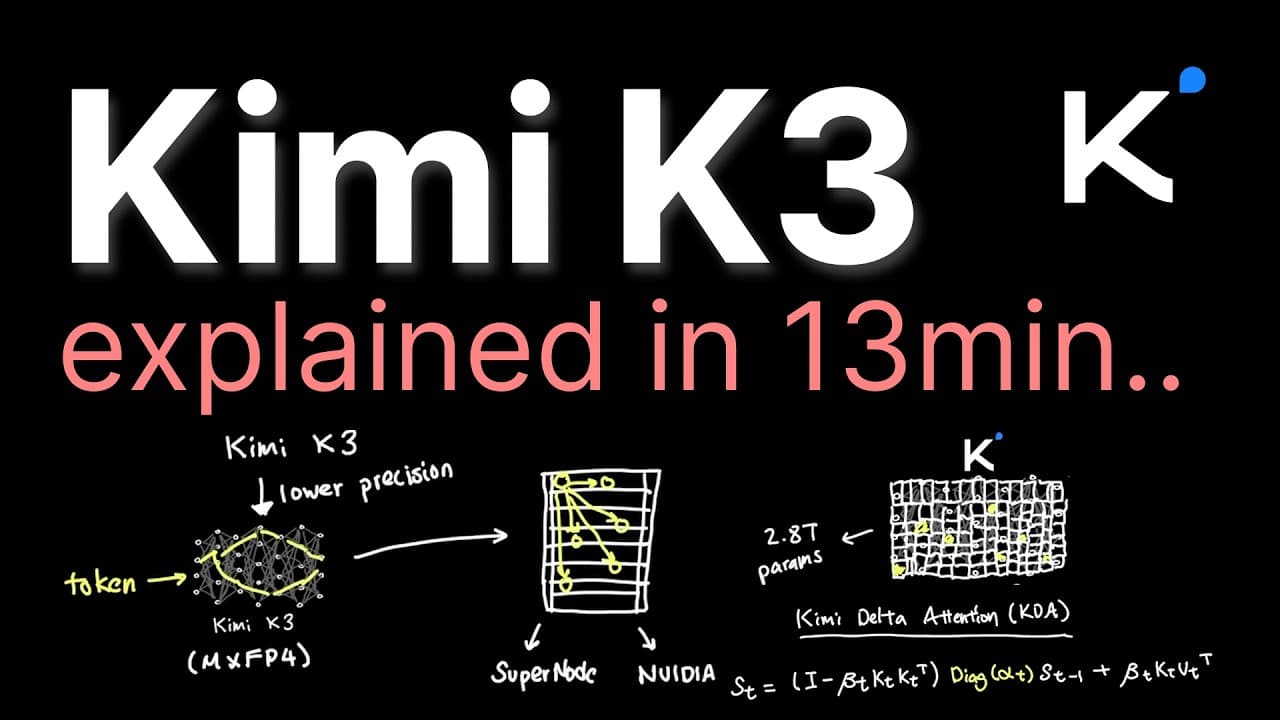
Kimi K3는 초희소 MoE, Kimi Delta Attention, Attention Residual을 결합해 GPU 통신량과 장문 추론 비용을 줄이는 효율 중심의 거대 AI 모델 아키텍처다.
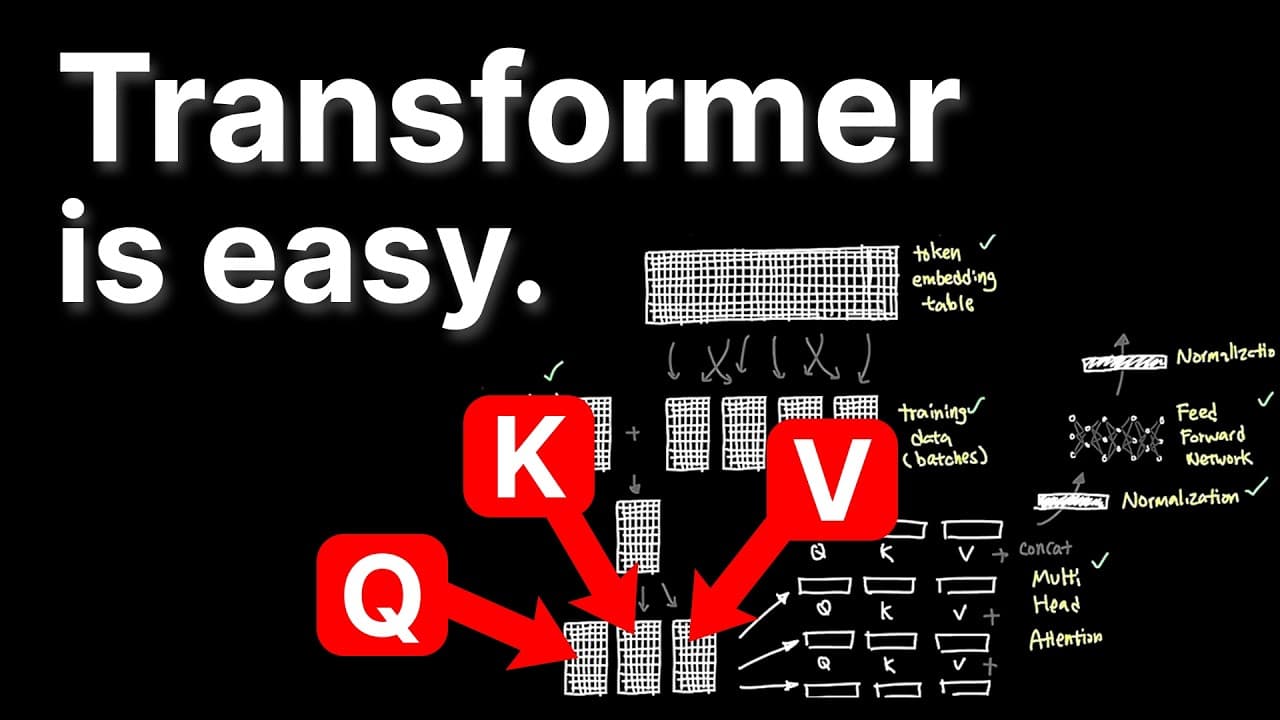
Transformers는 단순히 다음 문자를 찍는 장치가 아니라, 토큰의 의미·순서·관계·여러 관점의 어텐션을 결합해 다음 토큰을 예측하도록 학습되는 GPT의 핵심 구조다.
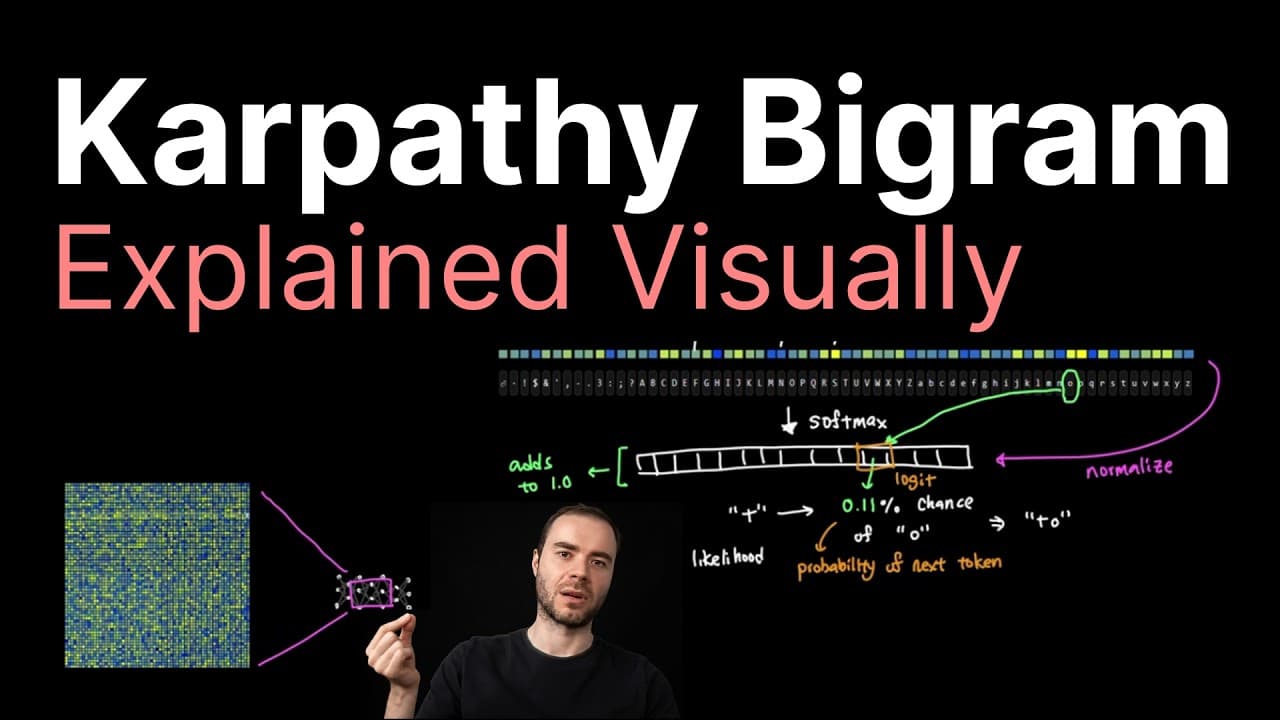
Karpathy Bigram은 GPT로 가기 전, 다음 토큰 예측과 손실 최소화가 어떻게 언어 모델 학습의 기본 원리가 되는지 보여주는 가장 단순한 출발점이다.
Nemotron 3는 NVIDIA 하드웨어 생태계에 맞춰 long context, MoE 대역폭, token 생성 병목을 동시에 줄이려는 구조적 최적화 모델로 소개된다.
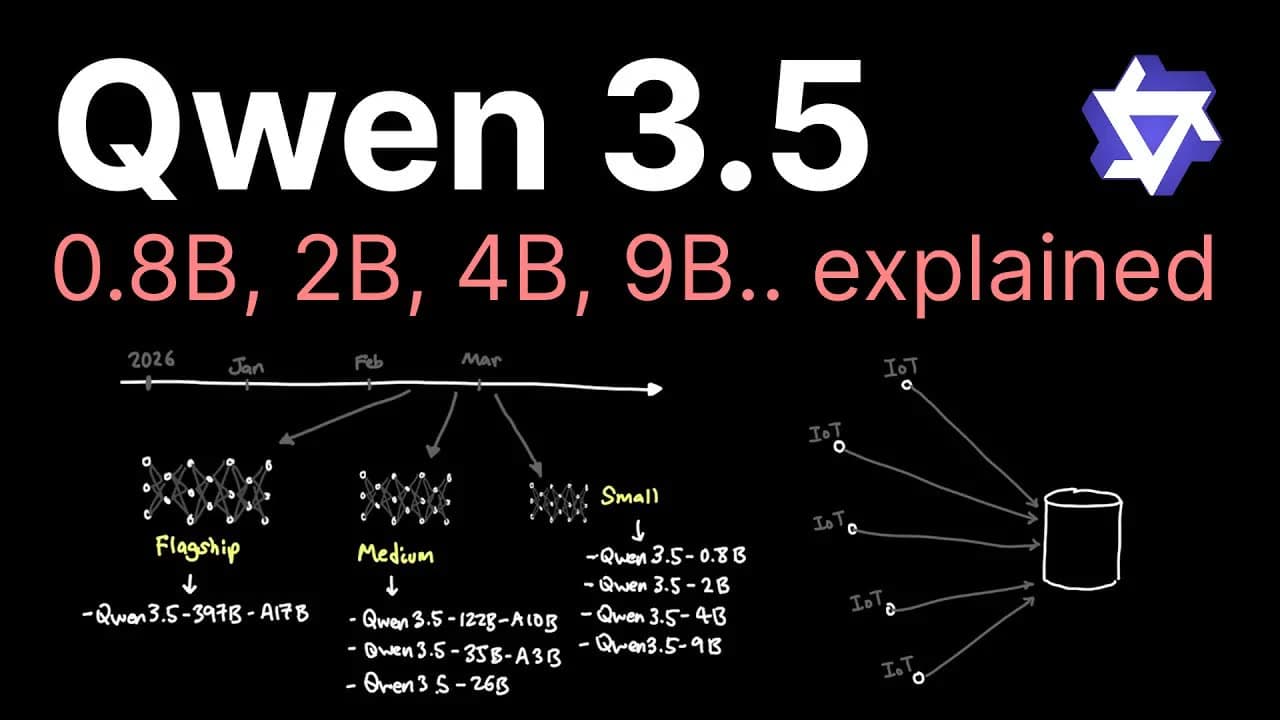
Qwen 3.5 소형 모델의 핵심 가치는 경량화 자체가 아니라 제한된 하드웨어에서 더 높은 지능을 실용적으로 제공해, 오프라인·프라이버시·엣지 배치 시장을 실제 사업 기회로 바꾸는 데 있습니다. 앞으로 경쟁 우위는 가장 큰 모델을 가진 곳보다, 가장 작은 자원 조건에서 가장 쓸 만한 성능을 내는 곳에서 더 자주 나올 가능성이 큽니다.