Trajectories now in LangSmith: A readable view of every agent session
Quick Summary
LangSmith의 Trajectories는 에이전트 세션의 메시지와 행동을 시간순으로 보여주어 문제 지점 파악, 전문가 검토, 온라인 평가와 학습 데이터 활용을 돕는다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
LangSmith의 Trajectories는 에이전트 세션의 메시지와 행동을 시간순으로 보여주어 문제 지점 파악, 전문가 검토, 온라인 평가와 학습 데이터 활용을 돕는다.
📌 핵심 요약
- 2026년 9월 24일 발표된 LangSmith의 Trajectories는 주 에이전트와 하위 에이전트에 걸친 사람·AI·도구의 메시지를 처음 등장한 순서로 모아 각 메시지를 한 번씩 보여주며, 미국의 모든 요금제에서 제공된다.
- Trajectories는 여러 턴의 세션을 연결한 thread의 trace에서 중첩 실행 구조를 덜어내 행동 경로를 보여준다. 사용자는 문제 행동을 찾은 뒤 원본 trace에서 입력·출력·실행 시간·재시도 등의 세부 정보를 확인할 수 있다.
- LangChain, LangGraph, Deep Agents뿐 아니라 OpenAI와 Claude 같은 에이전트 SDK, Codex·Claude Code·Cursor 같은 코딩 에이전트에서 전송한 trace도 기본 지원한다.
- 분야별 전문가(SMEs)는 annotation queues에서 읽기 쉬운 세션을 검토하고 행동에 점수를 부여하거나 문제를 표시할 수 있다. 온라인 평가기는 중복 메시지를 제거한 세션 경로를 평가하며, 낮은 점수의 세션을 사람의 검토나 향후 테스트용 데이터셋으로 연결할 수 있다.
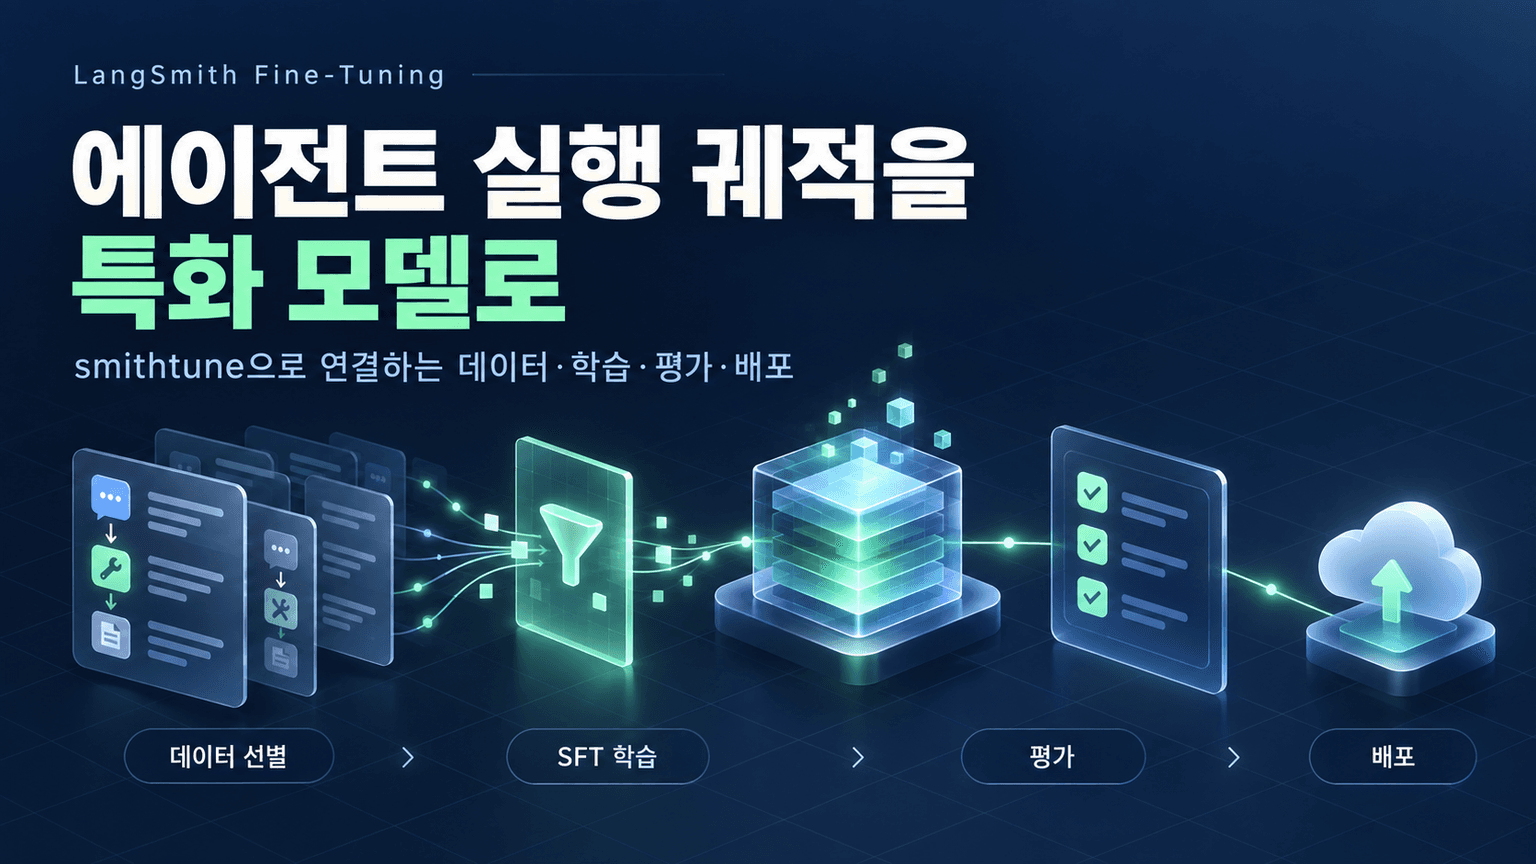
- Trajectories는 시스템 프롬프트, 사용자 메시지, 에이전트 응답, 도구 호출과 출력을 포함한다. 고품질 세션을 데이터셋에 저장하고 지도 미세조정 워크플로용으로 내보내 운영 중 나타난 행동을 학습 예시로 활용할 수 있다.
🧩 주요 포인트
- 행동 경로와 실행 세부 정보의 연결 → Trajectories에서 이상 행동을 먼저 좁힌 뒤 trace를 조사하는 디버깅 흐름을 지원한다.
- 읽기 쉬운 세션과 중복을 줄인 평가 입력 → 전문가 검토의 부담을 낮추고 온라인 평가로 추가 검토가 필요한 세션을 선별할 수 있다.
- 운영 세션의 데이터셋 저장과 지도 미세조정용 내보내기 → 최종 답변뿐 아니라 도구 사용과 세션 중 대응 방식까지 개선에 활용할 수 있다.
🧠 상세 정리
1. 긴 에이전트 세션에서 행동을 파악하기 어려운 이유
에이전트 디버깅은 에이전트가 실제로 무엇을 했는지 확인하는 질문에서 시작한다. 짧은 단일 턴 작업은 답을 찾기 쉽지만, 오래 실행되는 세션에는 여러 사용자 턴과 도구 호출, 재시도, 하위 에이전트로의 작업 인계가 섞여 행동 경로를 파악하기 어려워진다. 전체 trace는 실행 세부 정보를 조사하는 데 적합하지만, 세션의 흐름을 이해하려는 단계에서는 정보가 지나치게 많을 수 있다. LangSmith는 이를 돕기 위해 2026년 9월 24일 Trajectories를 발표했다. 이 기능은 주 에이전트와 하위 에이전트의 사람·AI·도구 메시지를 모아 처음 등장한 순서대로 보여주는 대화형 세션 보기다.
2. run·trace·thread 위에 구성되는 행동 경로
LangSmith는 에이전트가 수행하는 작업 단위를 run으로 기록하고, 하나의 작업에 속한 run들을 trace로 구성하며, 여러 턴의 세션에서 생성된 trace들을 thread로 연결한다. 이 구조는 중첩 실행, 실행 시간, 재시도, 입력과 출력, 메타데이터를 포함한 전체 실행 트리를 제공하므로 정확한 실행 과정을 확인할 때는 trace가 기준이 된다. Trajectories는 thread의 trace들을 바탕으로 중첩 run 구조를 덜어내고 행동을 설명하는 메시지와 동작을 남긴 보기다. 각 메시지를 순서대로 한 번만 표시하므로 세션을 에이전트가 거쳐 간 경로로 읽을 수 있다. LangChain, LangGraph, Deep Agents와 OpenAI·Claude 같은 에이전트 SDK, Codex·Claude Code·Cursor 같은 코딩 에이전트에서 전송한 trace를 기본 지원한다.
3. 문제 행동을 먼저 찾고 실행 세부 정보를 조사
사용자가 오래된 답변을 받았다고 신고하면 개발자는 사용자 의도 오해, 낡은 맥락 재사용, 잘못된 도구 호출, 하위 에이전트의 부정확한 결과, 도구 출력 무시 등 가능한 원인을 구분해야 한다. 답은 전체 trace에 있을 수 있지만, 중첩된 실행 정보 속에서 조사할 run을 찾는 데 시간이 든다는 것이 원문의 문제의식이다. 원문은 9개 턴과 60개 메시지로 구성된 지원 에이전트 세션을 예로 들어, Trajectories에서 대화와 도구 호출을 순서대로 훑으면 최신 데이터를 가져오는 대신 오래된 도구 결과를 재사용한 턴을 찾을 수 있다고 설명한다. 이후 해당 trace로 이동해 정확한 도구 입력과 출력, 실행 시간, 재시도, 중첩 구조를 확인할 수 있다. 이는 먼저 중요한 행동 단계를 특정하고 그 단계의 실행 세부 정보를 조사하는 접근이다.
4. 분야별 전문가가 읽고 평가할 수 있는 세션
에이전트의 업무와 행동을 검토하는 사람이 반드시 에이전트를 만든 개발자인 것은 아니다. 의료 전문가는 임상 문진 에이전트의 후속 질문이 적절했는지, 금융 서비스 검토자는 규정 준수 에이전트가 사례를 올바르게 처리했는지, 지원 책임자는 상위 담당자로 넘기는 절차가 정책에 맞았는지 판단할 수 있다. 이런 검토에는 질문과 에이전트 출력에 대한 가시성이 필요하지만, 중첩 run과 재시도, 실행 메타데이터까지 해석할 필요는 없다. Trajectories를 annotation queues로 보내면 분야별 전문가(SMEs)가 읽기 쉬운 세션을 바탕으로 행동에 점수를 부여하고 문제를 표시하며 피드백을 제공할 수 있다. 원문은 이 피드백을 프롬프트 수정, 에이전트 로직 변경, 평가기 개선, 더 나은 데이터셋 구축에 활용할 수 있다고 설명한다.
5. 온라인 평가로 운영 전반의 행동 검토
하나의 trajectory를 읽으면 특정 세션에서 일어난 일을 이해할 수 있지만, 같은 행동이 운영 트래픽 전반에서 반복되는지는 알 수 없다. LangSmith의 온라인 평가기는 이제 Trajectories를 평가해 세션 전체의 행동을 판단할 수 있다. 기존에 긴 세션을 run 단위로 평가하면 턴이 누적되면서 같은 맥락이 반복적으로 포함되어 평가 입력이 필요 이상으로 커지고 불필요한 정보가 늘어날 수 있었다. Trajectories는 각 메시지를 한 번씩 순서대로 유지하므로 평가기가 에이전트의 행동 경로에 집중하도록 돕는다. 평가 결과에서 점수가 낮은 세션을 골라 사람이 검토하도록 보내거나 향후 테스트를 위한 데이터셋에 저장할 수 있으며, 원문은 이를 추가 조사가 필요한 세션을 찾는 방식으로 제시한다.
6. 운영 행동의 학습 예시 전환과 제공 범위
사후 학습을 수행하는 팀은 Trajectories를 통해 운영 세션을 활용 가능한 예시로 전환할 수 있다. Trajectories에는 시스템 프롬프트, 사용자 메시지, 에이전트 응답, 도구 호출과 출력이 포함되어 최종 답변 외에도 행동 과정을 표현할 수 있다. 좋은 세션은 에이전트가 언제 명확화를 요청했는지, 어떤 도구를 호출했는지, 결과를 어떻게 사용했는지, 세션이 진행되면서 어떻게 대응을 바꿨는지 보여준다. 팀은 고품질 Trajectories를 데이터셋에 저장하고 지도 미세조정 워크플로용으로 내보내 모델이 재현하기를 원하는 운영 행동의 예시로 사용할 수 있다. 원문은 이러한 행동 기록을 에이전트 개선의 중요한 기본 요소로 제시하며, 발표 시점에 미국의 모든 요금제에서 이용할 수 있다고 안내한다.
🧾 핵심 주장 / 시사점
- Trajectories의 핵심 가치는 실행 기록을 읽기 쉬운 행동 경로로 재구성하고 원본 trace와 연결해, 문제 발견과 세부 원인 조사를 이어주는 데 있다.
- 동일한 세션 표현을 전문가 검토와 온라인 평가에 활용하면, 운영 중 선별된 문제 행동을 사람의 피드백과 향후 테스트로 연결할 수 있다.
- 운영 세션을 학습 예시로 활용하는 범위가 최종 답변에서 도구 선택, 결과 활용, 명확화 요청 같은 행동 과정으로 넓어진다.
✅ 액션 아이템
- LangSmith의 Trajectories에서 문제 행동을 좁힌 뒤 해당 trace의 입력·출력·실행 시간·재시도 정보를 확인.
- 온라인 평가에서 낮은 점수를 받은 세션을 선별해 annotation queues의 전문가 검토 또는 향후 테스트용 데이터셋으로 연결.
- 고품질 Trajectories를 데이터셋에 저장하고 지도 미세조정 워크플로의 학습 예시로 활용할 가능성을 검토.
❓ 열린 질문
- Trajectories에서 어떤 행동이 확인되면 원본 trace의 실행 세부 정보를 추가로 조사해야 하는가?
- 온라인 평가에서 낮은 점수를 받은 세션 중 어떤 사례를 전문가 검토에 우선 연결할 것인가?
- 지도 미세조정에 활용할 고품질 Trajectories를 어떤 기준으로 선별할 것인가?