Top 5 Exa Alternatives for AI Web Search and Data Extraction in 2026
Quick Summary
원문은 Exa의 대안 5종을 소개하면서 Firecrawl의 통합 웹 데이터 기능을 중점적으로 홍보하며, 선택 기준으로 추출 품질·가격·자체 호스팅·검색 목적을 제시한다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
원문은 Exa의 대안 5종을 소개하면서 Firecrawl의 통합 웹 데이터 기능을 중점적으로 홍보하며, 선택 기준으로 추출 품질·가격·자체 호스팅·검색 목적을 제시한다.
📌 핵심 요약
- Exa는 임베딩 기반 의미 검색을 제공하며, 대규모 결과를 반환하는 Websets는 최대 1시간이 걸릴 수 있다. 무료 제공량은 월 1,000건이며, 유료 검색은 1,000건당 $7, 심층 검색은 $12~15로 소개된다.
- Firecrawl은 Search·Scrape·Interact·Crawl을 통합하고, 오픈소스 및 자체 호스팅을 지원한다고 설명한다. 원문은 GitHub 스타 180K+, 월 1,000 무료 크레딧, 기본 페이지당 1크레딧을 제시하며, Firecrawl Alexandria의 데이터 도구 실행은 표시된 가격에 따라 별도로 과금한다고 밝힌다.
- 원문 작성 측의 추출 평가에서 Firecrawl은 커버리지 77.2%·F1 0.638, Exa는 69.2%·0.508을 기록했다. 별도 AIMultiple 에이전트 검색 평가에서는 Firecrawl 14.58점과 Exa 14.39점의 신뢰구간이 겹쳐 통계적으로 동률인 상위권으로 설명된다.
- Tavily는 AI 검색·연구용 API로, /search·/extract·/crawl·/map·/research와 LangChain 기본 통합을 제공한다. 원문은 월 1,000 무료 크레딧, 기본 검색 종량제 크레딧당 $0.008, 월 $30부터 시작하는 요금제를 소개한다.
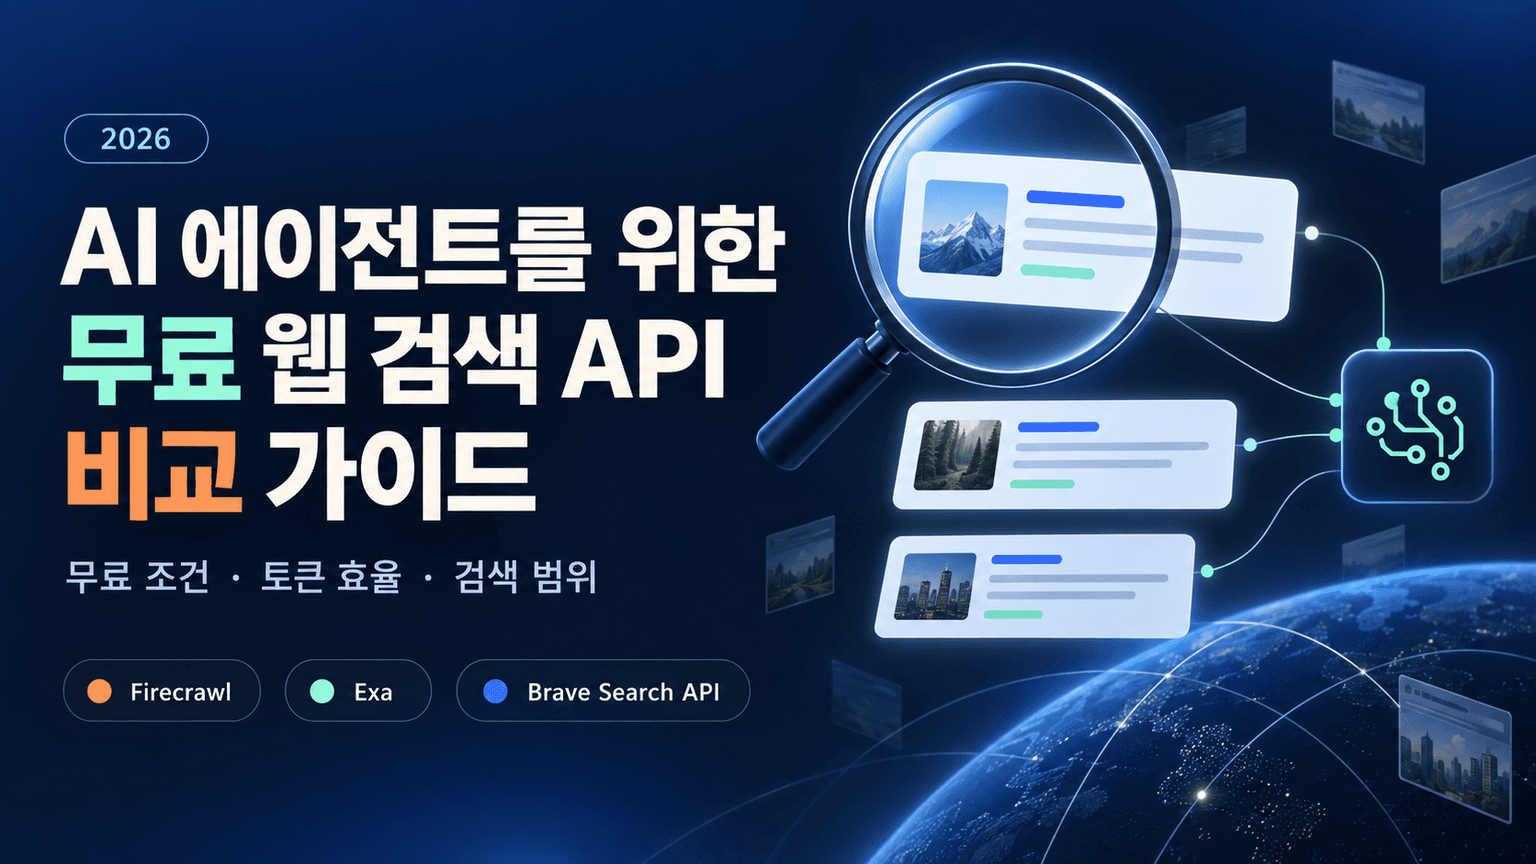
- 비교표는 Perplexity API를 출처 인용 답변용, Linkup을 검증된 사실·비즈니스 인텔리전스용, Brave Search API를 개인정보 보호 중심 검색용으로 분류한다. 무료 제공량은 각각 하루 100쿼리, 월 €5, 월 2,000쿼리이며, 제공된 본문은 Tavily 설명 도중 끝나 나머지 세 제품의 상세 근거는 포함하지 않는다.
🧩 주요 포인트
- 의미 검색과 웹 데이터 처리의 범위 차이 → Exa의 검색·발견 기능과 Firecrawl의 Search·Scrape·Interact·Crawl 통합 기능을 실제 작업 범위에 맞춰 비교할 필요가 있다.
- 추출 평가 우세와 검색 평가 동률의 병존 → Firecrawl의 F1 0.638을 전체 검색 성능의 일괄적인 우위로 해석할 수 없으며, 추출 품질과 에이전트 검색 성능을 구분해야 한다.
- 과금 단위·자체 호스팅·본문 범위의 차이 → 페이지·요청·크레딧과 데이터 도구 실행 비용을 구분하고, 상세 설명이 부족한 Perplexity API·Linkup·Brave Search API에 대한 판단은 제한적으로 내려야 한다.
🧠 상세 정리
1. 대안 탐색의 배경과 Exa의 기준점
원문은 AI 에이전트와 LLM이 실제 운영 환경으로 이동하면서 키워드 일치 이상의 의미 이해, 구조화된 추출, 실시간 웹 데이터 공급이 중요해졌다고 설명한다. 에이전트가 웹에서 정보를 자율적으로 검색하고 추론하며 행동하는 흐름이 검색 API의 요구사항을 바꾸고 있다는 것이 출발점이다. Exa는 문맥과 의도를 파악하는 임베딩 기반 의미 검색 엔진으로 소개되며, LLM·AI 에이전트·RAG 시스템에 결과를 직접 공급하는 용도에 적합하다고 평가된다. 복잡한 질의로 수천 건의 결과를 반환하는 Websets는 최대 1시간이 걸릴 수 있고, 요금은 월 1,000건 무료에 검색 1,000건당 $7, 심층 검색 $12~15, Contents 페이지 1,000개당 $1, 답변 1,000건당 $5로 제시된다. 대안 탐색의 이유로는 완전한 오픈소스와 자체 호스팅, 검색·스크래핑·추출의 통합, 예측 가능한 정액 과금, 대규모 병렬 처리가 열거된다.
2. 다섯 대안의 역할과 제공 자료의 범위
비교표는 Firecrawl을 AI 에이전트를 위한 통합 웹 데이터 도구로, Tavily를 AI 검색과 연구 작업용으로 배치하며 두 제품 모두 월 1,000 무료 크레딧을 제공한다고 적는다. Perplexity API는 한 번의 호출로 출처가 인용된 종합 답변을 만드는 제품으로 소개되고, 무료 제공량은 하루 100쿼리로 제시된다. Linkup은 신뢰할 수 있는 출처 통합과 SimpleQA 1위라는 주장을 앞세운 검증된 사실·비즈니스 인텔리전스 도구이며, 무료 제공량은 월 €5로 표시된다. Brave Search API는 300억 개 이상의 페이지를 포함하는 독립 인덱스와 SOC 2 인증을 특징으로 내세운 개인정보 보호 중심 검색 도구로, 월 2,000쿼리가 무료라고 설명된다. 다만 제공된 본문은 Firecrawl에 대부분의 설명을 할애한 뒤 Tavily의 기능 소개 중간에서 끝나므로, 나머지 세 제품에 대해서는 이 비교표 이상의 상세 평가를 확인할 수 없다.
3. Firecrawl Search와 Alexandria의 확장
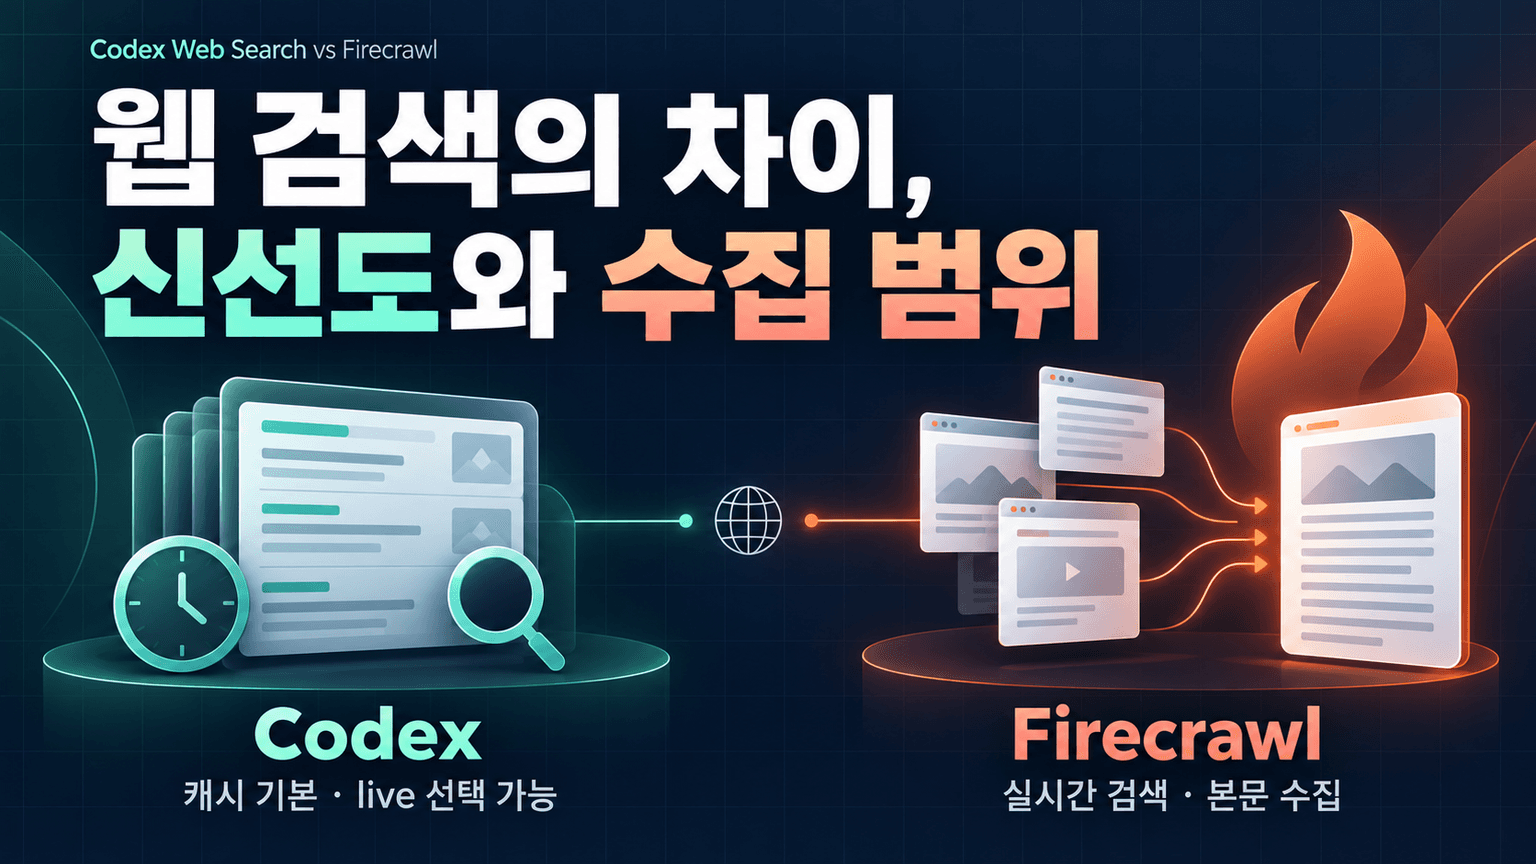
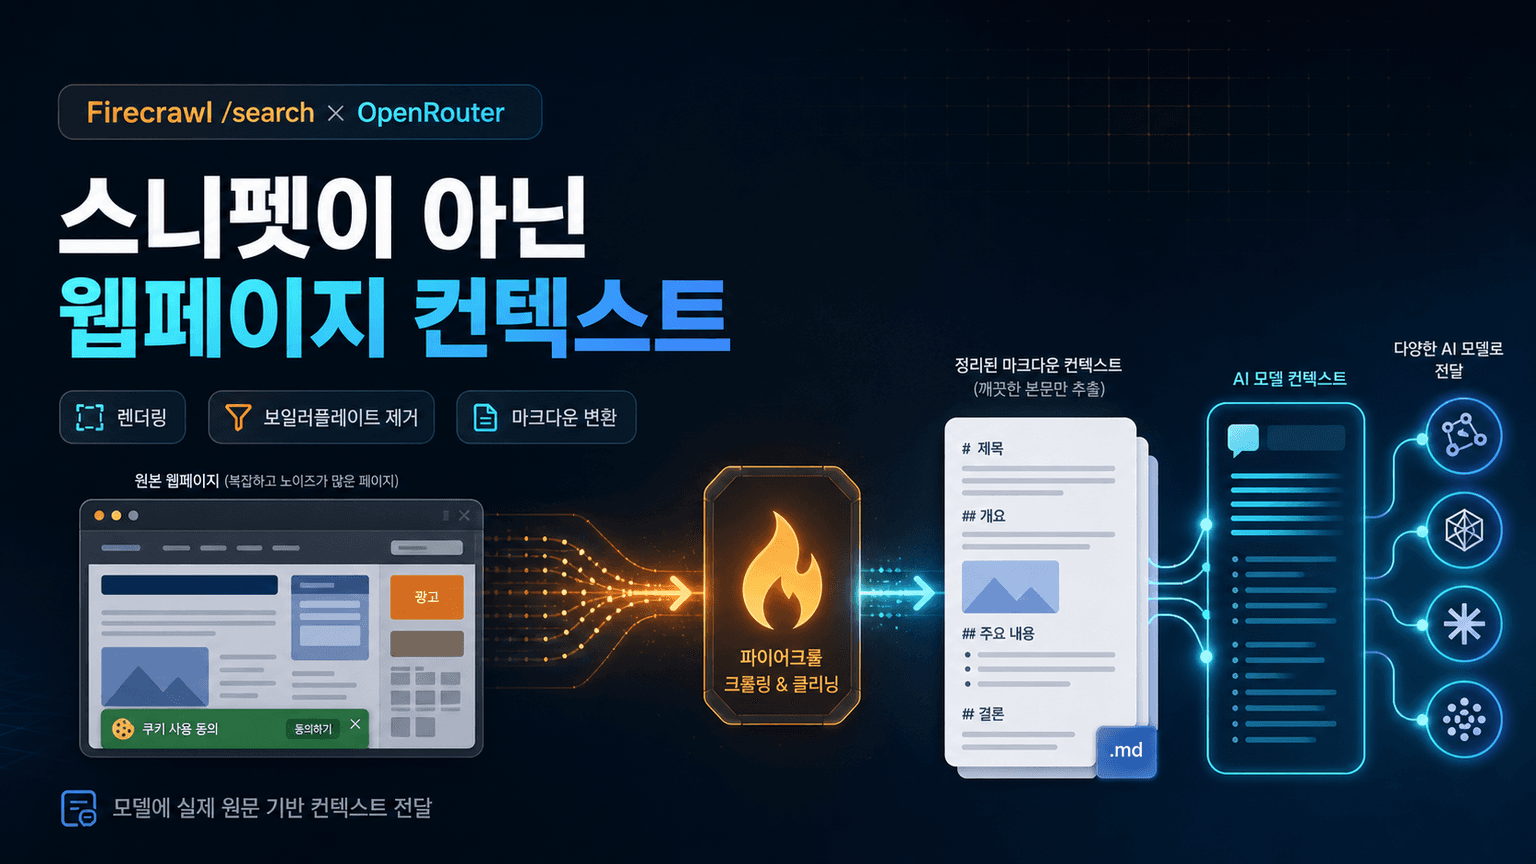
Firecrawl Search는 링크와 짧은 설명에 머무르지 않고 관련 페이지의 전체 콘텐츠를 정제된 마크다운이나 구조화된 JSON으로 반환한다고 설명된다. 일반 웹 검색 외에도 news, github, research, pdf 소스를 지원하며, 학술 검색에서는 arXiv와 PubMed의 논문을 다룬다고 소개한다. 원문에 따르면 2026년 9월부터 sources에 alexandria를 추가하면 같은 검색 호출에서 Firecrawl Alexandria의 데이터 도구를 담은 tools 배열도 받을 수 있다. 이 도구들은 SEC EDGAR·FRED 같은 공식 API, Fiscal.ai·Particle 같은 라이선스 출판사, 자체 Research·Developer·Government 인덱스와 연결되며 전체 공급자는 90개 이상으로 제시된다. Wayback Machine의 과거 페이지, Greenhouse 채용 공고, Companies House 등록 정보 등으로 접근 범위를 넓히지만, 도구 발견은 무료이고 실제 실행은 각 도구에 표시된 가격으로 과금된다는 구분이 있다.
4. 추출 방식과 출력 형식의 차이
원문은 Exa에서 페이지를 검색한 뒤 Contents API로 내용을 가져오는 방식과, Firecrawl에서 발견·추출·정제·활용을 연결하는 방식을 대비한다. Firecrawl의 Scrape는 markdown, html, json, links, screenshot, summary, image 형식을 지원하며, 파이프라인에 필요한 출력 형식을 한 번의 호출에서 선택할 수 있다고 설명한다. 구조화된 추출에서는 CSS 선택자나 XPath 대신 자연어로 원하는 필드를 지정하며, 예시 코드는 회사명·연락 이메일·직원 수를 JSON으로 추출하도록 요청한다. 사이트의 HTML 구조가 바뀌어도 AI가 자동으로 적응해 추출을 유지한다는 주장도 있으나, 제공된 본문에는 이 주장에 대한 별도의 실패 조건이나 검증 결과가 제시되지 않는다. Search의 context 매개변수는 에이전트가 단순한 키워드 외에 실제 수행하려는 작업의 맥락까지 전달하도록 하는 기능으로 소개된다.
5. 동적 페이지 처리와 자체 호스팅
원문은 추가 로드 버튼, 양식 제출, 여러 페이지에 나뉜 데이터처럼 단순한 검색 결과만으로 처리하기 어려운 웹 작업을 Firecrawl Interact의 대상으로 제시한다. Interact는 버튼 클릭, 입력란 작성, 페이지 이동과 여러 단계의 흐름을 자동화하며, 사이트마다 별도의 자동화 코드를 작성할 필요를 줄인다고 설명한다. Search가 새로운 출처를 찾고 Scrape가 콘텐츠를 정제한다면, Interact는 동적 페이지와 상호작용하고 Crawl은 사이트 전반을 깊게 탐색하는 역할로 정리된다. Firecrawl은 JavaScript 렌더링을 추가 비용 없이 자동 처리한다고 소개되며, 비교표에는 Exa도 Contents API에서 자동 렌더링을 제공한다고 표시된다. 또한 원문은 Firecrawl이 완전한 오픈소스이고 GitHub 스타가 180K+이며 자체 호스팅이 가능하다고 주장하면서, 데이터 상주 요건·보안 제약·규정 준수·인프라 통제에 대응할 수 있다는 점을 강조한다.
6. 추출 벤치마크와 검색 벤치마크의 구분
원문 작성 측은 오픈소스 scrape-evals로 실제 URL 1,000개에서 웹 스크래핑 엔진 13개를 시험했다고 밝히며, Firecrawl의 추출 품질을 뒷받침하는 근거로 제시한다. 비교 수치는 Firecrawl의 커버리지 77.2%와 F1 0.638, Exa의 커버리지 69.2%와 F1 0.508이며, F1은 유용한 콘텐츠를 잡아내는 정도와 불필요한 정보 사이의 균형을 나타내는 지표로 설명된다. 원문은 더 높은 F1이 대체로 더 깨끗하고 완전한 추출을 의미해 LLM의 제한된 문맥 공간을 활용할 때 가치가 있다고 해석한다. 한편 별도 AIMultiple 평가는 실제 AI·LLM 질의 100개로 검색 API 8개를 비교했고, Firecrawl은 Agent Score 14.58로 2위, Exa는 14.39로 3위였다고 소개한다. 두 제품의 신뢰구간이 겹쳐 통계적으로 동률인 상위권이라는 설명이 함께 있으므로, 자체 추출 평가의 우세를 모든 에이전트 검색 작업에서의 확정적인 우위로 확대할 수는 없다.
7. 통합의 편의성과 비용 주장
Firecrawl에 대한 핵심 주장은 검색 API, 스크래퍼, 브라우저 도구를 각각 연결하던 작업을 하나의 웹 데이터 API로 묶어 공급자 수와 코드를 줄일 수 있다는 것이다. 원문은 페이지당 1크레딧이라는 기본 과금 모델을 예측 가능한 비용의 근거로 내세우지만, Alexandria 데이터 도구 실행에는 개별 표시 가격이 적용된다고 별도로 명시한다. 따라서 본문에 등장하는 모든 기능의 사용 비용을 페이지당 1크레딧으로 동일하게 해석하기보다는, 페이지 처리와 데이터 도구 실행의 과금 설명을 구분해야 한다. 연결 방식으로는 공식 Claude 플러그인, Claude 스킬이 내장된 Firecrawl CLI, Lovable과 n8n 통합, 한 번의 연결을 지원하는 n8n Cloud 기본 통합이 소개된다. 이러한 설명은 Firecrawl을 단순한 검색 엔진보다 넓은 작업 범위의 제품으로 포지셔닝하며, 추출 깊이와 동적 페이지 처리, 자체 호스팅이 필요한 경우에 선택하라는 원문의 권고로 이어진다.
8. Tavily의 접근과 비교의 한계
Tavily는 AI 에이전트와 LLM을 위한 검색 API로 소개되며, /search·/extract·/crawl·/map·/research를 포함하는 검색과 연구 기능군을 제공한다고 설명된다. 비교표는 Tavily의 다중 출처 집계 방식과 Exa의 임베딩 기반 의미 검색을 대비하고, Tavily는 /search의 include_raw_content 또는 /extract를 통해 원문 콘텐츠를 제공할 수 있다고 적는다. 가격은 기본 검색 종량제 기준 크레딧당 $0.008, 요금제는 월 $30부터이며, 원문은 이를 요청 전에 비용을 파악하기 쉬운 투명한 구조로 평가한다. LangChain 기본 통합이 실시간 웹 검색을 에이전트에 연결하기 쉽게 만든다고 강조하고, Exa보다 설정이 간단하고 응답이 빠르다고 주장하지만 이 대목에는 구체적인 지연 시간 측정치가 없다. 제공된 자료는 Extract 설명이 완성되기 전에 끊기므로, Tavily의 나머지 기능과 후속 제품별 설명, 최종 결론까지 확인한 것처럼 요약해서는 안 된다.
🧾 핵심 주장 / 시사점
- 제품 선택의 핵심은 검색 결과를 찾는 데서 작업이 끝나는지, 전체 콘텐츠 추출과 동적 페이지 상호작용까지 필요한지에 있다. 원문이 강조하는 Firecrawl의 차별점은 이 작업 범위를 한 제품 안에 통합한다는 점이다.
- Firecrawl의 자체 추출 평가와 AIMultiple의 에이전트 검색 평가는 서로 다른 능력을 측정한다. 두 결과를 함께 보면 추출 품질에서의 우세와 검색 성능에서의 통계적 동률을 동시에 보존해야 한다.
- 원문은 Firecrawl을 홍보하는 관점이 강하고 제품별 설명의 분량도 불균형하다. 비교표에만 등장하는 Perplexity API·Linkup·Brave Search API의 적합성을 상세히 설명된 제품과 같은 확신 수준으로 판단하기는 어렵다.
✅ 액션 아이템
- 실제 작업 범위를 기준으로 Exa의 의미 검색과 Firecrawl의 Search·Scrape·Interact·Crawl 통합 기능의 적합성 비교.
- Firecrawl과 Exa의 비용 비교에서 페이지·요청·크레딧의 단위 및 Firecrawl Alexandria 데이터 도구 실행 비용을 구분해 검토.
- Firecrawl의 F1 0.638과 AIMultiple의 통계적 동률 결과를 구분하고, 상세 근거가 부족한 Perplexity API·Linkup·Brave Search API의 판단 범위를 제한.
❓ 열린 질문
- 현재 필요한 작업은 Exa의 의미 검색으로 충족되는가, 아니면 Firecrawl의 Search·Scrape·Interact·Crawl 통합 기능까지 필요한가?
- 페이지·요청·크레딧과 Firecrawl Alexandria 데이터 도구 실행 비용을 함께 고려하면 어떤 과금 구조가 실제 사용량에 적합한가?
- Firecrawl의 추출 평가 우세와 AIMultiple의 통계적 동률 중 실제 작업의 성공 기준에 더 직접적으로 연결되는 결과는 무엇인가?