Claude Web Fetch vs Firecrawl: Which One Actually Works for Web Extraction?
Quick Summary
원문은 Claude web fetch를 알려진 URL의 정적 콘텐츠 조회에 적합한 도구로, Firecrawl을 JavaScript 렌더링·다중 페이지 탐색·구조화 추출에 적합한 도구로 비교하지만, 성능 근거에는 자체 벤치마크와 이용자 보고가 포함된다.

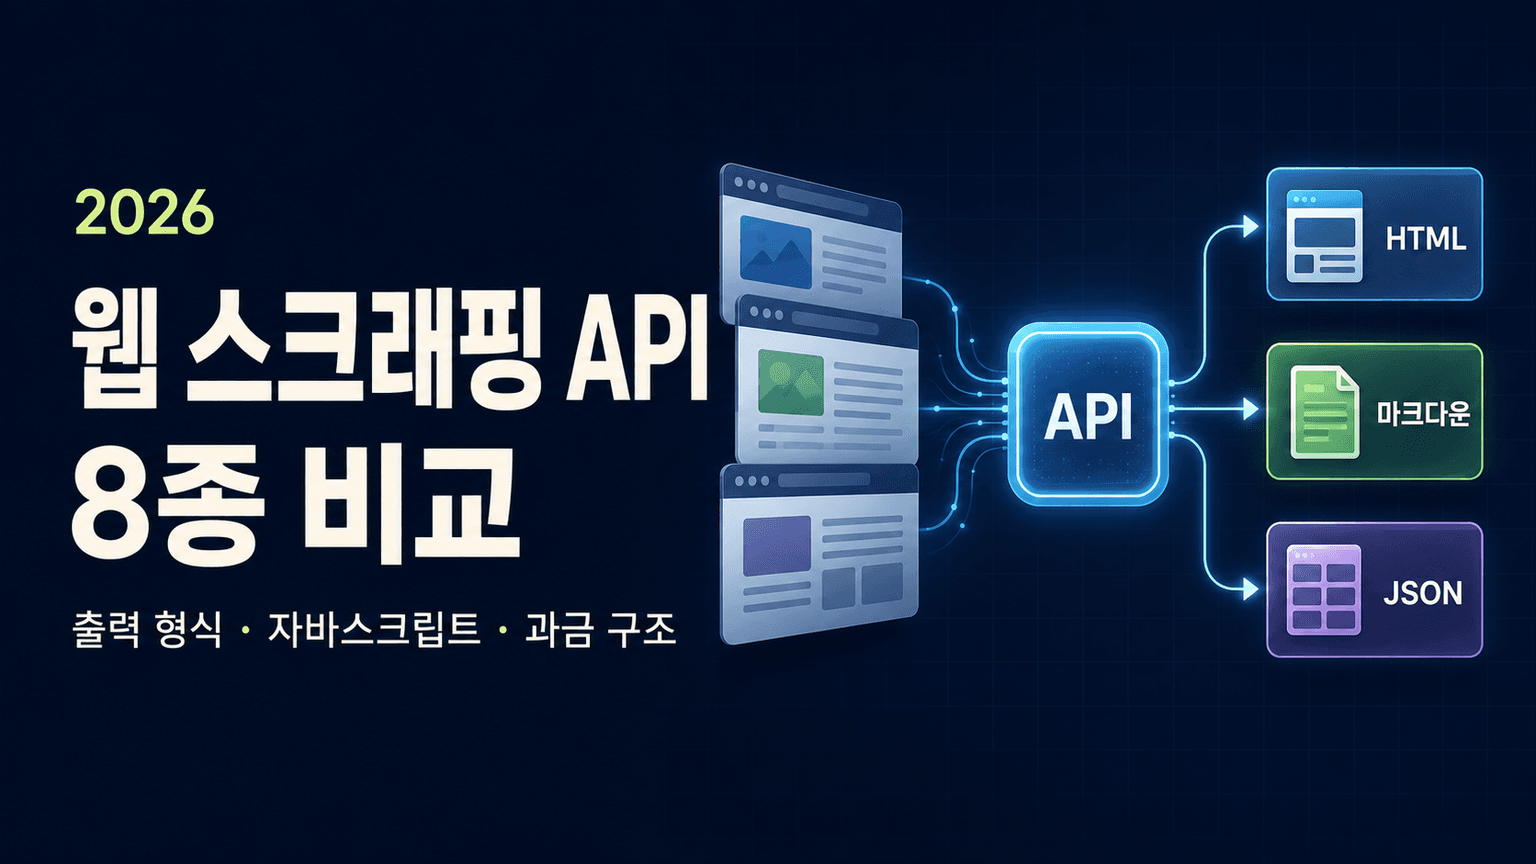
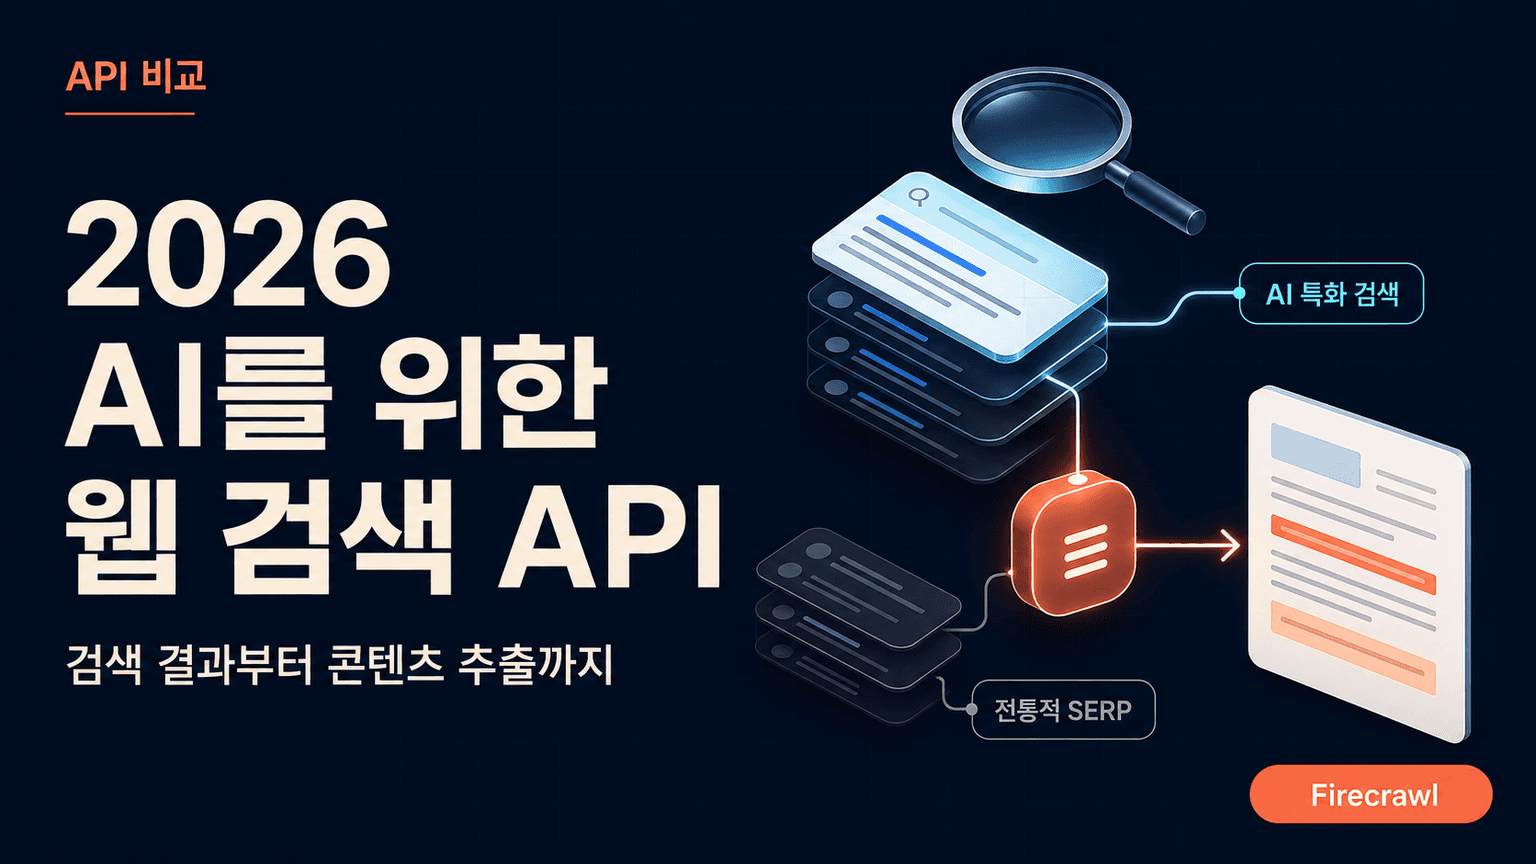
🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
원문은 Claude web fetch를 알려진 URL의 정적 콘텐츠 조회에 적합한 도구로, Firecrawl을 JavaScript 렌더링·다중 페이지 탐색·구조화 추출에 적합한 도구로 비교하지만, 성능 근거에는 자체 벤치마크와 이용자 보고가 포함된다.
📌 핵심 요약
- Claude web fetch는 Anthropic이 2025년 말 베타로 공개한 서버 측 도구로, 지정된 URL과 PDF의 텍스트를 가져온다. 원문은 JavaScript 렌더링, 동적 URL 생성, 로그인과 복잡한 다중 페이지 탐색을 지원하지 않는다고 설명한다.
- 원문에 따르면 web_fetch_20260318은 Claude Opus 4.8 등을 지원하며, 콘텐츠가 컨텍스트에 들어가기 전 코드를 통한 동적 필터링과 응답 포함 제어를 제공한다. 정적 문서와 알려진 URL의 연구 논문 조회에는 web_search와 web_fetch를 결합할 수 있다.
- Firecrawl은 실제 헤드리스 Chromium으로 페이지를 렌더링하고 DOM 기반 markdown과 스키마 기반 JSON을 제공한다. /map, /crawl, /search, /agent로 탐색을 확장하고, /interact로 클릭·입력·로그인·페이지 이동의 세션 상태를 유지한다고 소개된다.
- 원문은 Claude web fetch의 allowed_domains를 도메인 제한 수단으로 설명하고, Firecrawl의 선택적 checkPromptInjection은 JSON 추출 전 숨겨진 지시를 탐지하면 HTTP 403으로 차단한다고 설명한다. 작은 모델의 사전 요약 오류 근거로는 약 30편의 논문에서 17개 오류와 결론이 뒤집힌 2개 사례를 발견했다는 r/ClaudeAI 이용자 보고를 제시한다.
- Firecrawl 자체 DevDex 벤치마크의 전체 Recall@10은 Developer Index 63.1%, Claude web search 45.4%이며, AIMultiple 평가에서는 8개 API 중 2위와 평균 관련성 점수 1위를 기록했다고 한다. 자체 토큰 효율 평가에서는 원시 HTML 대비 입력 토큰이 약 93% 감소했고, 페이지 예시는 약 38K에서 2.8K로 줄었다.
🧩 주요 포인트
- 정적 콘텐츠 조회와 브라우저 동작의 차이 → 알려진 URL의 문서 조회에는 Claude web fetch가 맞지만, JavaScript 렌더링·로그인·다중 페이지 탐색이 필요하면 Firecrawl의 기능 범위가 선택 기준이 된다.
- 도메인 제한·추출 전 검사·DOM 기반 전달의 차이 → allowed_domains, checkPromptInjection, 사전 요약 여부는 서로 다른 위험을 다루므로 접근 통제와 콘텐츠 정확성을 구분해 판단해야 한다.
- 검색 성능과 토큰 절감의 비교 조건 → DevDex는 Claude web search와의 검색 비교이고 약 93% 절감은 원시 HTML 대비 수치이므로, Claude web fetch 자체의 추출 정확도나 총비용 우위로 곧바로 해석할 수 없다.
🧠 상세 정리
1. 비교의 출발점: URL 조회와 브라우저 기반 수집
Ninad Pathak의 글은 웹 수집이 단순한 HTTP 요청에서 브라우저 실행과 관리형 인프라로 발전해 왔다는 설명으로 두 도구의 차이를 제시한다. Claude web fetch는 대화에 주어진 단일 URL의 콘텐츠를 가져오는 Anthropic 내장 도구이며, Firecrawl은 동적 페이지와 복잡한 사이트를 처리하는 웹 데이터 계층으로 소개된다. 핵심 선택 기준은 콘텐츠를 최초 HTML 응답만으로 읽을 수 있는지, 아니면 JavaScript 실행과 사용자 동작이 필요한지에 있다. 원문은 단순 정적 조회의 편의성을 인정하면서도 구조화 JSON 추출, 대규모 수집, 자율 에이전트 작업에는 Firecrawl이 더 적합하다는 방향으로 논의를 전개한다.
2. Claude web fetch의 기능과 버전
원문은 Claude web fetch를 Anthropic이 2025년 말 베타로 공개한 서버 측 API 기능으로 설명하며, 대화 중 지정된 웹 URL과 PDF의 전체 텍스트를 가져오는 용도라고 소개한다. 최신 버전으로 제시된 web_fetch_20260318은 Claude Opus 4.8과 Claude Fable 5.1, Mythos 5.1, Opus 4.7, Opus 4.6, Sonnet 5, Sonnet 4.6을 지원한다고 적혀 있다. 이 버전에는 Claude가 코드를 작성·실행해 콘텐츠가 컨텍스트 창에 들어가기 전에 걸러내는 동적 필터링과 에이전트 작업을 위한 응답 포함 제어가 있다고 한다. 이전 버전인 web_fetch_20260309, web_fetch_20260209, web_fetch_20250910도 계속 사용할 수 있다는 설명이 덧붙는다.
3. 정적 조회의 한계와 사전 요약 오류 보고
원문에 따르면 Claude web fetch는 최초 HTML만 가져오므로 React나 Vue처럼 JavaScript로 본문을 생성하는 페이지에서는 빈 껍데기만 받을 수 있다. 또한 새로운 URL을 동적으로 만들어 가져오지 못하고 대화 기록에 이미 등장한 링크만 접근하며, 로그인 장벽과 복잡한 다중 페이지 구조도 처리하지 못한다고 설명한다. 별도의 정확성 문제로는 작은 모델이 가져온 페이지를 먼저 요약한 뒤 Opus에 전달하면서 압축·추측·세부 내용 발명이 발생한다는 r/ClaudeAI 게시물을 인용한다. 해당 이용자는 약 30편의 논문에서 17개 오류를 발견했고 그중 2개는 결론이 반대로 전달됐다고 보고했지만, 이는 원문이 인용한 이용자 사례이므로 모든 호출의 일반적 오류율로 볼 근거는 제시되지 않는다.
4. Claude에서의 사용 흐름과 적용 범위
원문은 Claude 웹 앱, 데스크톱 앱, Claude Code CLI에서는 web fetch가 기본 활성화되어 있어 프롬프트에 URL을 붙여 넣으면 별도 API 키나 도구 설정 없이 조회할 수 있다고 안내한다. 프로그램 방식의 예시는 Python SDK에서 claude-opus-4-8과 web_fetch_20260318을 지정하고, max_uses를 5로 설정하며 출처 인용을 활성화하는 형태다. 검색과 조회를 결합할 때는 web_search로 관련 URL을 찾고 web_fetch로 본문을 가져오며, max_content_tokens로 컨텍스트에 들어갈 텍스트 양을 제어한다. 글은 정적 개발 문서, 알려진 논문 URL, 블로그와 변경 기록, 보고서나 계약서의 PDF 텍스트 추출을 적합한 용도로 들지만, JavaScript 로딩과 url_not_accessible 또는 url_not_allowed 오류가 발생하는 경우에는 이 흐름이 실패할 수 있다고 설명한다.
5. Firecrawl의 렌더링·탐색·상태 유지
Firecrawl은 각 URL에서 실제 헤드리스 Chromium을 실행해 React, Vue, Angular 페이지를 렌더링하고, 실제 DOM에서 정리한 markdown을 반환한다고 소개된다. 원문은 일반 HTTP 요청이 빈 결과를 반환할 때 OpenClaw가 Firecrawl을 web_fetch의 대체 경로로 사용한다고 설명하며 브라우저 렌더링의 필요성을 강조한다. 탐색 기능에서는 /map이 도메인의 URL을 반환하고, /crawl이 깊이와 정규식 조건으로 사이트를 순회하며, /search는 검색어에서 시작하고 /agent는 자연어 요청에 따라 여러 단계와 사이트에 걸쳐 추출한다고 한다. 여기에 /interact가 클릭, 입력, 스크롤, 로그인, 페이지 이동의 상태를 유지하므로, 사전에 받은 URL을 조회하는 작업에서 상호작용을 거쳐 콘텐츠에 도달하는 작업으로 범위가 넓어진다는 것이 글의 주장이다.
6. 보안 경계와 콘텐츠 전달 방식
원문은 Claude web fetch에서 사용자 메시지에 삽입된 지시가 의도하지 않은 조회를 유발할 수 있으며, Anthropic이 allowed_domains를 중요한 완화 수단으로 권고한다고 설명한다. 이 방식은 요청 가능한 도메인을 제한하지만 허용된 페이지 내부의 악성 콘텐츠까지 해결하지는 못한다는 것이 글의 논지다. Firecrawl의 checkPromptInjection은 JSON 추출에 선택적으로 적용하는 분류기로, 수집한 페이지를 추출 전에 검사하고 숨겨진 지시가 탐지되면 HTTP 403과 SCRAPE_PROMPT_INJECTION_DETECTED 오류로 차단한다고 한다. 또한 Firecrawl은 작은 모델의 압축 요약 대신 실제 DOM 기반 markdown을 전달해 앞서 소개한 사전 요약 문제를 해결한다고 주장하지만, 제공된 본문에는 이 보안 검사나 콘텐츠 정확성을 별도로 검증한 수치가 없다.
7. 검색 벤치마크와 토큰 절감의 해석
Firecrawl 자체 공개 DevDex 벤치마크에서는 동일한 에이전트와 실행 환경에서 Developer Index의 전체 Recall@10이 63.1%, Claude web search가 45.4%였다고 제시한다. 세부 항목에서는 이슈에서 수정 사항을 찾는 과제가 66.0% 대 27.5%, 문서 검색이 47.2% 대 28.0%였으며, 별도의 AIMultiple 에이전트 검색 평가에서는 8개 API 중 2위이자 평균 관련성 점수 1위였다고 한다. 자체 토큰 효율 평가의 주장도 제시되는데, 원시 HTML 대비 입력 토큰 감소가 약 93%, 중앙값이 92.7%이며 한 페이지의 예시는 약 38K에서 2.8K로 줄어든다. 다만 검색 수치는 Claude web search와의 비교이고 토큰 수치는 원시 HTML과의 비교이므로, 이를 Claude web fetch의 추출 정확도나 전체 비용을 직접 측정한 결과와 동일하게 취급해서는 안 된다.
8. 운영 기능과 선택에 남는 조건
기능 표는 Firecrawl의 범위를 /batch/scrape를 통한 병렬 URL 수집, 비동기 작업과 웹훅, changeTracking을 통한 변경 비교, 관리형 프록시와 인증 세션 유지까지 확장한다. 문서 처리에서는 두 도구 모두 PDF를 지원하지만 Firecrawl은 DOCX와 HTTP 또는 로컬 입력도 지원한다고 소개하며, 출력 형식에는 markdown, html, rawHtml, links, screenshot, json, changeTracking, summary를 열거한다. 연동 수단으로는 TypeScript, Python, Go, Rust SDK와 MCP 서버가 제시되고, 비용은 Claude web fetch의 토큰 기반 방식과 Firecrawl의 크레딧 기반 방식으로 대비되지만 구체적인 요금 계산은 없다. 제공된 본문은 토큰 절감 설명 도중 끊겨 있어 이후 결론은 확인할 수 없으며, 확인 가능한 범위에서의 선택 기준은 정적 조회로 충분한지, 브라우저 상호작용과 수집 규모 확장이 필요한지다.
🧾 핵심 주장 / 시사점
- 두 도구의 차이는 단일 페이지를 가져오는 능력뿐 아니라 콘텐츠에 도달하기 위해 JavaScript 실행과 상태 유지가 필요한지에서 커진다.
- allowed_domains와 checkPromptInjection은 검사 지점이 다르며, DOM 기반 전달 역시 별개의 사전 요약 오류 문제를 다루므로 하나의 기능으로 모든 위험을 설명하기 어렵다.
- 원문은 Firecrawl의 장점을 강하게 주장하지만 자체 검색 벤치마크, 외부 검색 평가, 이용자 오류 보고는 근거의 성격이 다르므로 각각의 비교 범위를 유지해 읽어야 한다.
✅ 액션 아이템
- 대상 작업의 JavaScript 렌더링·로그인·다중 페이지 탐색 필요 여부를 기준으로 Claude web fetch와 Firecrawl의 적합성 비교.
- allowed_domains의 도메인 제한과 checkPromptInjection의 JSON 추출 전 차단 범위를 구분해 적용 필요성 검토.
- DevDex의 63.1% 대 45.4%와 원시 HTML 대비 약 93% 토큰 절감을 각각 검색 성능과 입력량의 근거로 구분해 평가.
❓ 열린 질문
- 대상 작업은 알려진 URL의 정적 콘텐츠 조회만으로 충분한가, 아니면 JavaScript 렌더링·로그인·다중 페이지 탐색이 필요한가?
- allowed_domains의 도메인 제한 외에 checkPromptInjection을 통한 JSON 추출 전 검사도 필요한가?
- DevDex의 63.1% 대 45.4%와 원시 HTML 대비 약 93% 토큰 절감은 대상 작업에서도 재현되는가?