Multi-Region training with Amazon SageMaker HyperPod and Qumulo
Quick Summary
Amazon SageMaker HyperPod와 Qumulo를 결합한 검증에서, 다른 AWS 리전의 데이터를 읽는 학습 클러스터가 NeuralCache의 초기 예열 후 데이터와 같은 리전에 있는 클러스터 수준의 처리량에 도달했다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
Amazon SageMaker HyperPod와 Qumulo를 결합한 검증에서, 다른 AWS 리전의 데이터를 읽는 학습 클러스터가 NeuralCache의 초기 예열 후 데이터와 같은 리전에 있는 클러스터 수준의 처리량에 도달했다.
📌 핵심 요약
- Amazon SageMaker HyperPod와 Cloud Native Qumulo(CNQ), Cloud Data Fabric(CDF)을 결합해 데이터 전체를 다른 리전으로 복제하거나 학습 코드를 변경하지 않고 원격 데이터셋에 접근하는 구성을 제시한다.
- 검증에서는 데이터가 있는 US East (Ohio, us-east-2)의 허브와 US West (Oregon, us-west-2)의 스포크에서 동일한 10억 2,000만 파라미터 LLaMA v3 학습을 독립적으로 실행했다. 각 HyperPod 클러스터는 ml.p5.48xlarge 인스턴스 2대와 H100 GPU 16개 구성으로 설명되며, 리전 간 네트워크 지연은 60ms였다.
- 허브는 초당 116~117개 샘플, 예열된 스포크는 초당 115~116개 샘플을 처리했고, 모두 999개 배치를 18.5분에 완료했다. 콜드 스타트 스포크는 약 19~20분이 걸렸으며, 초기 100~150개 배치의 예열 후 허브 수준으로 수렴했다.
- NeuralCache는 데이터 로더의 4KB 블록 접근 패턴을 예측해 스포크의 로컬 NVMe에 데이터를 미리 적재한다. 예열 후 읽기의 94~96%를 5ms 미만 지연의 로컬 캐시에서 처리하며, GPU 활용률은 초기 80~90%에서 98~100%로 수렴한다고 보고한다.
- 컴퓨팅 노드는 로컬 CNQ를 NFS로 마운트하고, CNQ 허브와 스포크는 VPC 피어링으로 연결된다. 원문은 일회성 예열 부담이 10,000개 이상 배치에서 전체 경과 시간의 1% 미만, 100,000개 초과 배치에서 0.1% 미만이라고 제시하지만, 검증 결과는 해당 구성에 대한 것이다.
🧩 주요 포인트
- 허브의 단일 기준 데이터셋과 스포크의 예측 캐시를 결합 → 데이터 전체의 사전 복제 없이 GPU 컴퓨팅 리전을 선택할 여지를 제공한다.
- ~150개 배치의 초기 성능 저하 후 처리량 수렴 → 장기 학습에서는 예열 부담이 작아지지만, 짧은 실행에서는 콜드 스타트와 예열된 캐시를 구분해 평가해야 한다.
- ms 지연의 특정 구성에서 허브 수준 처리량을 검증 → 리전 간 지연을 캐시로 완화할 가능성을 보여주지만, 데이터 전송 자체나 전송 비용이 사라졌다는 의미는 아니다.
🧠 상세 정리
1. GPU 가용성과 데이터 위치가 다른 문제
대규모 AI 모델 학습에는 막대한 GPU 자원이 필요하지만, 원하는 컴퓨팅 자원과 학습 데이터가 항상 같은 AWS 리전에 있지는 않다. 원문은 다른 리전의 데이터를 읽을 때 네트워크 지연과 전송 비용이 발생하므로, 팀이 페타바이트 규모 데이터를 복제하거나 매번 원격 읽기 지연을 감수하는 선택에 놓인다고 설명한다. 제안하는 해법은 Amazon SageMaker HyperPod와 Qumulo를 결합해 데이터의 기준 사본을 유지하면서 다른 리전에 학습 자원을 배치하는 것이다. 이를 통해 전체 데이터 이전과 학습 처리량 사이의 절충을 완화할 수 있다는 주장을 제시하며, 뒤이어 실제 리전 간 학습 비교로 그 주장을 뒷받침한다.
2. HyperPod와 CNQ의 역할 분담
Amazon SageMaker HyperPod는 자동 상태 점검, 노드 교체, 체크포인트 복구 기능을 갖춘 관리형 학습 인프라를 제공하고, Qumulo는 여기에 데이터 저장과 접근 계층을 결합한다. 학습 데이터셋은 한 리전의 Cloud Native Qumulo(CNQ) 허브에 기준 사본으로 저장되며, 각 HyperPod 클러스터는 같은 리전에 있는 CNQ 인스턴스를 NFS로 마운트한다. 스포크 CNQ가 VPC 피어링을 통해 허브 데이터를 가져오므로 컴퓨팅 노드는 원격 허브에 직접 접근하는 대신 로컬 마운트 경로로 데이터를 읽는다. 검증 아키텍처에서는 개발자가 Amazon EKS 오케스트레이터를 통해 작업을 제출하고, 두 리전의 컴퓨팅 노드가 동일한 로컬 경로를 사용하는 방식으로 학습 코드 변경 없이 데이터에 접근한다.
3. 독립 실행으로 비교한 학습 성능
검증은 데이터와 함께 US East (Ohio, us-east-2)에 배치된 허브 클러스터와 US West (Oregon, us-west-2)의 스포크 클러스터에서 같은 학습 작업을 각각 독립적으로 실행하는 방식이었다. 사용 모델은 10억 2,000만 파라미터 LLaMA v3였고, 각 HyperPod 클러스터는 ml.p5.48xlarge 인스턴스 2대와 H100 GPU 16개 구성으로 설명되며 리전 간 네트워크 지연은 60ms였다. 허브의 처리량은 초당 116~117개 샘플, 예열된 스포크는 초당 115~116개 샘플이었으며, 두 구성 모두 999개 배치에 18.5분이 걸렸다. 콜드 스타트 스포크는 표에서 초당 95~115개 샘플을 거쳐 116개로 수렴했고 약 19~20분이 소요됐으므로, 초기 예열 비용과 이후의 처리량을 구분해 결과를 읽어야 한다.
4. CDF의 네임스페이스와 원격 전송
Cloud Data Fabric(CDF)은 허브의 단일 기준 데이터셋을 여러 스포크에 통합 POSIX 네임스페이스로 제공한다. 스포크를 생성하면 파일시스템 메타데이터를 먼저 복제하므로 파일 데이터가 이동하기 전에도 수초 안에 전체 네임스페이스를 탐색할 수 있으며, 실제 읽기는 로컬 NVMe 캐시에 있으면 캐시에서, 없으면 허브에서 처리한다. 원문은 100ms를 넘는 지연에서도 데이터셋을 노출할 수 있다고 설명하고, 혼잡 제어가 패킷 손실에 반응해 전송을 줄이는 대신 측정한 병목 대역폭과 왕복 전파 시간을 기준으로 전송 속도를 조절한다고 주장한다. 또한 왕복 시간 900ms의 경로에서도 회선 속도에 가까운 처리량을 유지한다고 기술하지만, 이는 60ms 조건에서 수행한 학습 비교와 구별되는 CDF 기능 설명이다.
5. NeuralCache가 지연을 완화하는 방식
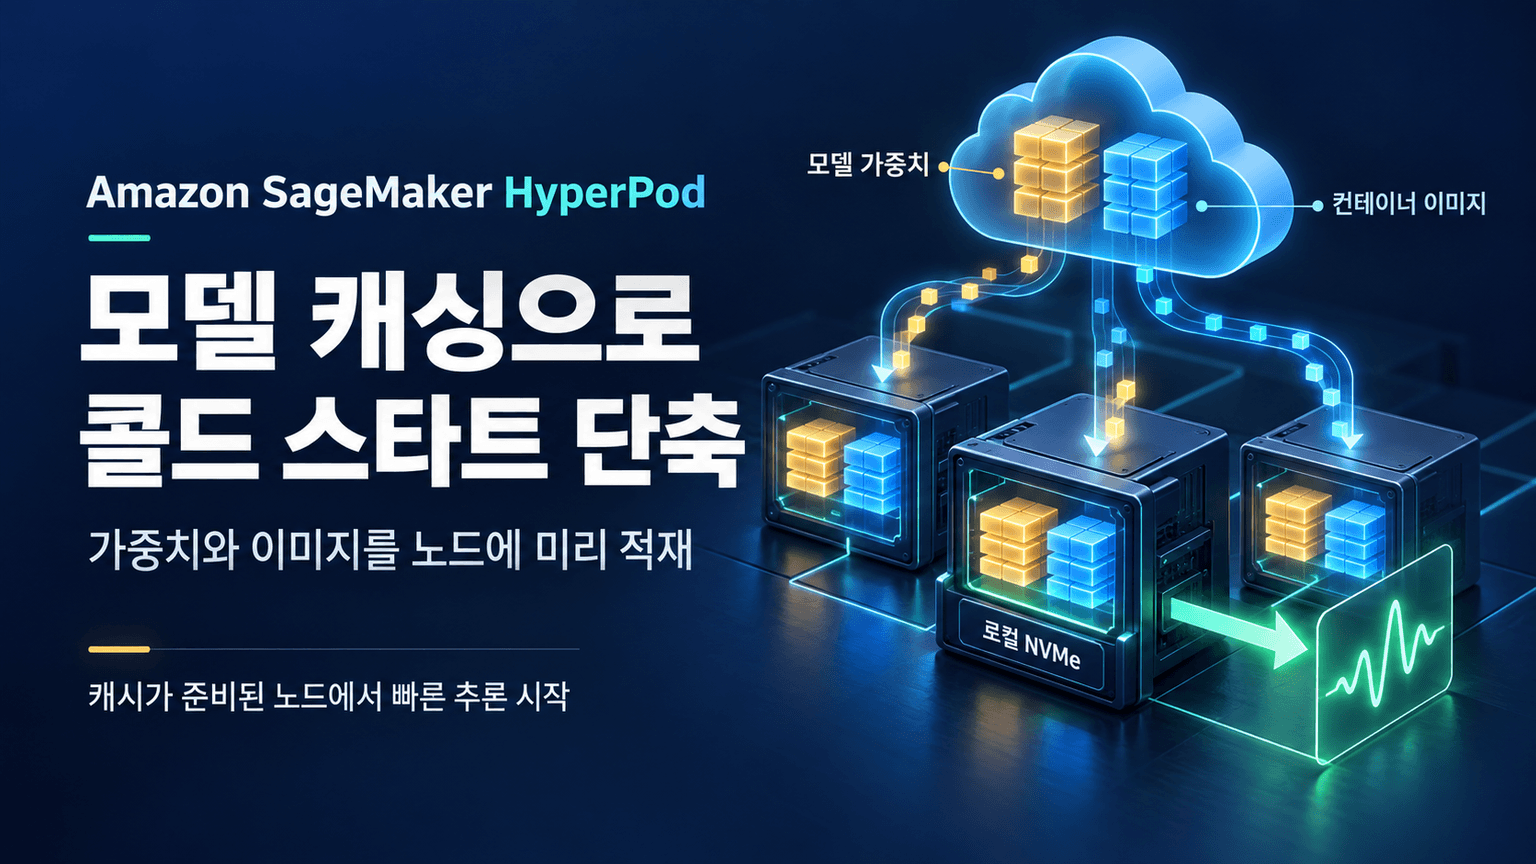
NeuralCache는 CDF 내부의 예측 캐싱 계층으로, 학습 데이터 로더가 발행하는 순차적인 4KB 블록 읽기를 관찰하고 다음에 필요한 블록을 예측한다. 요청이 실제로 도착하기 전에 허브에서 해당 블록을 가져와 스포크의 로컬 NVMe에 적재하며, 원문은 초기 100~150개 배치 동안 접근 패턴을 학습한다고 설명한다. 예열이 끝나면 읽기의 94~96%가 로컬 캐시에서 5ms 미만 지연으로 처리되므로, 상당수 데이터 접근에서 리전 간 왕복 지연이 학습의 직접적인 대기 시간으로 드러나는 것을 줄인다. 이 방식은 전체 데이터셋을 미리 복제하지 않는다는 의미이며, 캐시를 채우거나 캐시에서 찾지 못한 데이터를 읽기 위한 리전 간 전송까지 없어진다는 뜻은 아니다.
6. 단일 리전 허브의 기준 성능
허브 구성에서는 데이터와 컴퓨팅이 같은 리전에 있어 데이터 로더의 읽기 경로에 광역 네트워크 구간이 포함되지 않는다. 원문은 이 구성에서 지속 읽기 처리량 1.0~1.3GBps와 최대 읽기 지연 2~3ms를 기록하고, 10Gbps 네트워크 링크를 포화시키면서 학습 중 GPU 활용률을 높게 유지했다고 설명한다. 앞부분의 성과 요약에서는 GPU 활용률 99%와 3ms 미만 데이터 작업을 제시하며, 이를 CNQ가 저장 데이터의 크기와 별개로 성능을 확장할 수 있는 구조에 연결한다. 구체적으로는 처리량이 데이터셋 크기보다 클러스터 규모에 따라 확장되기 때문에 4노드 CNQ 클러스터로도 GPU에 데이터를 공급하는 네트워크 링크를 포화시킬 수 있었다고 설명한다.
7. 콜드 스타트와 예열된 캐시의 차이
콜드 스타트 스포크에서는 NeuralCache가 접근 패턴을 익히는 초기 100~150개 배치 동안 리전 간 지연이 드러나며, 구성 설명의 처리량은 초당 95~105개 샘플로 제시된다. 성능 표의 주석은 사전 실행이 없는 최악의 조건에서 초기 0~150개 배치가 15~20% 느리지만 첫 에포크 안에 허브 수준으로 수렴한다고 설명하고, 이후 처리량은 초당 115~117개 샘플로 제시한다. GPU 활용률 역시 초기 80~90%에서 98~100%로 수렴하며, 이미 예열된 캐시를 쓰는 후속 실행에서는 99%를 넘는 활용률과 즉각적인 허브 수준 성능을 보고한다. 원문은 예열의 일회성 부담이 10,000개 이상 배치에서 전체 경과 시간의 1% 미만, 100,000개 초과 배치에서 0.1% 미만이라고 주장하므로, 이점의 크기를 판단할 때는 전체 실행 길이와 캐시 상태를 함께 고려해야 한다.
8. 제공된 구축 절차와 자료의 범위
구축 전제는 HyperPod가 활성화된 AWS 계정, Ohio 리전의 CNQ, 클러스터당 ml.p5.48xlarge 인스턴스 2대를 위한 충분한 할당량, 리전 간 VPC 피어링, PyTorch와 분산 학습에 대한 기본 이해다. 첫 단계는 AWS Marketplace에서 CNQ를 배포하고, 배포 파일을 보관한 Amazon S3 버킷의 templates/cnq-standard.template.yaml 객체 URL로 CloudFormation 스택을 생성해 기존 VPC에 r5.8xlarge 기반 4노드 클러스터를 구성하는 것이다. 이어 허브와 스포크 VPC 사이에 피어링을 만들고 상대 리전에서 수락한 뒤, 양쪽 라우팅 테이블에 상대 VPC의 CIDR 경로를 추가하도록 안내한다. 원문은 리전 간 피어링 트래픽이 전송 중 암호화된다고 설명하며, Qumulo와 HyperPod 보안 그룹에서 두 VPC 사이의 필요한 NFS 포트인 TCP 2049만 허용하도록 제시한다. 제공된 source_body는 피어링 상태를 조회하는 명령 다음에서 끝나므로, 이후 데이터 업로드나 추가 학습 실행 절차는 이 자료만으로 확인할 수 없다.
🧾 핵심 주장 / 시사점
- 데이터 전체의 사전 복제 대신 허브의 기준 사본과 스포크의 예측 캐시를 사용하면, 데이터 저장 위치를 유지하면서 학습 컴퓨팅의 배치 선택을 넓힐 수 있다.
- 허브와 예열된 스포크의 999개 배치 완료 시간이 같다는 결과는 정상 상태 처리량의 유사성을 뒷받침하지만, 콜드 스타트 실행의 추가 시간까지 사라졌다는 근거는 아니다.
- 검증의 핵심은 60ms 지연을 없앤 것이 아니라 상당수 읽기를 로컬 캐시로 전환한 데 있으므로, 성능 해석에서는 캐시 적중률과 예열 구간을 함께 살펴야 한다.
✅ 액션 아이템
- Amazon SageMaker HyperPod와 CNQ 적용 검토 시, 허브의 단일 기준 데이터셋과 로컬 NFS 마운트로 학습 데이터에 접근하는 구성의 적합성을 확인한다.
- 학습 성능 평가에서 100~150개 배치의 초기 예열 구간과 이후 처리량을 구분하고, 콜드 스타트와 예열된 캐시의 완료 시간을 비교한다.
- 60ms 지연에서 얻은 검증 결과를 기준으로, VPC 피어링을 통한 데이터 전송 비용과 전체 데이터 사전 복제의 필요성을 함께 검토한다.
❓ 열린 질문
- 60ms 지연에서 검증된 허브 수준 처리량은 다른 리전 간 지연 조건에서도 유지되는가?
- 전체 학습 길이가 100~150개 배치의 초기 예열 구간과 비슷하다면 콜드 스타트가 완료 시간에 미치는 영향은 얼마나 큰가?
- NeuralCache의 로컬 캐시 처리 비율 94~96%를 고려할 때, 데이터 전체를 사전 복제하는 방식과 비교한 리전 간 전송 비용은 어느 정도인가?