How to Build an AI SDR that Researches Companies in Real Time
Quick Summary
Firecrawl로 작성 시점의 최신 기업 신호와 홈페이지 정보를 수집하고 OpenAI의 gpt 5로 첫 영업 메시지를 만드는 Python 기반 AI SDR 구현 가이드다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
Firecrawl로 작성 시점의 최신 기업 신호와 홈페이지 정보를 수집하고 OpenAI의 gpt-5로 첫 영업 메시지를 만드는 Python 기반 AI SDR 구현 가이드다.
📌 핵심 요약
- AI SDR은 잠재 고객을 찾고 조사해 첫 영업 메시지를 작성하는 소프트웨어로, 거래 성사보다 대화 시작까지의 초기 업무를 맡는다. 이 글의 ‘실시간’은 메시지 작성 시점에 투자 유치·제품 출시·채용 같은 신호를 웹에서 조회한다는 뜻이다.
- 원문이 인용한 Belkins의 2025년 자료에 따르면 1,650만 건의 이메일에서 B2B 콜드 이메일 평균 응답률은 2023년 6.8%에서 2024년 5.8%로 하락했다. Woodpecker는 2,000만 건 이상의 발송에서 개인화 이메일 응답률을 17%, 일반 이메일을 7%로 제시하며 약 2.4배 차이를 보고한다.
- 구현에는 Python 3.10+, Firecrawl API 키, OpenAI API 키가 필요하다. Firecrawl /search로 최신 신호를 찾고, scrape와 JSON Schema·Pydantic으로 회사명·제품·판매 대상·포지셔닝·해결하려는 고객 문제를 구조화한다.
- 검색 예제는 기업명과 latest news를 조합하고 tbs="qdr:m"으로 최근 한 달을 제한한다. 작성 단계는 OpenAI의 gpt-5에 특정 최신 신호 하나, 제품과 판매 대상, 부담이 적은 요청 하나를 담은 90단어 미만의 메시지를 요구하며, 검색 결과가 없으면 그 사실을 프롬프트에 표시한다.
- 원문은 같은 조사·작성 과정을 단일 기업에서 50개 이상 기업의 동시 처리로 확장한다고 예고한다. 다만 제공된 본문은 메시지 작성 설명 도중 끊겨, 동시 처리 구현과 웹 이외 데이터 제공자 추가 방법은 확인할 수 없다.
🧩 주요 포인트
- 정적 고객 목록의 신호는 시간이 지나면 낡음 → 작성 시점의 검색으로 첫 문장에 활용할 사건의 최신성을 확보하려는 설계다.
- Firecrawl 검색은 최근 사건을, 홈페이지 scrape는 기업의 정체성을 제공 → 두 정보를 결합해 사건 언급과 제품·고객 이해가 함께 드러나는 메시지를 만든다.
- 개인화 이메일의 높은 응답률은 인용 자료이고 50개 이상 동시 처리는 예고 수준 → 제시된 AI SDR의 실제 응답률 개선과 확장 성능은 제공된 본문만으로 판단할 수 없다.
🧠 상세 정리
1. 조사 시간을 줄여 메시지의 구체성을 확보
글은 영업 담당자가 하루에 100개 고객사를 조사하기 어렵기 때문에 메시지 작성이 템플릿에 의존하게 되고, 이런 메시지는 무시되기 쉽다는 문제에서 출발한다. Belkins의 2025년 자료를 인용해 1,650만 건의 이메일에서 B2B 콜드 이메일 평균 응답률이 전년 6.8%에서 2024년 5.8%로 떨어졌다고 설명한다. 이어 Woodpecker의 2,000만 건 이상 발송 자료에서는 개인화 이메일이 17%, 일반 이메일이 7%의 응답률을 보여 약 2.4배 차이가 났다고 제시한다. 저자는 이 차이를 메시지의 구체성과 연결하고, 구체성을 얻는 데 필요한 조사 시간을 자동화 대상으로 삼는다. 다만 이 수치들은 개인화의 필요성을 뒷받침하기 위해 인용된 자료이며, 글에서 만드는 에이전트 자체의 성과 측정 결과는 아니다.
2. AI SDR의 역할과 실시간 조사의 의미
AI SDR은 잠재 고객을 찾고 조사한 뒤 첫 접촉 메시지를 작성하는 소프트웨어로 정의되며, 신입 영업 담당자의 초기 업무 중 대화를 시작하는 단계까지를 맡는다. 원문은 거래를 마무리하는 역할까지 포함하지 않으며, 기존 도구 상당수가 CRM 필드나 한 번 수집한 연락처 목록 같은 정적 데이터에 의존한다고 설명한다. 의도나 신호를 포착하는 도구를 쓰는 팀은 약 25%라는 Autobound의 2026년 자료도 인용하지만, 공급업체 출처의 대략적인 경향을 보여주는 수치라는 단서를 붙인다. 투자 유치, 제품 출시, 엔지니어링 부문 부사장 채용 공고 같은 사건은 신선할 때 첫 문장의 소재로 유효하므로, 석 달 전에 만든 목록으로는 이후의 사건을 반영하기 어렵다는 주장이다. 여기서 실시간은 지속적인 감시가 아니라 기업별 메시지를 쓰는 순간 라이브 웹에서 관련 신호를 가져오는 방식이다.
3. Firecrawl과 OpenAI를 연결하는 실행 환경
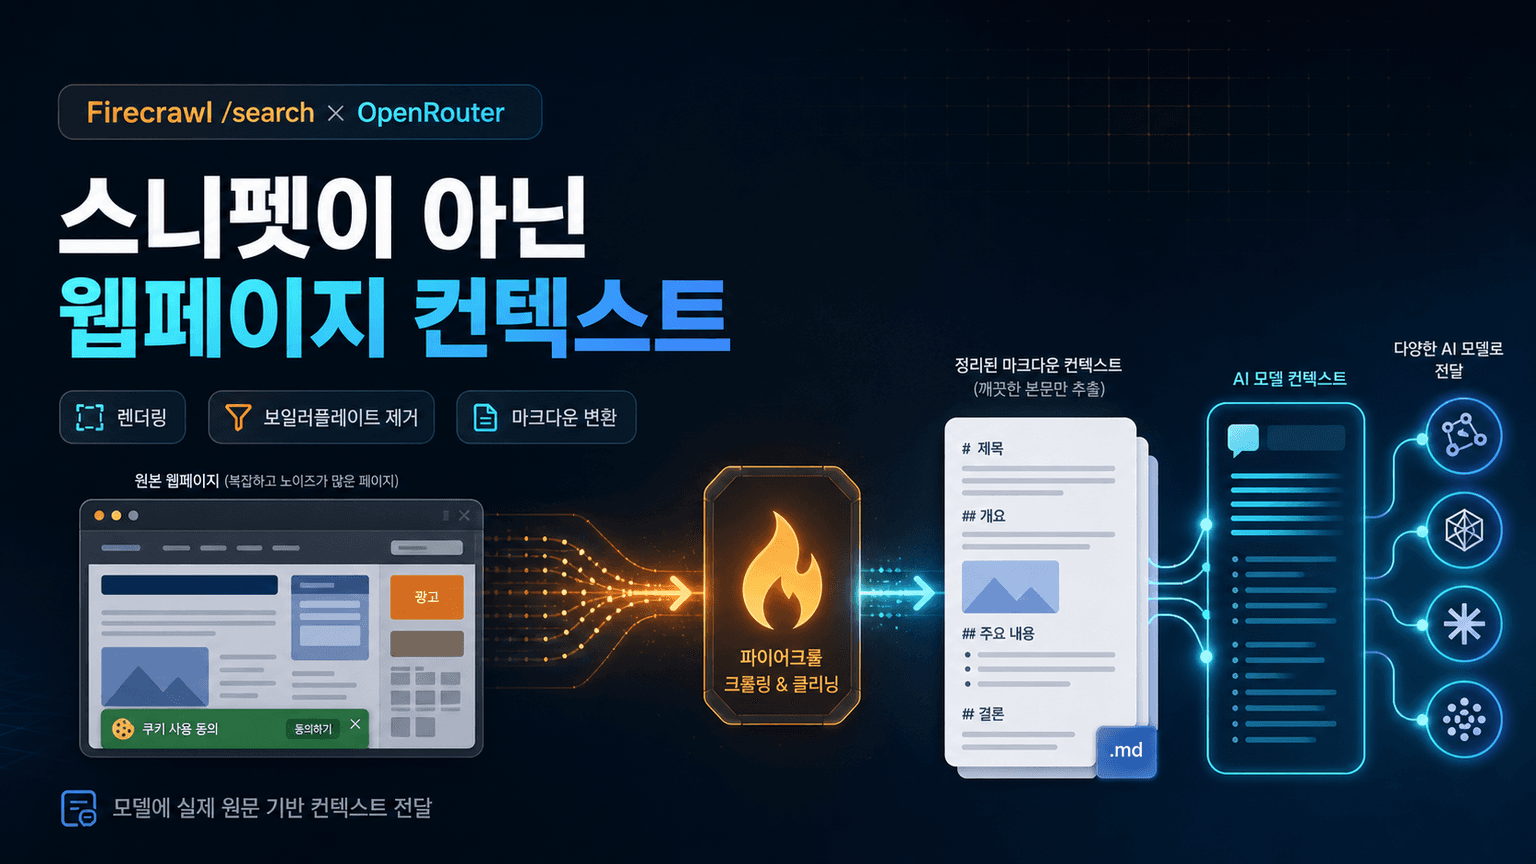
구현은 Firecrawl의 웹 검색으로 최신 사건을 수집하고, scrape 엔드포인트로 기업 홈페이지의 정형 정보를 추출한 다음 OpenAI로 메시지를 작성하는 구조다. Python이 이 과정을 연결하며, 준비 요건은 Python 3.10 이상과 Firecrawl 및 OpenAI의 API 키다. 설치 패키지로는 firecrawl-py, openai, pydantic, python-dotenv가 제시되고, 각각 API 호출, 데이터 구조 정의, 환경 변수 로딩에 사용된다. 예제는 load_dotenv()로 .env 파일을 읽은 뒤 FIRECRAWL_API_KEY와 OPENAI_API_KEY 환경 변수로 두 클라이언트를 초기화해 키가 코드에 직접 들어가지 않게 한다. Firecrawl은 검색·스크래핑·브라우저 상호작용 기능을 제공한다고 소개되지만, 이 에이전트가 실제 사용하는 기능은 웹 검색과 회사 사이트 스크래핑이다.
4. 최근 사건을 찾는 검색 조건과 빈 결과 처리
원문은 Firecrawl /search를 질의 한 번으로 순위가 매겨진 라이브 검색 결과와 페이지 내용을 제공하는 에이전트용 검색 기능으로 소개한다. 실제 find_signals 예제는 기업명 뒤에 latest news를 붙이고 기본 결과 수를 5개로 설정하며, tbs="qdr:m"으로 최근 한 달의 결과를 요청한다. 변화가 빠른 기업에는 qdr:w를 사용해 최근 일주일로 좁힐 수 있지만, 최신성 필터에 funding OR launch OR hiring 같은 조건까지 겹치면 결과가 나오지 않는 경우가 많다고 설명한다. 반환 객체의 results.web이 None일 수 있으므로 or []로 빈 결과를 처리하고, 각 결과에서 제목·URL·설명을 추려 후속 단계에 전달한다. 이 단계의 핵심은 오래 유지되는 회사 소개보다 첫 접촉에서 언급할 만한 최근 사건을 찾는 데 있으며, 검색 조건을 단순하게 유지하는 것이 예제의 선택이다.
5. Tailscale 검색 예시와 신호의 성격
find_signals에 Tailscale을 넣은 예시에는 Linux 호스트의 Tailscale 설정 백업을 묻는 Reddit 글과 캐나다의 Bill C-22를 다룬 Tailscale 블로그 글이 등장한다. 후자의 설명은 법안이 보안 서비스에 더 많은 메타데이터 보관과 접근 시스템 구축을 요구할 위험이 있으며, Tailscale이 법안 수정을 주장한다는 내용이다. 원문은 이런 게시물의 제목과 설명을 메시지 첫머리에 활용할 수 있는 소재로 보고, 최근 블로그 글이나 보안 공지처럼 시의성이 있는 정보를 강조한다. 이 예시는 검색이 반드시 투자 유치나 제품 출시만 반환하는 것이 아니라 사용자의 질문과 기업이 공개한 정책 관련 입장도 가져올 수 있음을 보여준다. 저자는 이런 사건 정보를 조사 결과 중 변동성이 큰 부분으로 설명하며, 현재성이 있을 때 언급 가치가 있다는 점을 기업의 기본 정보와 구분한다.
6. 홈페이지를 구조화된 기업 정보로 변환
검색이 최근 사건을 제공한다면, 홈페이지 추출은 기업이 무엇을 판매하고 누구에게 판매하며 자신을 어떻게 설명하는지를 파악하는 단계다. CompanyIntel이라는 Pydantic 모델은 name, products, sells_to, positioning, pain_points 필드를 정의하고, 각 필드의 description은 Firecrawl이 채울 내용에 대한 조사 지침으로 쓰인다. extract_intel은 회사 도메인의 HTTPS 페이지를 scrape하면서 JSON 형식과 CompanyIntel.model_json_schema()를 전달하고, 반환된 doc.json을 model_validate로 검증해 형식화된 객체로 만든다. Tailscale 예시에는 Business VPN, Privileged Access, Securing AI, Infra access, Zero Trust networking이 제품으로 담기며 판매 대상은 기업과 원격 근무 팀으로 정리된다. 포지셔닝과 해결 문제 역시 회사 사이트에서 추출한 자기 설명으로 제시되므로, 이 정보는 최신 사건에 기업의 제품과 고객 맥락을 더하는 역할을 한다.
7. 조사 결과를 짧은 첫 영업 메시지로 작성
작성 프롬프트는 90단어 미만의 첫 접촉 이메일을 요구하며, 최근 신호 하나를 구체적으로 지목해 시작하고 회사의 제품과 판매 대상을 언급하도록 한다. 마지막에는 부담이 적고 명확한 요청 하나를 두며, 일반적인 협업 수사나 제목, 이름 자리표시자 없이 일반 텍스트로 출력하도록 제한한다. write_message는 기업의 제품·판매 대상·포지셔닝·고객 문제를 프롬프트에 넣고, OpenAI의 responses.create에 model="gpt-5"를 지정해 호출한다. 검색 단계에서 제목·URL·설명을 수집하지만, 실제 작성 코드의 signal_lines에는 제목과 URL만 포함되므로 검색 설명까지 작성 모델에 전달되는 것은 아니다. 검색 결과가 없으면 no recent signals found라는 문구를 넣어 부재를 표시하고, 응답은 response.output_text.strip()으로 반환하지만, 신호 부재 시에도 특정 신호를 인용하라는 규칙을 어떻게 조정할지는 제시된 코드에서 확인되지 않는다.
8. 확장 목표와 제공된 본문의 확인 범위
도입부는 단일 기업에 적용한 조사·작성 반복 과정을 50개 이상 기업에 동시 적용하는 스크립트로 확장한다고 예고한다. 목차에도 전체 목록으로 확장하는 방법과 웹 이외의 데이터 제공자를 추가하는 방법이 포함돼 있어, 개별 기업의 메시지 작성 다음에 규모와 정보원 확장을 다루려는 흐름이 드러난다. 그러나 제공된 본문은 작성 프롬프트의 규칙을 조사 결과와 연결해 설명하던 문장 중간에서 끝나므로, 이후 구현을 확인할 수 없다. 따라서 이 자료로 구체적으로 정리할 수 있는 범위는 실행 환경 준비, 최근 신호 검색, 홈페이지 정보 추출, OpenAI를 통한 메시지 생성까지다. 50개 이상 동시 처리의 성능이나 오류 처리, 추가 데이터 제공자 연동 방식, 실제 메시지 발송 및 응답률 개선 결과는 제공된 내용만으로 확정할 수 없다.
🧾 핵심 주장 / 시사점
- 개인화의 핵심은 기업명을 바꾸는 데 그치지 않고, 현재의 사건과 해당 기업의 제품·고객 맥락을 연결하는 데 있다는 것이 원문의 설계 방향이다.
- 최근 한 달이라는 검색 조건은 시간 범위를 제한하지만, Tailscale 예시처럼 사용자 질문도 반환하므로 최신성과 영업 메시지에 대한 적합성은 구분해서 볼 필요가 있다.
- 구조화된 기업 정보와 명시적인 작성 규칙은 메시지 생성의 입력과 형식을 정리하지만, 제시된 코드만으로 응답률 개선이나 대규모 동시 처리 성능까지 입증되지는 않는다.
✅ 액션 아이템
- Python 3.10+, Firecrawl API 키, OpenAI API 키를 준비해 최신 신호 검색·기업 정보 추출·메시지 생성 과정을 연결한다.
- gpt-5의 생성 메시지가 최신 신호 하나, 제품과 판매 대상, 부담이 적은 요청 하나, 90단어 미만 조건을 반영하는지 확인한다.
- 50개 이상 기업의 동시 처리 구현과 실제 응답률 개선은 제공된 본문에서 확인되지 않은 검증 과제로 둔다.
❓ 열린 질문
- 최근 한 달 검색에서 결과가 없을 때 gpt-5가 특정 최신 신호 하나를 언급하도록 한 조건은 어떻게 처리하는가?
- 50개 이상 기업을 동시 처리할 때 조사·작성 과정의 성능은 어떻게 달라지는가?
- 제시된 AI SDR은 정적 고객 목록에 기반한 메시지보다 실제 응답률을 얼마나 개선하는가?