d-Matrix Adopts NVIDIA NVLink Fusion for Rack-Scale XPU Deployment
Quick Summary
d Matrix는 차세대 Raptor XPUs를 NVIDIA AI 인프라에 연결하기 위해 NVLink Fusion을 채택하고, 공통 랙 기반의 대규모 추론 배포를 추진한다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
d-Matrix는 차세대 Raptor XPUs를 NVIDIA AI 인프라에 연결하기 위해 NVLink Fusion을 채택하고, 공통 랙 기반의 대규모 추론 배포를 추진한다.
📌 핵심 요약
- d-Matrix는 NVLink Fusion으로 차세대 Raptor XPUs를 NVIDIA NVLink 스케일업, Spectrum-X 스케일아웃 네트워킹, NVIDIA MGX 랙 아키텍처에 연결할 계획이라고 발표했다.
- d-Matrix 공동창업자 겸 CEO Sid Sheth는 추론 수요가 급증하지만 자본·시간·에너지는 한정돼 있다며, NVLink Fusion과 MGX의 수랭식 아키텍처가 초저지연 추론의 배포와 확장을 더 빠르고 위험이 낮은 경로로 지원한다고 설명했다.
- NVIDIA는 MGX의 검증된 랙 설계·공급망·전력·냉각 인프라를 활용하면 GPU·CPU·XPU별로 별도 랙 아키텍처를 만들 필요 없이 공통 랙을 사용할 수 있다고 설명한다.
- d-Matrix는 NVLink로 XPUs를 하나의 고대역폭·저지연 스케일업 도메인에 연결하고, NVIDIA Vera Rubin NVL72 등 GPU 시스템과 분리형 추론을 지원할 계획이다. NVIDIA Vera CPUs, ConnectX-9 SuperNICs, BlueField-4 DPUs, Spectrum-X Ethernet 네트워킹의 통합도 추진한다.
- NVIDIA는 NVLink Fusion이 공통 AI 팩토리 플랫폼에서 워크로드에 맞는 연산 자원을 선택하도록 지원한다고 설명한다. 모든 AI 워크로드·모델·모델 아키텍처 지원과 최고의 와트당 성능, 최저 토큰당 비용을 플랫폼의 설계 목표로 제시하지만, 본문에는 이를 검증할 정량 결과가 없다.
🧩 주요 포인트
- 칩 개발 이후에도 네트워킹·랙·전력·냉각·소프트웨어·공급망 통합이 필요 → NVLink Fusion과 MGX는 Raptor XPUs의 대규모 배포에 드는 시간·비용·위험을 줄이려는 접근이다.
- 공통 랙과 NVIDIA 시스템의 병행 운용 → d-Matrix의 특화 추론을 통합 AI 팩토리 안에 배치하고 워크로드별 연산 자원 선택을 넓히는 구조다.
- 통합 계획과 성능·비용상의 기대효과가 중심인 발표 → 실제 배포 성과와 와트당 성능·토큰당 비용의 개선 여부는 본문만으로 확인하기 어렵다.
🧠 상세 정리
1. Raptor XPUs의 NVIDIA 인프라 연결
AI 추론 칩 업체 d-Matrix는 차세대 Raptor XPUs를 NVIDIA AI 인프라 플랫폼에 연결하기 위해 NVLink Fusion을 사용할 계획이라고 발표했다. 연결 대상은 NVLink 스케일업 네트워킹, Spectrum-X 스케일아웃 네트워킹, MGX 랙 아키텍처와 더 넓은 NVIDIA AI 플랫폼이다. 공동창업자 겸 CEO Sid Sheth는 추론 수요가 급증하는 상황에서도 자본·시간·에너지는 한정돼 있다고 설명했다. 그는 널리 배포된 수랭식 아키텍처에 Raptor XPUs를 통합하면 고객이 초저지연 추론을 더 빠르고 낮은 위험으로 배포·확장할 수 있다고 밝혔다.
2. 맞춤형 칩에서 대규모 배포로 넘어가는 과제
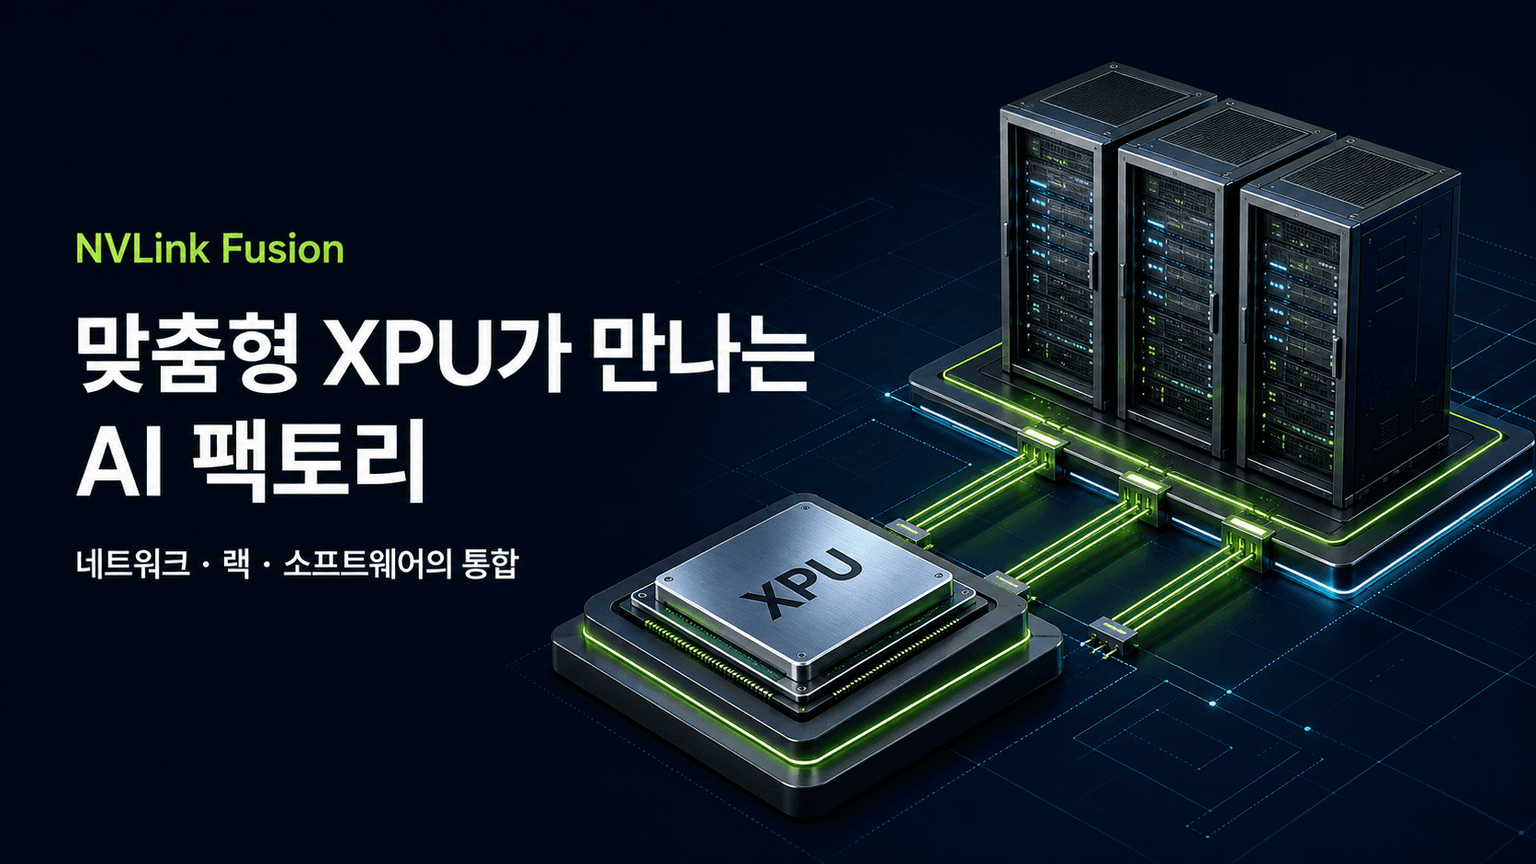
본문은 XPU를 만드는 것이 AI 팩토리 규모 배포의 첫 단계에 불과하다고 설명한다. 실제 배포에는 네트워킹, 랙 아키텍처, 전력, 냉각, 소프트웨어와 검증된 공급망을 아우르는 전체 플랫폼이 필요하다. 칩 조달, 고속 인터페이스 통합, 스케일업 네트워킹 검증, 랙 설계와 인증은 각각 시간·비용·위험을 더한다. NVIDIA는 NVLink Fusion을 맞춤형 XPUs와 CPUs를 자사 스택에 연결하는 고대역폭·저지연 기술로 소개한다. 이를 통해 반도체 업체가 프로세서 혁신에 집중하면서 기존 인프라를 활용할 수 있다는 것이 주장의 핵심이다.
3. MGX 공통 랙으로 인프라 활용
d-Matrix는 NVLink Fusion 채택을 통해 NVIDIA MGX 생태계의 성숙하고 검증된 랙 설계, 공급망, 전력 및 냉각 인프라를 활용할 수 있다. 본문은 공통 랙으로 표준화하면 데이터센터를 한 번 구축해 GPU·CPU·XPU를 지원할 수 있다고 설명한다. 프로세서 유형마다 별도 랙 아키텍처를 요구하지 않는다는 점이 이 접근의 주요 이점으로 제시된다. 이는 맞춤형 칩을 실제 대규모 시스템으로 전환할 때 발생하는 설계와 통합 부담을 줄이려는 방향이다. 다만 이 발표에는 d-Matrix가 절감할 구체적인 비용이나 배포 기간이 제시돼 있지 않다.
4. NVIDIA 시스템과 특화 추론의 병행 운용
d-Matrix는 NVIDIA NVLink를 이용해 자사 XPUs를 하나의 고대역폭·저지연 스케일업 도메인으로 연결할 계획이다. 해당 랙은 NVIDIA Vera Rubin NVL72 같은 GPU 기반 시스템과 함께 분리형 추론에 사용될 수 있다고 설명된다. d-Matrix는 NVIDIA Vera CPUs, NVIDIA ConnectX-9 SuperNICs, NVIDIA BlueField-4 DPUs와 NVIDIA Spectrum-X Ethernet 네트워킹도 통합할 계획이다. 본문은 이 기술들이 NVLink 및 MGX와 함께 특화 추론 배포의 기반을 제공한다고 강조한다. 목표는 유연하고 통합된 AI 팩토리 안에서 d-Matrix의 추론 시스템과 NVIDIA 시스템을 함께 운용하는 것이다.
5. 워크로드별 선택권과 성능·비용 주장
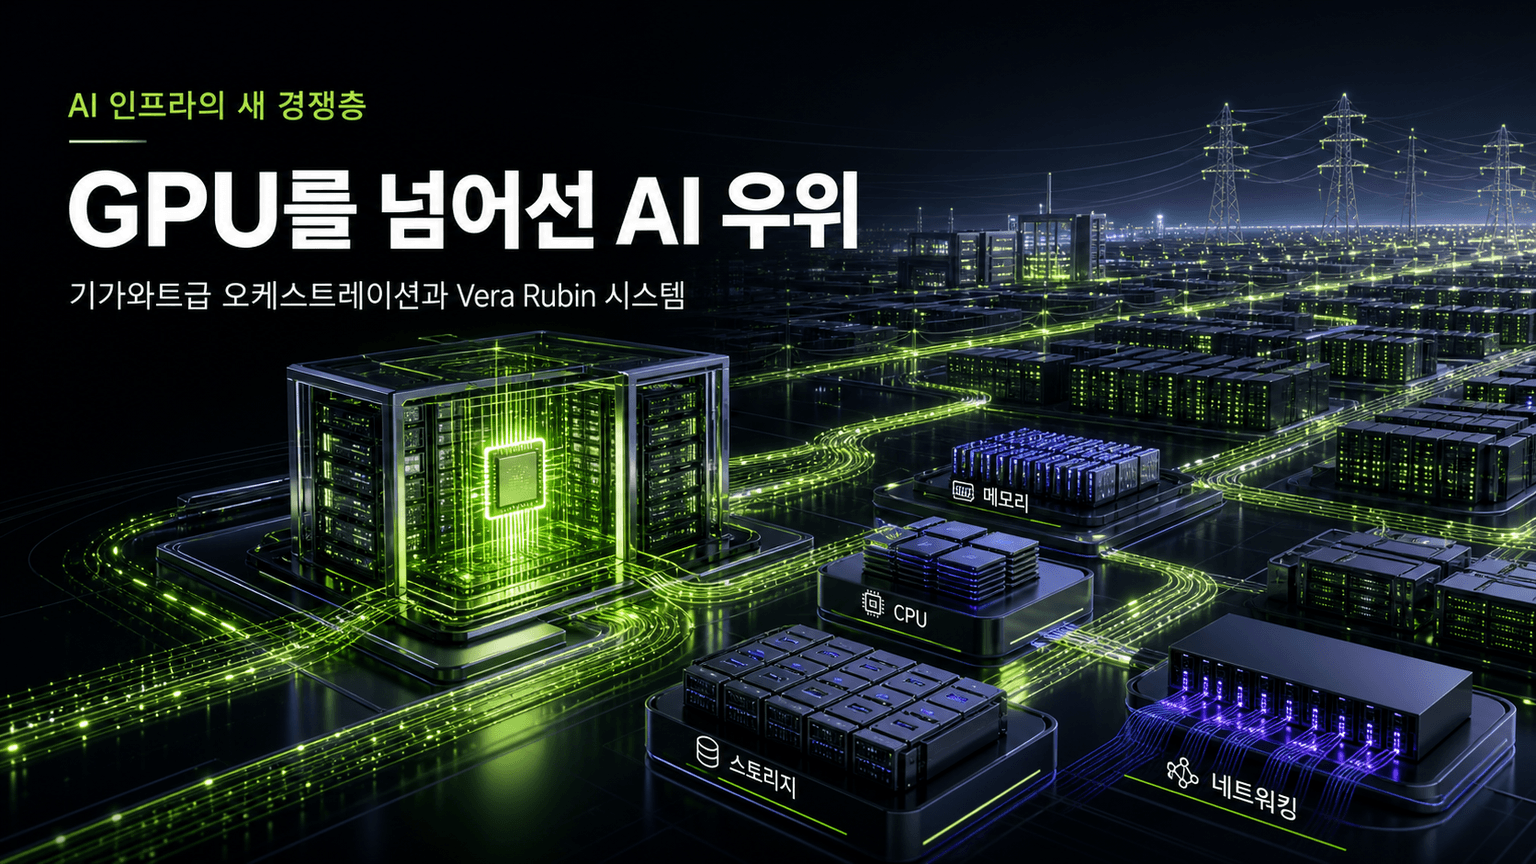
NVIDIA는 자사의 전체 스택 AI 팩토리 플랫폼에 NVIDIA Vera Rubin NVL72, Groq 3 LPX, Vera CPU 랙, Vera BlueField-4 STX 스토리지, Spectrum-6 SPX Ethernet 네트워킹이 포함된다고 소개한다. 이 플랫폼은 모든 AI 워크로드·모델·모델 아키텍처를 실행하면서 최고의 와트당 성능과 최저 토큰당 비용을 제공하도록 설계됐다고 주장한다. NVLink Fusion은 공통 플랫폼 안에서 워크로드에 적합한 연산 자원을 선택하고 NVIDIA 네트워킹·시스템·소프트웨어·글로벌 공급망을 활용하게 하는 수단으로 제시된다. NVIDIA는 이를 통해 d-Matrix 같은 업체가 성능을 높이고 시장 출시를 앞당기며 반맞춤형 AI 팩토리 배포 위험을 줄일 수 있다고 설명한다. 다만 본문은 이러한 기대효과를 뒷받침하는 정량 성능 비교나 실제 배포 결과를 제공하지 않는다.
🧾 핵심 주장 / 시사점
- 이번 발표는 추론 칩 자체의 혁신과 함께 네트워킹·랙·전력·냉각·공급망을 통합하는 능력이 대규모 배포의 핵심 조건임을 강조한다.
- NVIDIA가 제시하는 개방성은 특화 XPUs와 CPUs도 NVIDIA의 공통 인프라를 활용하도록 확장하는 방식이다.
- 워크로드별 연산 자원 선택과 인프라 공유는 주요 기대효과지만, 성능·비용 개선의 실제 수준은 발표 내용만으로 판단하기 어렵다.
✅ 액션 아이템
- Raptor XPUs의 NVLink Fusion 연결과 NVIDIA 구성요소 통합 계획의 실제 이행 여부를 확인한다.
- MGX 공통 랙이 GPU·CPU·XPU 지원과 배포 시간·비용·위험 감소에 기여하는지 검토한다.
- 와트당 성능·토큰당 비용의 정량 결과가 제시되면 발표의 기대효과와 실제 배포 성과를 비교한다.
❓ 열린 질문
- Raptor XPUs의 NVLink Fusion 연결과 NVIDIA 구성요소 통합은 언제 실제 배포로 이어지는가?
- MGX 공통 랙을 활용하면 별도 랙 아키텍처를 사용하는 경우보다 배포 시간·비용·위험이 얼마나 줄어드는가?
- NVIDIA Vera Rubin NVL72와의 분리형 추론에서 와트당 성능·토큰당 비용은 어떻게 나타나는가?