Build an end-to-end RFI questionnaire workflow using Amazon Quick Automate
Quick Summary
Amazon Quick Automate로 Amazon S3의 RFI 워크북에서 질문·분류·응답 유형을 추출해 CSV로 저장하고, 대화형 수정과 개발 환경 검증을 거쳐 Import/Export로 운영 환경에 이전하는 방법을 설명한다.

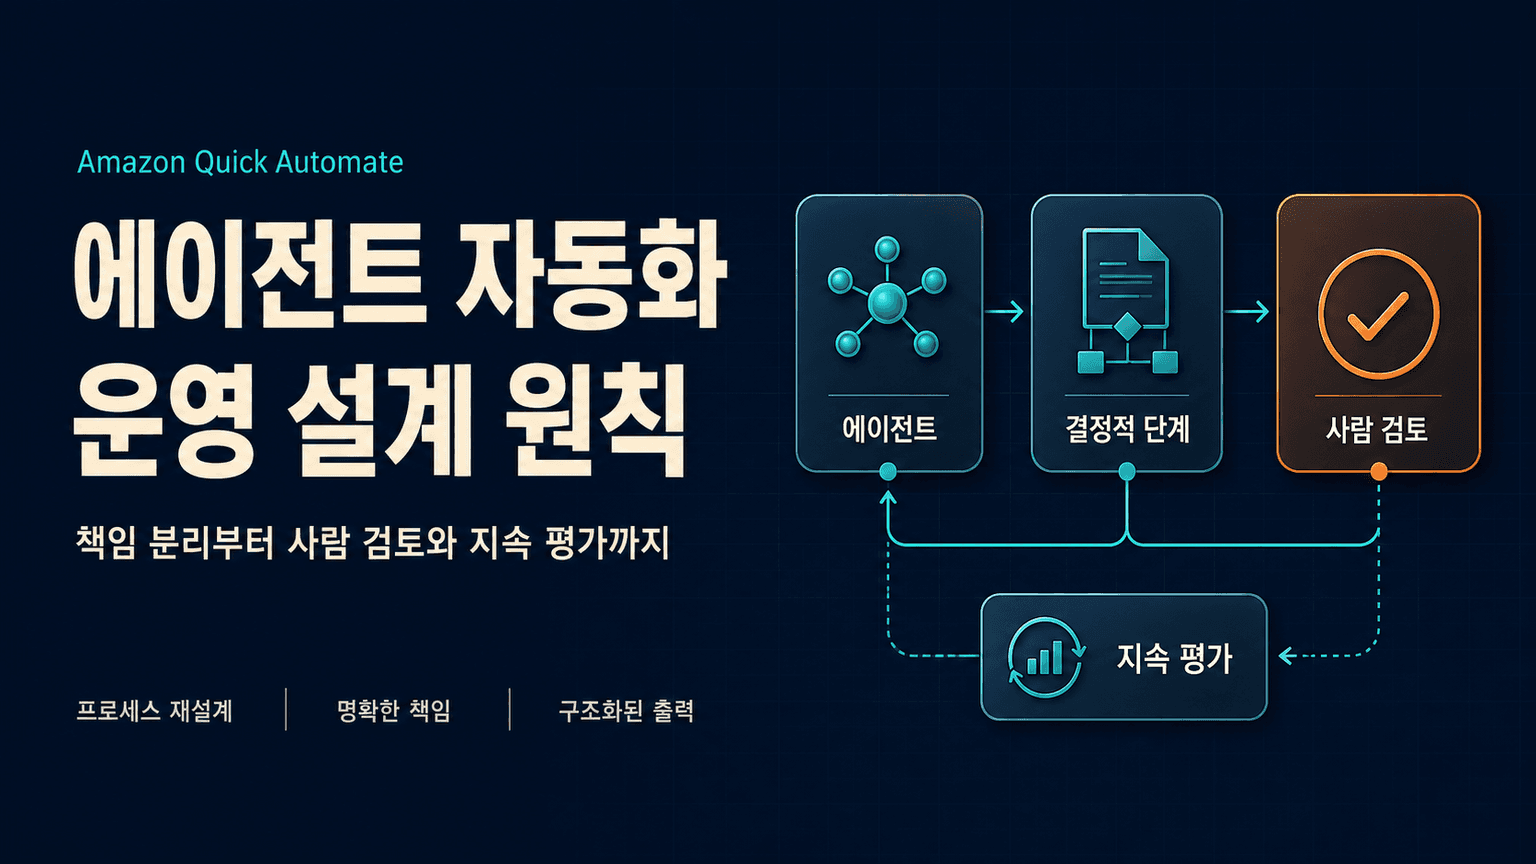
🖼️ 인포그래픽

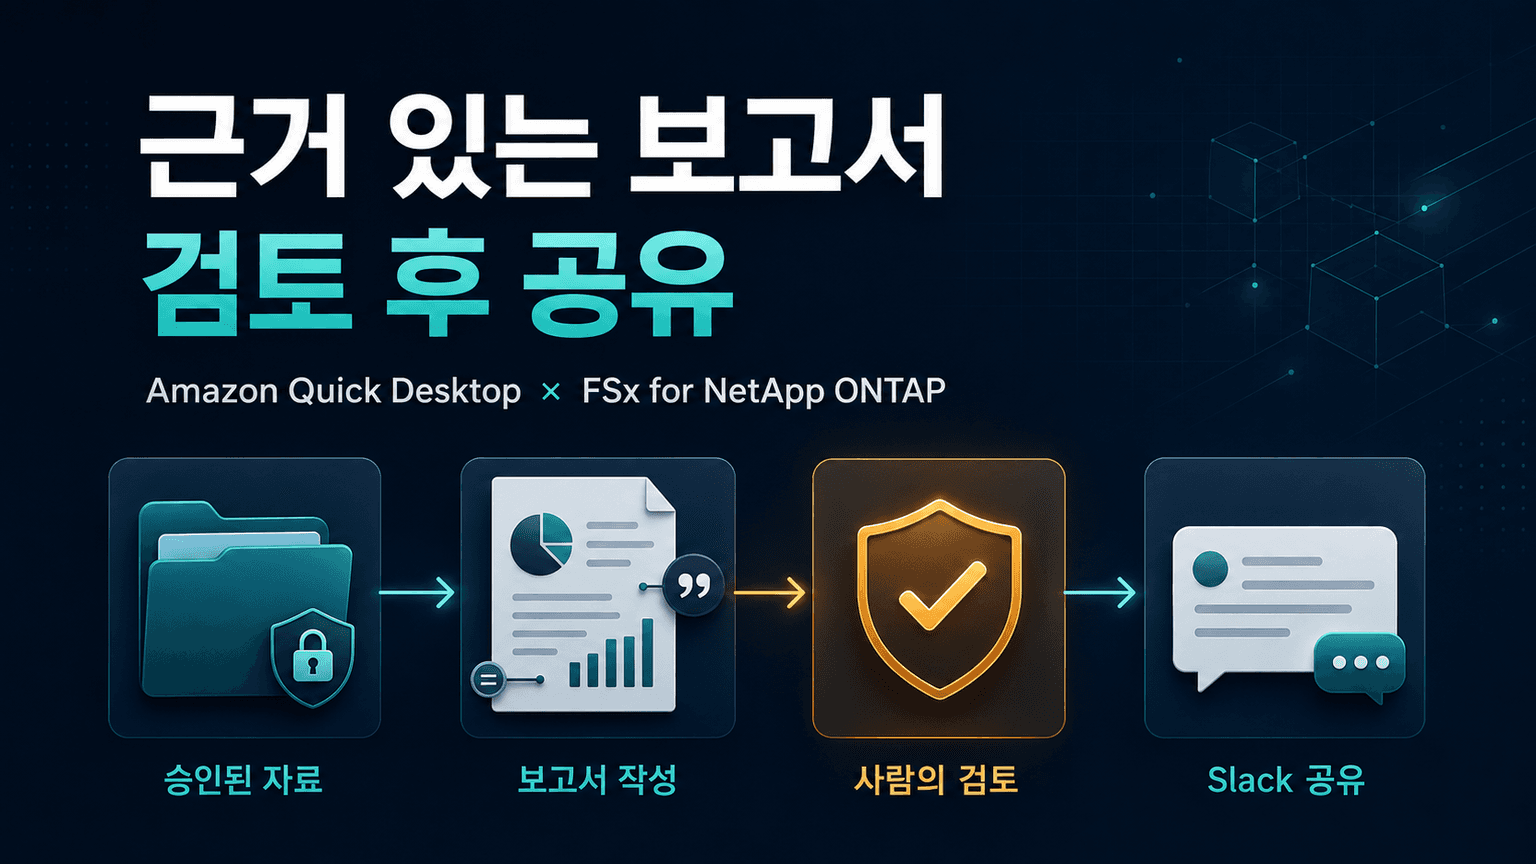
🖼️ 4컷 인포그래픽

💡 한 줄 요약
Amazon Quick Automate로 Amazon S3의 RFI 워크북에서 질문·분류·응답 유형을 추출해 CSV로 저장하고, 대화형 수정과 개발 환경 검증을 거쳐 Import/Export로 운영 환경에 이전하는 방법을 설명한다.
📌 핵심 요약
- 일반적인 기업은 연간 수백 건의 RFI 설문을 처리할 수 있으며, 여러 탭과 계층형 질문, 분류 메타데이터, 다양한 응답 유형을 수작업으로 처리하면 반복적인 협업과 응답 지연, 형식 변경에 따른 오류가 발생할 수 있다.
- Amazon Quick Automate는 자연어 요구사항으로 실행 가능한 워크플로를 생성한다. 이 예제는 Amazon S3에서 RFI 워크북을 읽고 질문을 구조화해 CSV로 저장하며, 일반적인 시나리오에서는 사용자 정의 코드가 필요하지 않다.
- 준비 조건은 Amazon Quick Automate 접근 권한이 있는 Amazon Quick Enterprise 구독, Amazon Quick 애플리케이션과 동일한 AWS Region의 S3 버킷, IAM 및 S3 기초 지식이다. IAM 역할에는 quicksight.amazonaws.com의 역할 수임을 허용하는 신뢰 정책과 대상 버킷의 s3:GetObject, s3:PutObject, s3:ListBucket 권한이 필요하다.
- 구체적인 프롬프트 예제는 SampleDepartment_Version2.xlsx의 Strategy 시트에서 번호와 들여쓰기로 주질문·하위 질문을 식별하고 Serial Number, Category, Question, Response Type 열을 구성한다. 검증에서는 질문 누락 여부, 원본 헤더와 분류의 정확한 일치, 하위 질문의 상위 맥락 포함, 응답 유형의 원형 보존을 확인한다.
- 생성형 AI가 만드는 단계와 표현은 실행마다 달라질 수 있으므로 수정할 때마다 재실행해 검증하고 누락·중복·형식 불일치의 처리 방식을 명시한다. 검증한 버전은 Import/Export로 운영 계정이나 대상 AWS Region에 이전할 수 있지만, 내보내기 링크에는 유효기간이 있으며 제공된 원문은 가져오기 절차 도중에 끊긴다.
🧩 주요 포인트
- 계층형 RFI를 독립적인 CSV 레코드로 변환 → 하위 질문에도 상위 맥락을 결합해야 후속 팀이 질문의 의미를 해석할 수 있다.
- 자연어 기반 워크플로 생성과 대화형 수정 → 구현 부담을 줄일 수 있지만, 생성 결과의 변동성 때문에 원본 대조와 단계별 검증이 중요하다.
- 동일한 AWS Region의 S3 연결 및 IAM 권한 구성 후 검증 버전 이전 → 데이터 접근 준비와 개발 환경 검증이 Import/Export를 통한 운영 적용의 선행 조건이다.
🧠 상세 정리
1. RFI 설문 처리의 복잡성과 자동화 목표
원문은 기업이 처리하는 정보 요청서인 RFI 설문의 양과 형식적 복잡성을 자동화의 출발점으로 제시한다. 일반적인 기업은 연간 수백 건의 설문을 처리할 수 있고, 각 문서는 여러 탭에 계층형 질문, 분류 메타데이터, 다양한 응답 유형을 담을 수 있다. 이를 사람이 추출하고 구조화하며 처리하려면 반복적인 협업이 필요해 응답이 늦어지고, 설문 형식이 바뀔 때마다 오류가 생길 수 있다. 예제의 목표는 질문마다 분류와 응답 유형을 보존한 구조화된 데이터를 만들어 후속 팀이 이해하고 활용할 수 있게 하는 것이다. 구체적인 구현 범위는 Amazon S3에 저장된 워크북을 읽어 질문 데이터를 추출·정리하고 같은 서비스에 CSV 결과를 쓰는 과정이다.
2. Amazon Quick Automate의 역할과 전체 흐름
Amazon Quick Automate는 지원되는 기업 프로세스에서 부서와 시스템, UI·API 상호작용, 타사 시스템에 걸친 다중 에이전트 자동화를 제공한다. 사용자가 처리 목표를 자연어로 설명하면 수집, 변환, 검증, 출력에 해당하는 실행 가능한 워크플로를 생성할 수 있고, 대화를 통해 이를 수정할 수 있다. 원문은 이 방식이 유지보수 부담과 RFI 응답 시간, 형식 불일치 및 오류를 줄이는 데 도움이 될 수 있다고 설명하며, 새로운 설문 형식에는 자연어 지침을 갱신해 대응할 수 있다고 제시한다. 예제는 S3 액션 커넥터 연결, 자동화 그룹 구성, 프로젝트 생성, 처리 로직 설명, 대화형 개선, 개발 환경 검증, Import/Export를 통한 이전 순서로 진행된다. 일반적인 시나리오에서는 사용자 정의 코드 없이 구현할 수 있다고 설명하지만, 최신 제공 리전과 비용은 각각 AWS Regions 및 Amazon Quick·Amazon S3 요금 안내에서 확인하도록 한다.
3. 구독·리전 조건과 IAM 접근 권한
실습에는 Amazon Quick Automate 접근 권한이 포함된 Amazon Quick Enterprise 구독과 Amazon Quick 애플리케이션이 있는 AWS Region의 S3 버킷이 필요하다. 사용자는 IAM 역할·정책과 S3 버킷·접두사·객체의 기본 개념에도 익숙해야 한다. 데이터 접근을 위해서는 IAM 콘솔에서 사용자 정의 신뢰 정책을 사용하는 역할을 만들고, 서비스 주체 quicksight.amazonaws.com에 sts:AssumeRole을 허용한다. 이어 대상 버킷에 대한 s3:GetObject, s3:PutObject, s3:ListBucket 권한을 부여하는 정책을 연결한다. 역할 이름의 예시는 QuickAutomate-S3-Role이며, 생성 후 복사한 역할 ARN은 다음 단계에서 S3 커넥터를 설정하는 데 사용된다.
4. S3 커넥터와 자동화 그룹 구성
S3 연결은 Amazon Quick 콘솔의 사용자 아이콘에서 Manage Account를 열고 Permissions의 AWS Actions로 이동해 설정한다. New action에서 Amazon S3를 선택한 뒤 ExampleBucket-S3-Connection과 같은 커넥터 이름과 설명을 입력하고, 앞서 만든 IAM 역할의 ARN을 붙여 넣는다. 콘솔은 역할의 신뢰 정책을 자동으로 검증하므로 연결 성공 상태를 확인한 다음 워크플로를 작성하고 실행할 사용자 및 그룹과 커넥터를 공유한다. 이어 Automations의 Create Group에서 RFI-Processing-Group과 같은 자동화 그룹을 생성한다. 그룹의 Add actions 단계에서는 앞서 구성한 S3 연결을 선택하며, 이렇게 연결과 그룹을 준비한 다음 해당 그룹을 사용하는 자동화 프로젝트를 만들게 된다.
5. 프로젝트 생성과 자연어 처리 요구사항
자동화 프로젝트는 처리 로직을 설명하고 생성된 워크플로를 보관하는 공간으로, Automations의 Projects 탭에서 Create Project를 선택해 만든다. 프로젝트 이름과 자동화 그룹을 지정하고 필요하면 설명과 기존 문서를 추가하며, 선택 사항인 Business case에는 건당 절약 시간, 연간 처리 건수, 우선순위, 목표 출시일을 입력해 투자 수익 추적에 활용할 수 있다. 프로젝트 생성 후에는 Summary, Versions, Deployments 탭과 현재 상태를 보여주는 패널이 나타나며, 프롬프트 영역에 요구사항을 쓰거나 파일로 올릴 수 있다. 예시 프롬프트는 ExampleBucket-S3-Connection으로 연결해 sample-folder의 SampleDepartment_Version2.xlsx를 읽고 Strategy 시트의 설문 질문을 추출하도록 지정한다. 번호와 들여쓰기로 주질문과 하위 질문을 구분하고 Serial Number, Category, Question, Response Type 열로 구조화한 뒤, 같은 버킷의 output-folder에 CSV를 저장하도록 출력 위치까지 명시한다.
6. 생성된 워크플로 검토와 원본 대조
프롬프트를 제출하면 AI 어시스턴트는 S3 연결과 워크북 다운로드, 대상 시트 및 헤더 읽기에 해당하는 데이터 읽기 단계를 생성한다. 추출·변환 단계에서는 번호와 들여쓰기로 주질문과 하위 질문을 식별하고 열 헤더에서 분류 메타데이터를 가져온다. 출력 구조화 단계는 상위 질문의 맥락을 결합해 하위 질문을 독립적인 레코드로 만들고 출력 스키마를 정의하며, 마지막 단계는 지정된 S3 위치에 CSV를 저장한다. 생성형 AI의 특성상 단계의 구체적인 구성과 문구는 실행마다 달라질 수 있고, 예시와 조금 다른 워크플로가 나타날 수 있다고 원문은 명시한다. Run으로 실행한 뒤에는 주질문과 하위 질문이 모두 추출됐는지, 분류가 원본 열 헤더와 정확히 같은지, 하위 질문에 상위 맥락이 포함됐는지, 응답 유형이 원본 그대로 유지됐는지를 검증한다.
7. 대화형 수정과 예외 상황의 명시
출력이 기대와 다르면 대화 인터페이스에서 문제가 있는 단계를 지목하고 원하는 동작을 설명해 수정한다. 원문은 Strategy 시트를 읽는 단계에서 열 헤더를 메타데이터로 수집하도록 요청하거나, 분류 추출에 정확한 원본 헤더 문구를 사용하도록 요청하는 예시를 제시한다. 하위 질문 변환 단계에서 상위 맥락을 질문 본문에 결합하도록 요구하는 것도 구체적인 개선 사례다. 개선 과정은 기대 결과와 출력의 차이 식별, 해당 단계의 변경 요청, 수정된 워크플로 검토, 재실행과 수정 확인의 순환으로 구성된다. 운영 환경으로 이전하기 전에는 여러 수정을 한꺼번에 모으기보다 수정할 때마다 실행해 결과를 확인하고, 데이터 누락·중복·형식 불일치가 발생했을 때의 처리 동작도 명시하도록 권고한다.
8. 검증 버전의 Import/Export와 원문 범위
Amazon Quick Automate의 Import/Export는 사전 운영 환경에서 운영 환경으로 검증 버전을 통제해 이전하고, AWS Regions 간에 일관되게 재사용하기 위한 기능으로 소개된다. 내보내기는 원본 자동화의 Versions에서 검증한 릴리스에 대해 Export version을 선택하고 생성된 버전 링크를 복사하는 방식이다. 이 링크는 일정 기간이 지나면 만료되므로 신속히 사용하거나 만료 시 새 링크를 생성해야 하지만, 원문에는 구체적인 유효기간 수치가 없다. 가져오기는 대상 계정 또는 AWS Region에서 프로젝트를 열거나 생성한 뒤 Import version을 선택하고, 버전 링크를 붙여 넣어 Start를 누르는 순서까지 제시된다. 제공된 원문은 버전 세부정보 검토를 안내하는 문장 도중에 끊기므로, 이후의 가져오기 완료 절차나 운영 배포 결과는 확인할 수 없다.
🧾 핵심 주장 / 시사점
- RFI 구조화의 품질은 질문 추출 여부뿐 아니라 분류 문구, 상위 질문의 맥락, 응답 유형이 함께 보존되는지에 달려 있다.
- 자연어는 최초 워크플로 생성과 오류 수정에 모두 쓰이지만, 생성 결과가 달라질 수 있으므로 실행 결과를 원본과 대조하는 검증이 계속 필요하다.
- 전체 목표는 여러 탭을 가진 워크북 처리이지만 구체적인 프롬프트는 Strategy 시트를 지정하므로, 이 예제만으로 모든 탭의 자동 순회 동작이 확인되지는 않는다.
✅ 액션 아이템
- Amazon Quick Enterprise 구독, 동일한 AWS Region의 S3 버킷, IAM 역할의 신뢰 정책 및 s3:GetObject·s3:PutObject·s3:ListBucket 권한 충족 여부 확인.
- Strategy 시트의 CSV 결과에서 질문 누락, 분류와 원본 헤더의 일치, 하위 질문의 상위 맥락, 응답 유형 보존 여부 검증.
- 대화형 수정마다 개발 환경에서 재실행하고, 검증한 버전의 Import/Export 이전 시 내보내기 링크의 유효기간 확인.
❓ 열린 질문
- Strategy 시트에서 검증한 추출·구조화 방식은 다른 탭의 계층형 RFI에도 적용 가능한가?
- 누락·중복·형식 불일치가 발생할 때 Amazon Quick Automate에 어떤 처리 동작을 명시해야 하는가?
- Import/Export의 내보내기 링크 유효기간과 원문에서 끊긴 이후의 가져오기 절차는 무엇인가?