Best Semantic Search APIs for Building AI Applications in 2026
Quick Summary
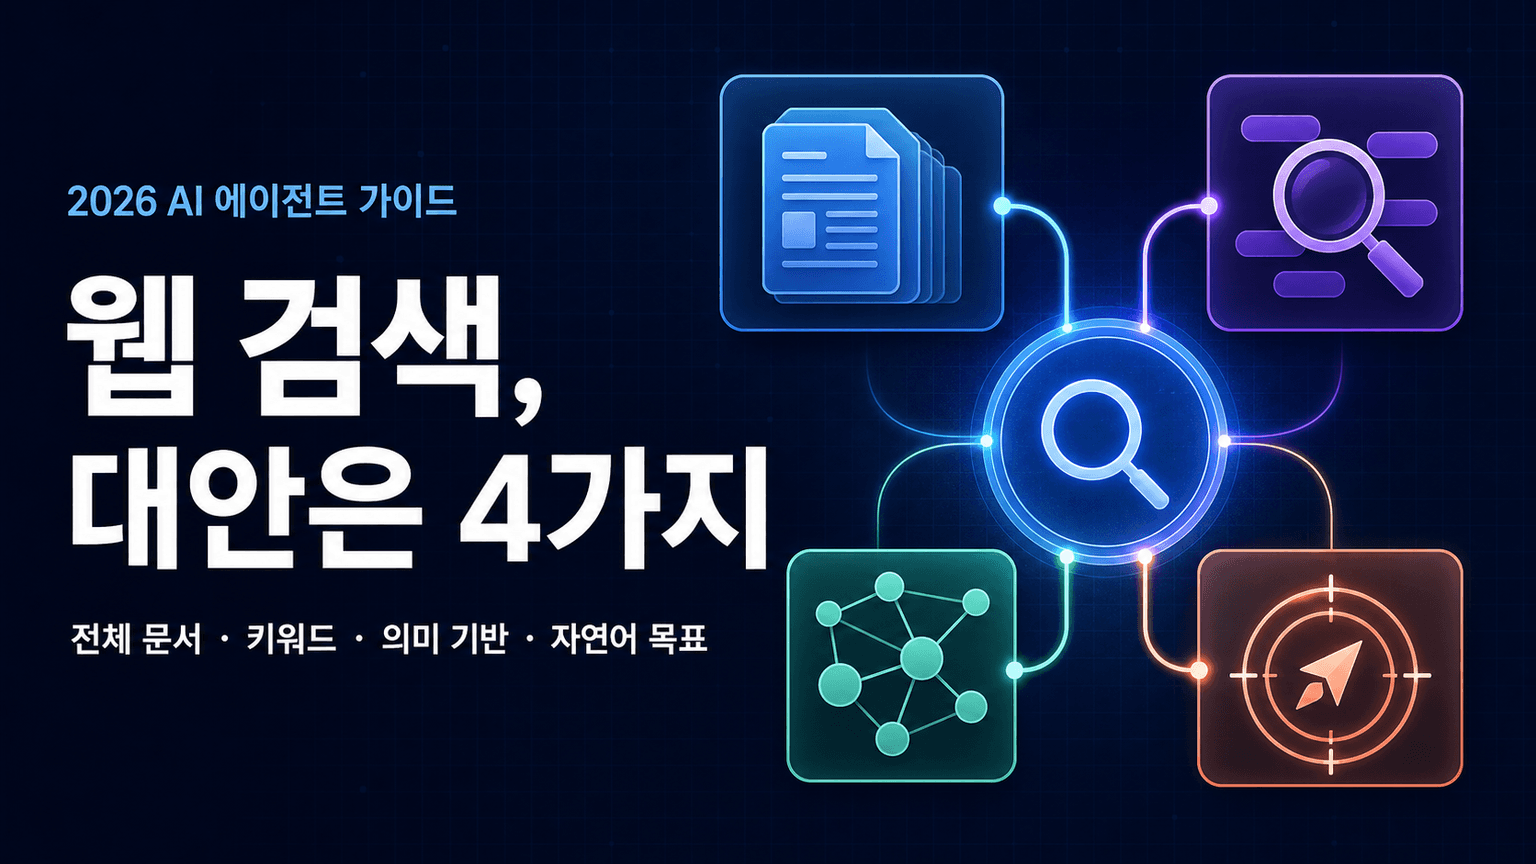
2026년 시맨틱 검색 API는 RAG와 자율 에이전트의 핵심 기반으로 소개되며, 웹 데이터·내부 문서 등 데이터 원천과 검색·추출·재순위화·벡터 저장의 역할에 맞춰 도구를 선택하는 것이 중요하다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
2026년 시맨틱 검색 API는 RAG와 자율 에이전트의 핵심 기반으로 소개되며, 웹 데이터·내부 문서 등 데이터 원천과 검색·추출·재순위화·벡터 저장의 역할에 맞춰 도구를 선택하는 것이 중요하다.
📌 핵심 요약
- 원문은 Microsoft가 2025년 8월 Bing Search APIs를 종료한 일을 전환점으로 삼아, 자연어 처리와 벡터 임베딩으로 검색 의도를 파악하는 시맨틱 검색의 중요성을 설명한다.
- 주요 활용처는 RAG, 자율 에이전트, 내부 지식 검색, 전자상거래이며, 관련성 높은 문맥 검색과 LLM이 읽기 좋은 콘텐츠 형식이 핵심 요구로 제시된다.
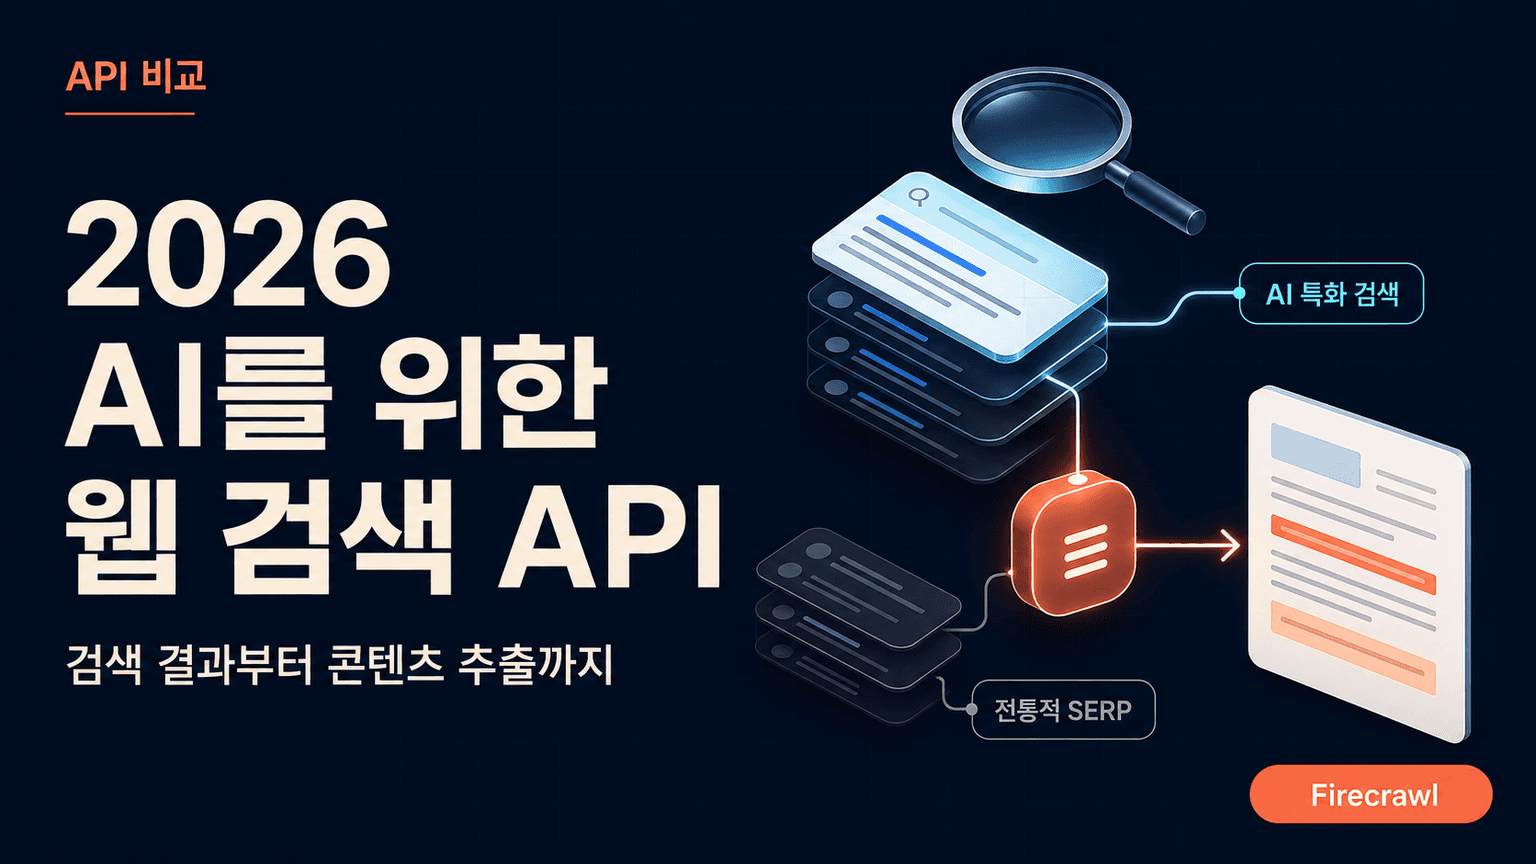
- Firecrawl은 웹 검색과 전체 페이지 콘텐츠 추출을 한 번의 호출로 결합하고 markdown·HTML·구조화된 JSON을 제공한다. 원문에 제시된 가격은 월 16달러부터 1,000크레딧이며, 무료 테스트 등급도 있다.
- 원문이 인용한 AIMultiple 벤치마크는 8개 API를 실제 AI/LLM 질의 100개로 평가했다. Firecrawl은 Agent Score 14.58로 전체 2위이자 Brave Search의 14.89와 통계적으로 동률이며, 평균 관련성 점수는 4.30/5로 가장 높았다고 한다.
- Exa는 자체 검색 인덱스와 신경망 기반 연구 검색, 500ms 미만의 Fast 모드·Auto·Deep 모드를 제공하며 SimpleQA 정확도 94.9%를 내세운다. OpenAI Embeddings는 RAG·사용자 정의 인덱스, Cohere는 기존 검색의 재순위화, Pinecone은 대규모 벡터 저장 용도로 소개된다.
🧩 주요 포인트
- 벡터 저장·검색과 질의 이해·순위 결정은 역할이 다름 → 웹 데이터와 내부 문서 중 무엇을 검색하는지, 어느 계층을 직접 구현할지에 따라 선택 기준이 달라진다.
- Firecrawl의 검색·전체 페이지 추출 통합 → 별도 스크래퍼 유지와 콘텐츠 전처리 부담을 줄일 수 있지만, 자체 호스팅에는 Docker Compose와 운영 노력이 필요하다.
- Firecrawl의 AIMultiple 성과와 Exa의 SimpleQA 정확도는 서로 다른 평가 근거 → 수치만으로 우열을 단정하기보다 전체 콘텐츠 검색과 연구형 검색 등 실제 용도에 맞춰 해석해야 한다.
🧠 상세 정리
1. Bing 종료를 계기로 제시한 검색 전환
Ninad Pathak은 Microsoft가 2025년 8월 Bing Search APIs를 종료한 사건을 출발점으로, LLM 시대에 맞는 검색 도구로의 전환을 설명한다. 저자는 처음에는 당황했지만, 기존 도구가 LLM을 위해 설계된 것이 아니었으며 종료가 새로운 시맨틱 검색 도구로 이동하는 계기가 됐다고 평가한다. 몇 달간 자신의 RAG 파이프라인을 수정하고 재구축한 경험을 들며, 키워드 일치와 의미 기반 검색의 차이가 뚜렷해졌다고 주장한다. 예를 들어 저렴한 노트북을 찾는 질의에 노트북 케이스가 아니라 예산에 맞는 Chromebook 정보를 제공하는 차이를 제시한다. 도구를 잘못 고르면 7월까지 인프라를 다시 뜯어고칠 수 있다는 표현은 저자의 경고성 전망이며, 검증된 일정이나 보편적인 결과로 제시된 것은 아니다.
2. 시맨틱 검색과 벡터 검색의 역할
시맨틱 검색 API는 자연어 처리와 고차원 벡터 임베딩을 이용해 사용자가 입력한 표현 뒤의 의도를 파악하는 방식으로 설명된다. 임베딩 모델은 텍스트를 수치 벡터로 변환하고, 비슷한 개념들이 가까이 모이는 공간에서 질의와 인접한 문서 벡터를 찾는다. 원문은 변호사가 부당해고를 검색했을 때 정확히 같은 단어가 없어도 임의고용 원칙 위반에 관한 문서를 찾는 사례를 든다. 여기서 벡터 데이터베이스는 저장과 검색의 기반을 담당하고, 시맨틱 검색 플랫폼은 질의 이해·순위 결정·결과 형식화 같은 기능을 더한다. 따라서 두 범주는 관련돼 있지만 서로 바꿔 쓸 수 있는 동일한 도구가 아니며, 필요한 기능이 어느 계층에 속하는지 구분해야 한다는 것이 원문의 핵심 설명이다.
3. RAG와 자율 에이전트의 검색 요구
원문은 2026년 시맨틱 검색의 활용이 검색창 개선을 넘어 추론 중심 AI 애플리케이션의 기반으로 확장됐다고 설명한다. RAG에서는 검색 결과가 부실하면 관련 없는 데이터가 언어 모델에 전달되고, 모델이 확신에 찬 잘못된 답변을 생성할 위험이 있다고 지적한다. 이를 줄이기 위한 요구로 질의 의도 이해, 문맥상 관련 있는 청크 검색, LLM 소비에 맞춘 결과 형식화를 제시한다. 특히 원시 HTML 대신 정제된 markdown을 받으면 전처리 시간과 토큰 비용을 줄일 수 있다고 주장하지만, 절감 규모를 수치로 제시하지는 않는다. 자율 에이전트는 필요한 데이터를 스스로 찾아야 하므로 검색의 역할이 더 커지며, CUDA 성능이나 NVENC 인코딩 같은 개념을 따라 탐색해 종합적인 답을 수집하는 사례가 소개된다.
4. 내부 지식 검색과 전자상거래
내부 지식 검색에서는 여러 사람이 작성한 문서의 제목과 표현이 일관되지 않다는 문제가 출발점이다. 직원이 문서 제목을 WFH Policy로 기억하는지 Remote Work Guidelines로 기억하는지에 관계없이 자연어로 필요한 내용을 찾을 수 있어야 한다는 설명이다. 한 달 동안 스페인에서 일할 수 있는지를 묻는 질문을 국제 원격근무 정책과 연결하는 사례가 이를 보여주며, 문서 관리의 표준화 자체가 불필요해지는 것은 아니라고 덧붙인다. 전자상거래에서는 빨간 드레스를 검색했는데 빨간 신발이 나오는 단순 키워드 일치의 한계를 지적한다. 대신 10월 결혼식 하객 의상을 요청하면 스타일·핏·행사 맥락을 이해해 격식 있는 옷과 가을 색상을 찾는 개인 쇼핑 도우미 같은 경험을 제공하고, 전환율 개선으로 이어질 수 있다고 주장한다.
5. 도구 비교의 기준과 원문 범위
원문 앞부분의 비교표는 하나의 순위만 제시하기보다 검색·추출·임베딩·재순위화·저장의 서로 다른 역할을 함께 보여준다. Firecrawl은 LLM용 웹 검색과 콘텐츠 추출 및 Alexandria 데이터 제공자 연동, Exa는 연구 에이전트와 의미 기반 발견에 적합한 도구로 소개된다. OpenAI Embeddings는 RAG와 사용자 정의 인덱스용으로 분류되며 콘텐츠 추출은 직접 준비해야 하고, Cohere는 기존 검색을 교체하지 않고 재순위화로 개선하는 선택지로 설명된다. Pinecone은 수십억 개 벡터를 저장하는 규모 대응에 초점을 두지만, 나머지 구성은 개발자가 구현해야 한다는 제약이 강조된다. 이 비교가 뒷받침하는 선택 원칙은 웹 데이터와 내부 문서 검색에 필요한 도구가 다르다는 것이며, 제공된 본문은 Exa 코드 예시 도중 끝나므로 뒤쪽 제품별 상세 설명까지 확인할 수는 없다.
6. Firecrawl의 검색과 추출 통합
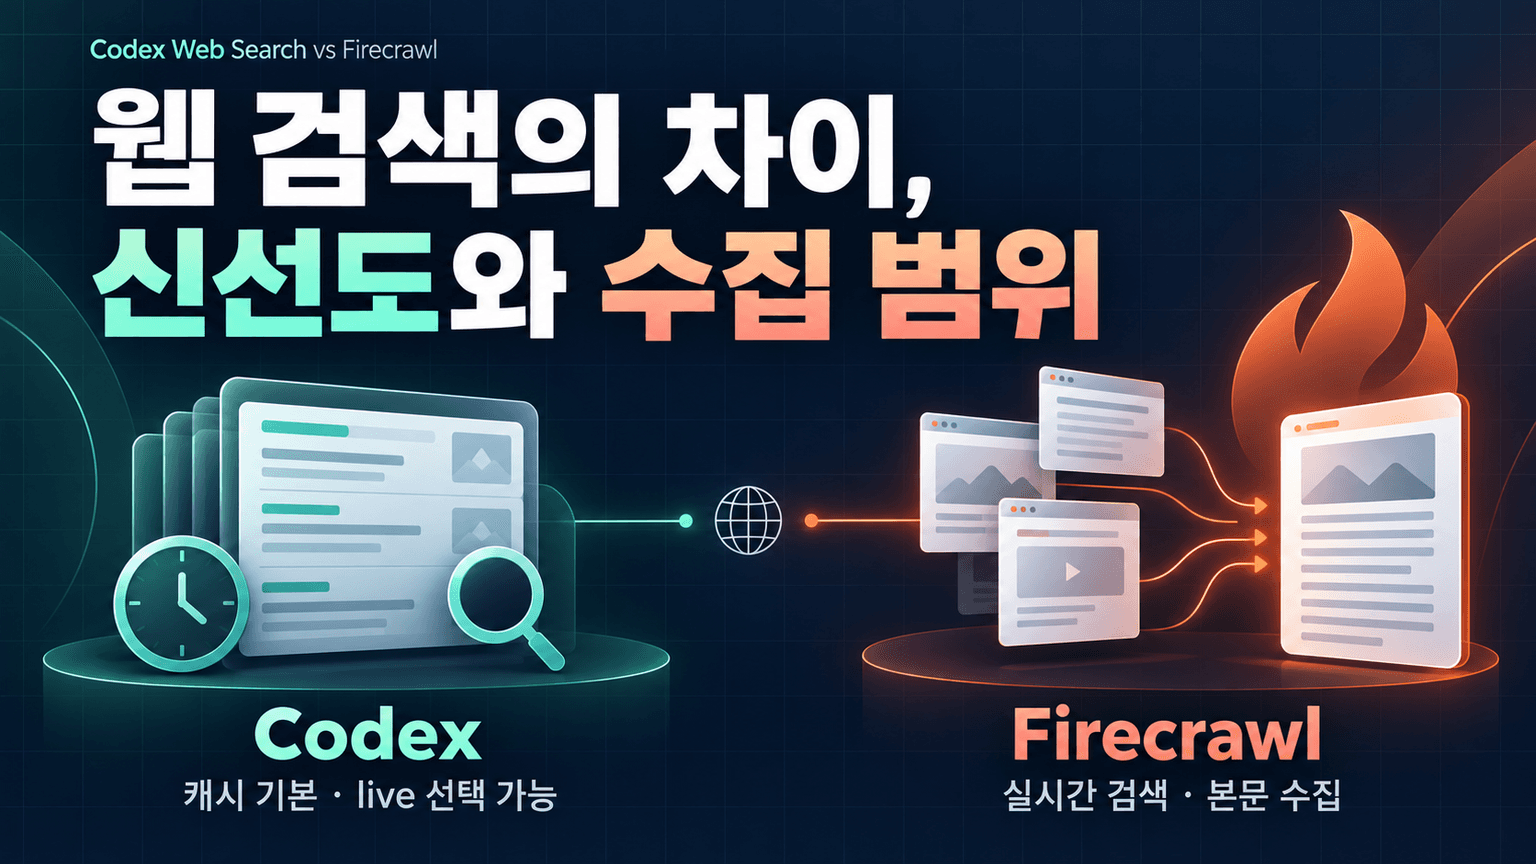
저자는 Firecrawl이 자사 도구라는 이해관계를 먼저 밝히고, 검색과 스크래핑 파이프라인을 따로 운영하는 부담을 줄이는 점을 주요 장점으로 내세운다. 링크만 반환하는 검색 API를 쓰면 스크래퍼, 프록시 교체, 동적 콘텐츠 추출, HTML 파싱을 별도로 처리해야 하지만, Firecrawl은 검색 결과와 전체 페이지 콘텐츠를 한 번의 호출로 제공한다고 설명한다. 출력 형식은 markdown·HTML·구조화된 JSON이며, GitHub·연구 논문·PDF·일반 웹을 대상으로 한 범주별 검색과 tbs 매개변수를 통한 시간 필터도 소개된다. sources에 alexandria를 포함하면 공식 API, 라이선스 계약을 맺은 발행사, Firecrawl 자체 인덱스의 데이터 도구가 각각의 입력과 가격 정보와 함께 반환된다고 한다. Python 예시는 검색 결과 수를 3개로 제한하고 markdown 추출을 요청한 뒤 제목·URL·콘텐츠 미리보기를 표시해 통합 호출의 사용 방식을 보여준다.
7. Firecrawl의 성과 주장과 운영 제약
원문이 독립 평가로 인용한 AIMultiple 벤치마크는 8개 검색 API를 실제 AI/LLM 질의 100개로 비교했고, Firecrawl은 Agent Score 14.58로 전체 2위를 기록했다고 한다. 이는 14.89를 기록한 Brave Search와 통계적으로 동률이며, 평균 관련성 점수는 4.30/5로 가장 높고 깊이 있는 콘텐츠 검색 작업에서 가장 우수했다고 설명한다. 저자는 이 결과를 전체 페이지 추출이 짧은 검색 요약만 제공하는 방식보다 유리한 작업과 연결하며, 웹 기반 RAG와 경쟁 정보 수집 등을 적합한 용도로 제시한다. 가격은 월 16달러부터 1,000크레딧이고 무료 테스트 등급이 있으며, 자체 호스팅에는 Docker Compose와 운영 시간이 필요해 데이터 보관 위치나 규모에 따른 비용이 중요할 때 검토하도록 권한다. 다만 GitHub 스타 수는 비교표의 122k+, 본문의 180K 초과, 페이지 상단의 185.2K로 표기가 서로 달라 하나의 일관된 수치로 확정하기 어렵다.
8. Exa의 연구 중심 검색과 제시된 근거
Exa는 AI가 소비할 검색 결과를 위해 자체 인덱스를 구축했으며, 신경망 모델로 지식 간 연결을 평가하는 도구로 소개된다. 원문은 이를 SEO와 인기도를 중심으로 페이지 순위를 정한다는 Google에 대한 설명과 대비하고, 기술·연구 질의에서는 인기 있는 답이 반드시 적절한 답은 아니라고 주장한다. 인용 관계와 의미적 유사성을 이해해 특정 페이지와 비슷한 자료를 찾거나 여러 층위의 연구 질문에 대응하는 능력이 주요 강점으로 제시된다. 기능으로는 500ms 미만의 Fast, Auto, 에이전트가 여러 단계로 검색하는 Deep 모드가 소개되며, SimpleQA 정확도 94.9%는 Exa가 내세우는 성과로 서술된다. Python SDK는 비동기 작업을 지원하고, 예시는 연구 논문 검색 및 본문과 관련 발췌문을 함께 가져오는 호출을 보여주지만, 제공된 원문이 코드 도중 잘려 이후 설명과 세부 제약은 확인되지 않는다.
🧾 핵심 주장 / 시사점
- 비교 대상은 완성형 웹 검색 서비스부터 임베딩·재순위화·벡터 저장 구성요소까지 섞여 있으므로, 제품 순위에 앞서 필요한 기능 계층을 구분하는 것이 중요하다.
- 웹 기반 RAG에서는 검색 결과의 관련성뿐 아니라 전체 본문 확보와 출력 형식도 구현 부담을 좌우하므로, 검색과 추출을 결합하는 방식이 실질적인 선택 기준이 된다.
- Firecrawl에 대한 저자의 이해관계, 원문 내부의 스타 수 불일치, 제품별로 다른 벤치마크와 잘린 본문 범위를 고려하면 이 글만으로 모든 제품의 우열을 확정하기는 어렵다.
✅ 액션 아이템
- 웹 데이터와 내부 문서 중 주요 데이터 원천을 구분하고, 검색·추출·재순위화·벡터 저장 중 필요한 역할을 정리한다.
- Firecrawl 무료 테스트 등급으로 RAG에 필요한 콘텐츠 관련성과 markdown 추출 결과를 검토하고, 월 16달러·1,000크레딧 조건의 적합성을 판단한다.
- Firecrawl의 AIMultiple 성과와 Exa의 SimpleQA 정확도를 구분해 해석하고, 전체 콘텐츠 검색과 연구형 검색 중 실제 용도에 맞춰 비교한다.
❓ 열린 질문
- 구축하려는 RAG나 자율 에이전트의 주요 데이터 원천은 웹 데이터인가, 내부 문서인가?
- Firecrawl의 검색·전체 페이지 추출 통합이 필요한가, Cohere의 재순위화로 기존 검색을 개선하는 것이 우선인가?
- Exa의 Fast·Auto·Deep 모드 중 실제 연구형 검색의 속도와 탐색 요구에 적합한 모드는 무엇인가?