Pathway’s brain-inspired architecture development on Amazon SageMaker HyperPod
Quick Summary
Pathway는 중간 추론 텍스트 없이 잠재 공간에서 반복 추론하는 BDH 기반 BDH CQ를 Amazon SageMaker HyperPod에서 개발했으며, ARC AGI 1에서 과제당 US $0.0007의 비용으로 29.5% pass@2를 달성했다고 보고했다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
Pathway는 중간 추론 텍스트 없이 잠재 공간에서 반복 추론하는 BDH 기반 BDH-CQ를 Amazon SageMaker HyperPod에서 개발했으며, ARC-AGI-1에서 과제당 US $0.0007의 비용으로 29.5% pass@2를 달성했다고 보고했다.
📌 핵심 요약
- BDH(Dragon Hatchling)는 희소하고 국소적인 뉴런 상호작용과 시냅스 유사 연결의 상태를 활용하는 뇌 영감 아키텍처로, 테스트 시 가중치 업데이트 없이 문맥에 따라 상태를 조정한다.
- 원문은 트랜스포머의 학습·추론 비용, 장기 상호작용에서의 망각, 고정 크기 문맥 창과 증가하는 KV-cache를 구조적 한계로 지적하며, BDH를 대안으로 제시한다.
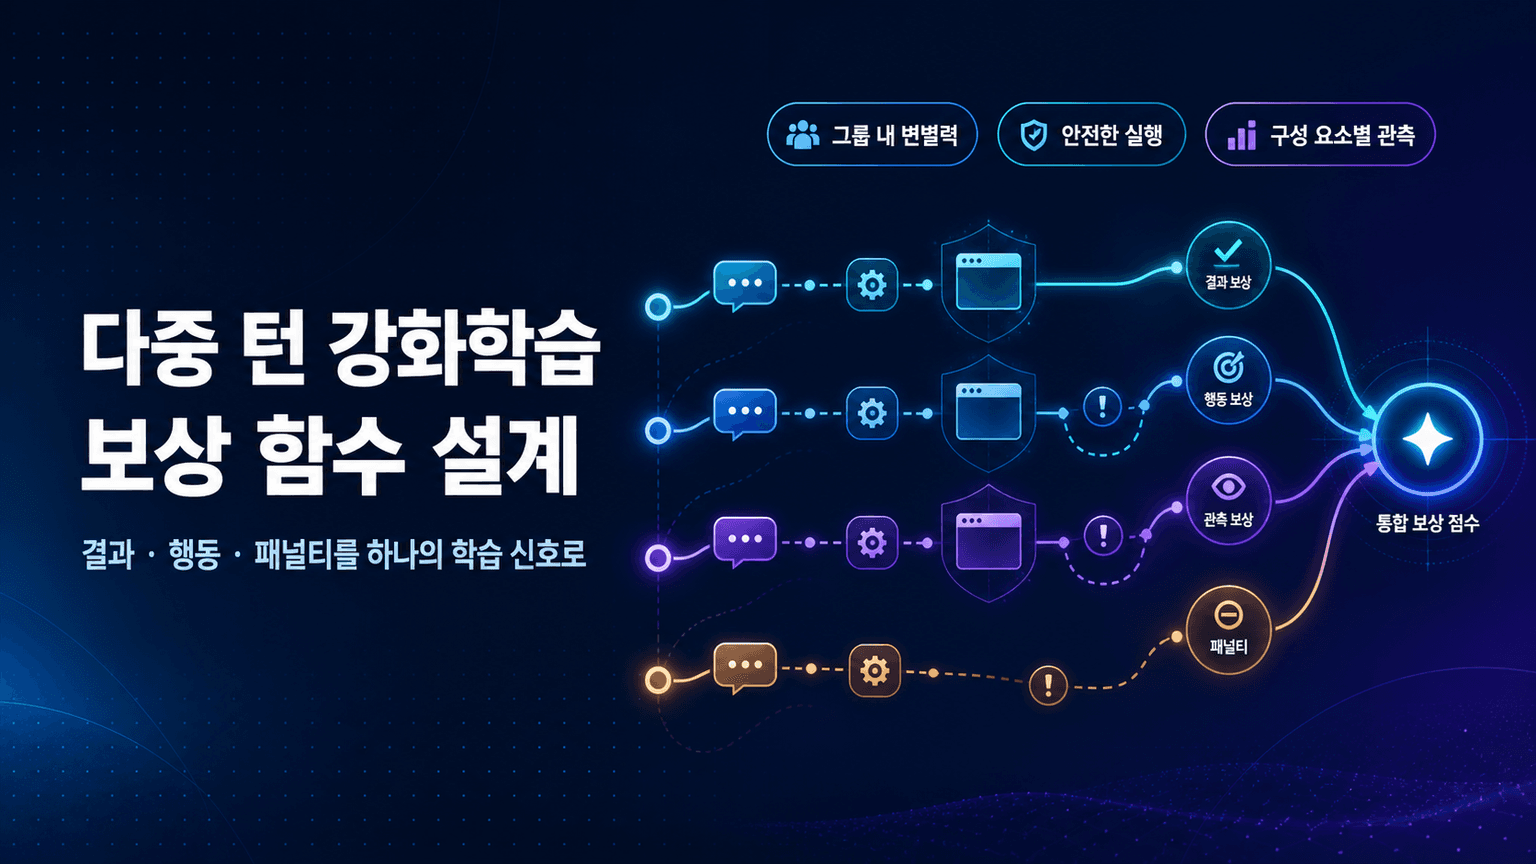
- BDH는 일반적으로 뉴런의 5%만 활성화하고 고정된 고차원 상태에서 선형 어텐션을 수행한다. BDH-CQ는 이를 확장해 시각 문제에서 문맥 내 학습과 잠재 상태의 반복 추론을 수행하며 후보 답만 디코딩한다.
- Pathway는 Amazon SageMaker HyperPod로 분산 학습을 확장하고, Amazon Managed Service for Prometheus와 Amazon Managed Grafana로 학습 인프라를 관찰했다. NVIDIA H200 GPU를 탑재한 p5en.48xlarge 인스턴스는 인스턴스당 최대 3200 Gbps 네트워크 성능을 제공하며 EFA와 Amazon EC2 UltraCluster로 연결됐다.
- Pathway는 1억 5천만 파라미터 BDH 기반 모델의 비용 효율성을 강조하며, BDH-CQ가 ARC-AGI-1에서 과제당 US $0.0007로 29.5% pass@2를 기록해 2026년 8월 기준 비용·정확도 파레토 경계를 바꿨다고 주장한다. 실제 응용의 비용·응답성·신뢰성 개선은 가능성으로 제시된다.
🧩 주요 포인트
- 잠재 상태에서 계산하고 후보 답만 출력 → 추론 단계마다 텍스트 토큰을 생성하는 방식의 비용과 지연을 줄이려는 설계 전환.
- 희소 활성화와 고정 크기 상태의 선형 어텐션 → 긴 입력과 반복 추론의 계산·메모리 부담을 낮추려는 구조이며, 장기 추론과 실제 응용의 효과는 제시된 벤치마크와 구분해 해석할 필요.
- Amazon SageMaker HyperPod의 분산 학습·관측 기능과 ARC-AGI-1 성과 → 새 아키텍처 개발을 뒷받침하는 인프라 사례와 비용 효율성 근거를 제시하지만, 비교 조건과 실제 운영 성과는 원문에서 구체화되지 않음.
🧠 상세 정리
1. 규모 확대에서 잠재 공간 추론으로의 전환
원문은 AI가 복잡한 과제를 맡게 되면서 업계가 모델 규모, 학습 데이터, 문맥 길이, 추론 시 계산량을 늘리는 방식으로 발전해 왔다고 설명한다. Pathway의 BDH(Dragon Hatchling)는 추론 과정을 연속적인 텍스트 토큰으로 생성해 다음 단계에 다시 입력하는 대신, 잠재 공간에서 예시를 학습하고 해법을 다듬는 접근을 제시한다. 이 아키텍처는 희소하고 국소적으로 소통하는 뉴런 그래프로 처음 정식화됐으며, 시냅스와 유사한 연결에 상태를 유지한다. 원문에 따르면 이 상태는 테스트 시 가중치 업데이트 없이 문맥에 맞춰 조정되며, 추론의 범위는 고정 크기 문맥 창이나 대량의 중간 추론 토큰에 묶이지 않는다.
2. 트랜스포머의 학습과 지식 갱신 한계
원문은 LLM이 코드 생성과 창작 등 다양한 작업을 바꿨지만, 일반 지능과 긴 시간에 걸친 일관된 추론 능력에는 여전히 근본적인 질문이 남아 있다고 본다. 학습 단계에서는 트랜스포머가 학습 데이터 밖으로 체계적으로 일반화하는 데 어려움을 겪고, 특히 긴 사고 과정이 필요한 과제에서 이를 보완하려고 많은 데이터와 계산을 요구한다고 주장한다. 또한 조밀한 계산과 전체 역전파 때문에 모델 크기에 따라 계산 비용이 지수적으로 증가한다고 서술하며, 개별 뉴런의 활성화가 최종 답변으로 이어지는 관계도 명확하지 않다고 지적한다. 지식 갱신 측면에서는 재학습이나 미세조정 없이 새로운 지식을 효율적으로 반영하기 어렵고, 새 내용을 배우면서 기존 내용을 잊는 파국적 망각이 발생할 수 있다는 점을 대안 아키텍처의 필요성과 연결한다.
3. 추론 비용과 문맥·해석 가능성의 제약
추론 단계에 대해 원문은 트랜스포머의 어텐션 구조가 확장성을 제한하고, Mixture of Experts 기법을 쓰더라도 조밀한 활성화가 과도한 계산과 메모리 대역폭 사용을 유발한다고 주장한다. 고정된 문맥 창과 계속 커지는 KV-cache는 처리 가능한 시퀀스 길이에 제약을 주며, 모델 내부 상태의 폐쇄성은 추론 과정을 해석하거나 감시하기 어렵게 만든다고 설명한다. 이러한 문제는 운영 환경과 규제가 강한 산업에서 신뢰성과 안전성에 관한 우려로 이어지며, 원문은 이를 구현 세부사항만으로 해결할 수 없는 설계 문제로 규정한다. Pathway의 CEO이자 공동창업자인 Zuzanna Stamirowska는 추론 단계마다 문맥·지연·계산 비용이 늘어나는 현상이 지능의 필연적 법칙이 아니라 아키텍처가 부과하는 비용이라고 강조하며, 1억 5천만 파라미터 BDH 모델의 비용 효율성을 그 근거로 제시한다.
4. BDH의 국소 그래프와 희소 활성화
BDH는 시퀀스 모델링을 서로 상호작용하는 뉴런 입자 네트워크의 국소 그래프 동역학으로 다시 구성하는 포스트 트랜스포머 아키텍처로 소개된다. 함께 활성화되는 뉴런의 연결이 강화된다는 헤비안 학습 원리를 어텐션에 적용하고, 단일 뉴런 차원 n을 따라 확장해 트랜스포머를 여러 계산 자원에 분산할 때의 복잡성을 줄인다고 설명한다. 뉴런 사이의 상호작용은 희소하고 국소적으로 정의되며, 연결이 기억과 추론 기능을 담고 일반적으로 전체 뉴런의 5%만 특정 시점에 활성화된다. 원문은 이처럼 활성 상태를 줄이면 추론 단계마다 필요한 계산량이 감소한다고 주장하며, 고정된 고차원 상태에서 작동하는 선형 어텐션이 긴 문맥 처리의 복잡성을 낮추고 뉴런 쌍 사이의 시냅스 연결에 대응하는 상태가 의사결정 해석을 돕는다고 설명한다.
5. BDH-CQ의 문맥 내 학습과 반복 추론
Pathway는 BDH 위에 시각 문제 해결을 위한 문맥 내 학습과 잠재 공간의 반복 추론을 추가한 BDH-CQ를 구축했다. BDH-CQ는 예시를 처리하는 동안 내부 기억을 갱신하고, 순환하는 잠재 상태 안에서 반복 계산을 수행한 뒤 후보 답만 디코딩하므로 긴 언어적 추론 기록을 생성하지 않고도 새로운 문제를 다룬다고 설명된다. 원문은 뉴런 집단이 서로 다른 후보 해법을 나타낼 수 있어 여러 가설을 효율적으로 병렬 탐색할 수 있으며, 고정된 메모리 비용으로 임의 개수의 시범 예시를 처리할 수 있다고 주장한다. 이러한 설명은 미세조정이나 재학습 없이 문제에 적응한다는 방향을 뒷받침하며, AWS의 Nicolas Tarducci는 HyperPod에서 이 시스템을 학습한 사례가 고성능 추론을 더 낮은 비용으로 대규모 배포하는 유망한 경로를 보여준다고 평가한다.
6. Amazon SageMaker HyperPod와 학습 관측
BDH는 PyTorch 같은 널리 쓰이는 프레임워크와 통합되며, Pathway는 Amazon SageMaker HyperPod를 사용해 학습을 확장하고 응용 AI 연구자들이 계산 자원을 공유하도록 했다. 원문은 HyperPod를 수백 또는 수천 개 GPU에 걸친 분산 학습·추론을 위한 인프라로 소개하면서, 자동 클러스터 프로비저닝, 최적화된 네트워크, 사용자 지정 소프트웨어 스택이 개발 부담을 낮춘다고 설명한다. 자동 확장에 따른 비용 효율성과 GPU 클러스터 전반의 거의 선형적인 확장을 지원하는 특화 네트워크도 이점으로 제시되지만, Pathway의 구체적인 학습 시간 단축률이나 비용 절감률은 제시되지 않는다. Pathway는 Amazon Managed Service for Prometheus와 Amazon Managed Grafana를 활용해 분산 학습 패턴, GPU 사용률, 메모리 양상, 노드 간 통신 효율을 관찰했으며, 원문은 이러한 관측 기능이 개발 반복 주기 단축과 비용 대비 성능 최적화, 실행 간 신뢰성·재현성 확보를 돕는다고 설명한다.
7. H200 GPU와 EFA 기반 분산 학습 구성
Pathway는 NVIDIA H200 GPU 기반 가속 AI 인프라와 인스턴스당 최대 3200 Gbps의 네트워크 성능을 제공하는 Amazon EC2 p5en.48xlarge 인스턴스를 사용했다. Amazon Elastic Fabric Adapter(EFA)는 GPU 계산을 위한 NVIDIA CUDA 플랫폼 및 GPU 간 통신을 위한 NVIDIA Collective Communications Library(NCCL)와 기본 통합돼 데이터, 가중치, 활성값 등을 신뢰성 있게 분산하도록 지원한다. 모든 인스턴스는 EFA로 상호 연결됐고 Amazon EC2 UltraCluster에서 운영돼 GPU 사이의 네트워크 거리를 줄이고 지연을 낮추도록 구성됐다. 이 구성은 새로운 아키텍처의 분산 학습을 뒷받침하는 구체적인 기반으로 제시되며, 앞서 설명한 관측 도구는 이러한 병렬 학습에서 GPU 자원 사용과 노드 간 통신 효율을 파악하는 역할을 한다.
8. ARC-AGI-1 성과와 실제 응용의 전망
원문은 BDH-CQ가 ARC-AGI-1에서 과제당 US $0.0007의 비용으로 29.5% pass@2를 달성해 2026년 8월 기준 비용·정확도 파레토 경계를 바꿨다고 보고한다. ARC-AGI-1은 알려지지 않은 시각 규칙을 보여주는 소수의 변환 전후 예시를 주고, 시스템이 그 규칙을 추론해 새로운 격자에 적용하도록 요구하며, BDH-CQ는 예시 처리 중 내부 기억을 갱신하고 잠재 상태에서 계산해 후보 답을 출력한다. 원문은 이런 문제 구조를 사이버 보안 사고 조사, 교통망 조정, 실시간 산업 운영, 장기간 실행되는 자율 에이전트 업무와 연결하면서 비용·응답성·신뢰성을 개선할 가능성을 제시하지만, 해당 응용에서의 실측 결과나 상세 비교 조건은 담지 않는다. 결론은 BDH가 척도 없는 생물학적 네트워크에서 영감을 받아 국소 상호작용, 희소 활동, 지속 상태, 지속적인 조정 원리를 GPU 친화적인 시퀀스 모델에 적용했다고 정리하며, 제공된 원문은 이후 문장이 완결되기 전에 끝난다.
🧾 핵심 주장 / 시사점
- 원문이 제시하는 핵심 전환은 추론 계산 자체를 없애는 것이 아니라, 그 계산을 중간 텍스트 생성에서 내부 잠재 상태의 반복 갱신으로 옮기는 데 있다.
- BDH의 아키텍처상 효율성과 HyperPod의 학습 인프라 효율성은 서로 다른 층위의 주장이다. 전자는 희소 활성화와 상태 처리 방식에, 후자는 자원 공유·통신·관측 기능에 근거한다.
- ARC-AGI-1의 비용·정확도 결과는 특정 시각 추론 과제의 근거이며, 원문이 제시한 장기 업무와 산업 응용의 개선 가능성을 직접 검증한 결과로 확대 해석하기는 어렵다.
✅ 액션 아이템
- BDH-CQ의 ARC-AGI-1 성과를 검토할 때 29.5% pass@2와 과제당 US $0.0007의 비교 조건 확인.
- 잠재 상태의 반복 추론이 긴 입력과 장기 추론에서 계산·메모리 부담을 줄이는 범위 검토.
- Amazon SageMaker HyperPod의 분산 학습·관측 기능이 실제 운영 성과에 미치는 효과 확인.
❓ 열린 질문
- BDH-CQ의 ARC-AGI-1 결과인 29.5% pass@2와 과제당 US $0.0007은 어떤 비교 조건에서 산출됐는가?
- 고정 크기 상태의 선형 어텐션과 잠재 상태의 반복 추론은 장기 추론에서 어느 범위까지 효과를 유지하는가?
- Amazon SageMaker HyperPod의 분산 학습·관측 기능이 제공한 비용 효율성은 실제 운영 성과로 얼마나 확인됐는가?