How to Use NVIDIA Warp and MjWarp to Accelerate Robotics Simulation and Learning Workflows
Quick Summary
NVIDIA Warp 기반 MJWarp는 호환 MuJoCo 장면을 GPU의 다수 환경으로 확장해 총 처리량을 높이며, 원문은 SO 101의 CPU 기준 동작부터 최대 2,048개 병렬 환경으로 이전하기 위한 개념과 준비 절차를 설명한다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
NVIDIA Warp 기반 MJWarp는 호환 MuJoCo 장면을 GPU의 다수 환경으로 확장해 총 처리량을 높이며, 원문은 SO-101의 CPU 기준 동작부터 최대 2,048개 병렬 환경으로 이전하기 위한 개념과 준비 절차를 설명한다.
📌 핵심 요약
- MuJoCo CPU는 단일 로봇 MPC·원격 조작에 적합하고, MJWarp는 수백~수천 개 독립 환경을 함께 진행해 강화학습과 대규모 샘플링의 총 처리량을 높이는 데 초점을 둔다. 단일 환경의 지연시간 단축을 보장하는 것은 아니다.
- NVIDIA Warp는 정적 타입의 Python 커널을 CPU 또는 CUDA 실행 코드로 컴파일한다. CUDA 배열의 .numpy() 호출은 동기화와 CPU 복사를 수반하며, GPU에 데이터를 유지하는 PyTorch·JAX 연계에는 프레임워크 어댑터나 DLPack 호환 공유를 사용한다.
- MJWarp 이전에서는 mjw.put_model()로 모델을 GPU에 배치하고, mjw.put_data()로 초기화된 MuJoCo 상태를 보존·배치화한다. nworld, 접촉 용량 nconmax·naconmax, 환경별 제약 상한 njmax를 정하고 CUDA Graphs 재실행으로 반복 실행 요청의 오버헤드를 줄인다.
- Warp의 자동미분과 Warp 1.15에서 도입된 선택적 결정론적 실행은 전체 MJWarp 롤아웃의 미분 가능성이나 결정론을 보장하지 않는다. 결정론적 실행은 재현 가능한 연산 순서를 위해 일부 성능을 교환한다.
- SO-101 예제는 빨간 44 mm 큐브를 파란 큐브 위에 쌓는 장면에서 50 Hz 제어와 제어 프레임당 10회 물리 스텝으로 CPU 기준 동작을 준비한다. 글은 최대 2,048개 병렬 환경으로의 확장을 예고하지만, 제공된 본문은 CPU 예제 직후에 끊겨 이후 검증·성능 결과는 확인할 수 없으며 정책 학습도 범위에 포함하지 않는다.
🧩 주요 포인트
- 단일 환경 지연시간과 총 처리량은 다른 지표 → MuJoCo CPU와 MJWarp의 선택은 제어 응답 속도와 대규모 경험 수집 중 어느 쪽이 중요한지에 달려 있다.
- 초기 상태 보존·GPU 데이터 유지·접촉 및 제약 용량 설정 → MJWarp 이전은 API 교체와 함께 상태의 연속성과 배치 실행 자원까지 다뤄야 한다.
- SO-101 CPU 기준 동작과 Warp 기능의 보장 범위 구분 → 최대 2,048개 환경에서의 실제 성능·정확도·재현성은 제공된 본문만으로 입증되지 않는다.
🧠 상세 정리
1. 단일 장면의 속도에서 병렬 환경의 총 처리량으로
기존 MuJoCo는 로봇 개발·시험·제어를 위한 빠른 CPU 시뮬레이션을 제공하며, CPU 코어 사이에서 샘플링을 병렬화할 수도 있다. 그러나 학습 작업이 커지면 한 환경이 얼마나 빨리 움직이는지보다 동시에 몇 개의 환경을 진행할 수 있는지가 중요한 문제가 된다. NVIDIA Warp 기반 MJWarp는 호환 MuJoCo 모델과 여러 독립 상태를 NVIDIA GPU에 배치해 이 요구에 대응하며, 시뮬레이션과 학습 데이터를 장치 가까이에 유지할 수 있게 한다. 원문은 SO-101 follower arm을 익숙한 MuJoCo 작업 흐름에서 최대 2,048개 병렬 환경으로 옮기는 과정을 다루겠다고 소개한다. 다만 이 글의 범위는 시뮬레이션 환경의 준비와 확장이며 정책을 학습하지는 않고, 다음 통합 계층은 후속 Newton과 Isaac Lab 글에서 다룬다고 명시한다.
2. 작업 목적에 따른 도구와 계층 선택
원문은 NVIDIA Warp를 병렬 커널 작성과 자동미분, PyTorch·JAX 연계를 담당하는 기반 계층으로, MJWarp를 그 위에서 MuJoCo 물리를 실행하는 계층으로 구분한다. 로봇과 작업 장면은 익숙한 Menagerie 또는 Robot Studio 자산과 작업용 형상으로 구성하며, Newton과 Isaac Lab은 다중 솔버 API, USD, 센서, 관리자와 학습 루프 등 다음 통합 계층으로 소개된다. 선택 기준으로는 단일 로봇 MPC나 원격 조작에 MuJoCo CPU를, MuJoCo 물리의 최대 처리량이 필요할 때 MJWarp 또는 mjlab을 제시한다. JAX 학습 구성에는 MuJoCo Playground와 MJX의 impl='warp' 경로를, 다중 솔버와 Isaac Lab 통합에는 Newton을 연결한다. 따라서 이 도구들은 하나의 속도 순위로 비교되기보다, 필요한 제어 방식과 학습 프레임워크 및 통합 범위에 따라 선택하는 구성 요소로 설명된다.
3. Python 커널을 GPU 실행으로 연결하는 Warp
NVIDIA Warp는 정적 타입을 사용하는 Python 커널을 작성하고 이를 CPU 또는 CUDA용 실행 코드로 컴파일하는 프레임워크다. 첫 실행 요청에서는 네이티브 모듈을 빌드해 캐시에 저장하고, 이후에는 이를 재사용하며, 일반 Python 코드는 설정·메모리 할당·실행 조율을 맡는다. 예제 커널은 각 논리 스레드가 점 하나를 담당하도록 wp.tid()를 사용하고, 중력 가속도 -9.81을 속도에 반영한 뒤 갱신된 속도로 위치를 진행한다. 같은 작업 구조를 유지하면서 처리할 점의 수를 두 개에서 수백만 개로 확장할 수 있다는 점이 병렬 작성 방식의 핵심이다. 원문은 JIT 컴파일·커널 융합·CUDA Graphs를 통한 성능, 벡터·행렬·쿼터니언 등 내장 자료형과 자료구조를 통한 작성 편의성, 미분 가능한 커널과 ML 프레임워크 연계를 Warp의 세 가지 가치로 제시한다.
4. 데이터 이동과 자동미분·결정론의 경계
Warp 배열은 선택한 장치에 존재하며, CUDA 배열에서 .numpy()를 호출하면 동기화와 CPU 메모리 복사가 발생하므로 무복사 접근으로 이해하면 안 된다. PyTorch나 JAX와 데이터를 GPU에 유지한 채 연결하려면 프레임워크 어댑터 또는 DLPack 호환 공유를 사용하고, 지원되는 CUDA 작업은 그래프로 캡처해 기존 버퍼를 대상으로 반복 실행할 수 있다. 이 그래프 재실행은 반복 실행 요청의 오버헤드를 줄이는 기능이며, 임의의 커널들을 자동으로 융합하는 기능은 아니다. 자동미분에서는 wp.Tape가 문맥 안의 순방향 커널 실행을 기록하고 backward() 호출 시 수반 연산을 역순으로 실행한다. Warp 1.15에서 도입된 선택적 결정론 모드는 기본 GPU 원자 연산의 스케줄러 의존성을 다루기 위해 일부 성능을 재현 가능한 연산 순서와 교환한다. 원문은 이 두 기능을 SO-101 예제에서 사용하지 않으며, Warp의 기능이 전체 MJWarp 롤아웃에 대한 미분 가능성이나 결정론의 보장은 아니라고 선을 긋는다.
5. MJWarp의 배치 실행과 상태 이전 API
원문에서 world는 장면과 그 상태의 독립적인 사본을 뜻하며, 같은 SO-101 로봇이라도 서로 다른 초기 자세를 가진 별개의 환경이 될 수 있다. MJWarp는 MuJoCo 물리 파이프라인을 NVIDIA Warp로 구현해 GPU에 모델과 독립 상태 묶음을 배치하고, mjw.step(m, d) 한 번으로 전체 묶음을 진행한다. 핵심 이점은 반드시 단일 환경의 스텝이 빨라진다는 데 있지 않고, 수백~수천 개 환경을 함께 진행해 측정 시간당 완료하는 전체 환경 스텝 수를 높이는 데 있다. API 이전에서는 mujoco.MjModel을 mjw.put_model()로 장치 모델로 옮기고, 초기화된 mujoco.MjData는 mjw.put_data()로 보존하면서 배치화한다. 기본 상태나 새 상태가 필요할 때는 mjw.make_data()를 사용하며, 제어 배열도 호스트의 mjd.ctrl에서 형태가 (nworld, nu)인 장치 배열 d.ctrl로 바뀐다. 따라서 한 스텝의 실제 경과 시간인 지연시간과 전체 환경 스텝 수를 기준으로 하는 총 처리량을 구분해야 강화학습·대규모 샘플링에 대한 효과를 올바르게 해석할 수 있다.
6. 접촉·제약 용량과 반복 실행 최적화
배치 자원을 할당할 때 nworld는 병렬 환경 수이며, nconmax는 개별 환경의 예상 접촉 수로 전체 접촉 용량은 대략 nconmax와 nworld의 곱에 해당한다. 대안인 naconmax는 모든 환경을 합친 전역 최대 접촉 수이고 두 값이 함께 정의되면 우선 적용되며, njmax는 환경별 제약 수의 엄격한 상한이다. 이 용량에 따라 메모리와 작업량이 달라지므로 원문은 mjwarp-testspeed의 --measure_alloc과 mjwarp-viewer의 오버플로 관찰을 활용해 적정 크기를 찾도록 제안한다. mjw.step은 여러 커널 실행으로 구성되므로 CUDA 그래프를 한 번 캡처한 뒤 반복 실행하고, 용량을 조정한 다음 작업 동작을 바꾸지 않는 범위에서 솔버 반복 횟수 제한을 시험하는 순서를 설명한다. 메시와 CCD 설정도 메모리를 늘릴 수 있으며 측정된 접촉 수가 허용하면 nccdmax·naccdmax로 CCD 버퍼 할당을 줄일 수 있다고 덧붙인다. 또한 MJWarp의 compact solver가 사용하는 MuJoCo Newton 제약 솔버와 sleeping은 별도 Newton 물리 엔진 프레임워크와 구별되며, compact solver와 다중 GPU 설정은 이 실습의 범위 밖이다.
7. SO-101의 큐브 쌓기 장면 구성
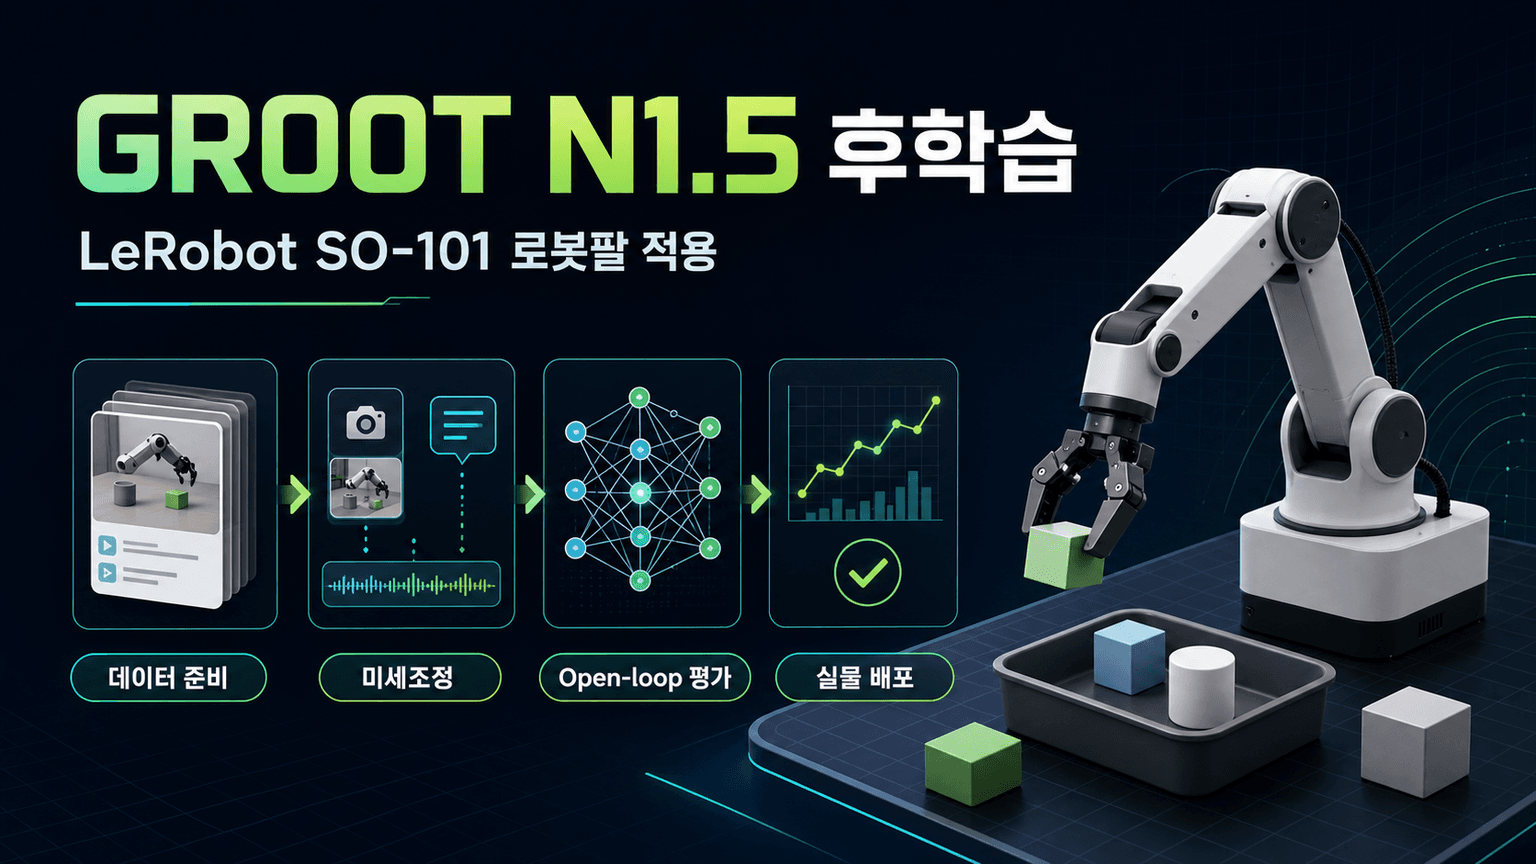
CPU 기준 장면은 SO-101 로봇 팔과 테이블, 쌓기 작업에 사용할 두 큐브로 이루어지며, 아직 MJWarp 전용 요소가 없는 일반 MJCF로 작성된다. 목표는 빨간 큐브를 집어 파란 큐브 위에 쌓는 것으로, MJCF 상자에서 size는 반쪽 길이를 뜻하므로 0.022로 지정된 각 축은 실제 모서리 길이 44 mm에 해당한다. 원문은 작업 성공 판정의 임계값에도 이 크기를 사용한다고 설명하고, 팔의 밑부분은 원점에 있으며 도달 방향은 +X, 큐브 배열 방향은 Y라고 명시한다. 코드에는 각 큐브의 질량이 0.08로 지정되어 있고, 테이블 및 큐브의 마찰과 접촉 차원도 장면에 포함되어 있다. 동반 저장소에서는 이 파일을 수작업으로 쓰는 대신 resolve_pick_place_scene()이 Menagerie 로봇 팔을 .generated/에 복사하고 로봇 프로필의 테이블·큐브 좌표를 채워 scene_pick_place.xml을 생성한다. 본문이 사용하는 프로필은 SO-101이며 선택 가능한 reBot 변형도 언급하지만, 제공된 부분에는 그 후속 설명이 포함되어 있지 않다.
8. CPU 기준 실행과 제공된 자료의 범위
장면 로딩은 mujoco.MjModel.from_xml_path()와 mujoco.MjData()를 사용하는 일반 MuJoCo 방식이며, 제어 주파수는 50 Hz, 제어 프레임당 물리 스텝 수는 10으로 설정된다. 코드는 frame_dt를 1.0 / fps로 계산하고 물리 시간 간격을 frame_dt / sim_substeps로 지정해 제어 갱신과 물리 적분의 주기를 구분한다. PickPlaceController는 경유점과 감쇠 최소제곱 역기구학을 사용하며, 600개 제어 프레임 각각에서 제어값을 한 번 계산한 다음 내부 반복문에서 그 값을 적용하며 물리를 10회 진행한다. 이 구조는 GPU로 이전하기 전에 동일한 로봇과 작업 장면이 CPU에서 어떻게 실행되는지 기준을 잡는 단계다. 원문은 한 MuJoCo 환경 검증, MJWarp 이전과 배치 구성, 검증 및 올바른 측정을 예고하지만 제공된 본문은 이 CPU 코드 직후 문장 중간에서 끝난다. 따라서 최대 2,048개 환경에 대한 실제 실행 결과, CPU와 GPU의 상태 비교, 구체적인 처리량 수치는 이 자료에서 확인된 성과로 서술할 수 없다.
🧾 핵심 주장 / 시사점
- MJWarp의 효과는 단일 환경의 속도보다 전체 경험 수집량에 초점을 맞출 때 명확해진다. 지연시간과 총 처리량을 구분하지 않으면 도구 선택과 성능 해석이 어긋날 수 있다.
- GPU 이전의 핵심은 모델을 옮기는 것에 그치지 않는다. 초기 상태를 보존하고 데이터 이동을 줄이며 접촉·제약 용량을 맞추는 작업이 배치 실행의 정확성과 효율을 함께 좌우한다.
- 기반 프레임워크의 자동미분·결정론 지원과 전체 시뮬레이션의 보장 범위는 구별해야 한다. 제공된 자료의 절단 지점까지 고려하면, 확장 목표를 검증된 성능 결과로 해석할 근거는 부족하다.
✅ 액션 아이템
- 단일 환경 지연시간과 총 처리량 중 우선 지표를 정하고 MuJoCo CPU 또는 MJWarp의 적합성을 판단.
- MJWarp 이전 시 mjw.put_data()의 초기 상태 보존, GPU 데이터 유지, nconmax·naconmax·njmax 설정을 검토.
- SO-101의 50 Hz 제어와 제어 프레임당 10회 물리 스텝을 CPU 기준으로 삼고, 최대 2,048개 환경의 검증·성능 결과는 제공된 본문에서 확인되지 않은 사항으로 구분.
❓ 열린 질문
- 대상 작업에서 MuJoCo CPU와 MJWarp를 선택할 때 단일 환경 지연시간과 총 처리량 중 어느 지표가 더 중요한가?
- MJWarp에서 nconmax·naconmax·njmax는 접촉·제약 용량 요구를 충족하면서 자원 사용을 줄이도록 어떻게 정할 수 있는가?
- SO-101을 최대 2,048개 환경으로 확장했을 때 CPU 기준 동작 대비 정확도와 총 처리량은 어떠하며, 이를 확인할 후속 검증·성능 결과가 있는가?