Amazon SageMaker Inference: 2026 year-to-date launches in review
Quick Summary
Amazon SageMaker AI는 2026년 현재까지 관리형 엔드포인트와 HyperPod Inference에 총 13개 기능을 출시했으며, 제공된 본문은 배포 최적화·용량 확보·API 호환·확장·관측·비동기 호출·캐시 재사용을 개선하는 엔드포인트 기능 7개를 상세히 설명한다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
Amazon SageMaker AI는 2026년 현재까지 관리형 엔드포인트와 HyperPod Inference에 총 13개 기능을 출시했으며, 제공된 본문은 배포 최적화·용량 확보·API 호환·확장·관측·비동기 호출·캐시 재사용을 개선하는 엔드포인트 기능 7개를 상세히 설명한다.
📌 핵심 요약
- Amazon SageMaker AI는 토큰 대신 인스턴스 단위로 모델을 이용하는 두 경로를 제공한다. 관리형 엔드포인트는 AWS가 인프라와 운영을 담당하고, HyperPod Inference는 전용 GPU 클러스터에 대한 Kubernetes 기반 제어를 제공한다.
- 추론 추천은 모델과 비용·지연·처리량 목표를 바탕으로 구성 후보를 좁히고 최적화·벤치마크를 수행한다. GPT-OSS-20B 시연에서는 같은 요청 지연에서 초당 토큰 처리량이 2배가 됐으며, 용량 인식 인스턴스 풀은 최대 5개 인스턴스 유형을 우선순위에 따라 대체 사용한다.
- OpenAI 호환 API는 스트리밍 Chat Completions와 최대 12시간 유효한 bearer token 인증을 지원하며 14개 AWS 리전에서 제공된다. 비동기 추론은 최대 128,000바이트의 입력을 요청에 직접 넣어 Amazon S3 사전 업로드를 생략할 수 있고, 31개 AWS 리전에서 제공된다.
- 컨테이너 캐싱은 Qwen3-8B를 ml.g6.2xlarge에서 실행한 사례에서 전체 시작 지연을 525초에서 258초로 51% 줄였다. 관측 기능은 OpenTelemetry 기반 상세 지표 100개 이상과 CloudWatch Insights 대시보드를 제공하며, 새 엔드포인트에서는 기본 활성화된다.
- Prefix-aware routing은 공통 프롬프트 접두사가 있는 요청을 같은 인스턴스로 보내 KV 캐시 재사용을 높인다. Llama 3.1 70B의 7개 인스턴스 벤치마크에서 8,000토큰 접두사 사용 시 P90 TTFT가 33~37% 줄고 캐시 적중률이 약 25%에서 82%로 상승했으며, 요청당 라우팅 오버헤드는 1.3~1.9밀리초였다.
🧩 주요 포인트
- 관리형 엔드포인트와 HyperPod Inference의 제어 범위 차이 → 운영 부담 최소화와 Kubernetes 기반 인프라 제어 중 워크로드에 맞는 배포 경로를 선택하는 것이 출발점이다.
- 추론 추천의 하드웨어별 최적화와 최대 5개 유형의 용량 인식 인스턴스 풀 → 성능·비용 목표와 GPU 용량 부족 대응을 함께 설계할 수 있다.
- 컨테이너 캐싱·Prefix-aware routing·상세 관측 지표 → 신규 인스턴스 시작 지연, 반복 프롬프트 계산, 운영 중 병목을 서로 다른 단계에서 줄이거나 파악할 수 있으며, 제시된 개선 수치는 해당 벤치마크 조건의 결과다.
🧠 상세 정리
1. 생성형 AI 추론의 난점과 두 배포 경로
원문은 수십~수백 GB에 이르는 모델, 토큰 단위 성능 요구, 수분이 걸릴 수 있는 콜드 스타트, 제한된 GPU 용량, 기존 모니터링의 토큰 수준 신호 부족을 생성형 AI 추론의 난점으로 제시한다. Amazon SageMaker AI는 모델을 토큰 대신 인스턴스 단위로 이용하도록 하며, 관리형 엔드포인트와 Amazon SageMaker HyperPod Inference라는 두 배포 경로를 제공한다. 엔드포인트는 AWS가 인프라를 완전 관리하고 컨테이너·모델 계층의 사용자 설정을 지원하는 반면, HyperPod는 관리형 Kubernetes 스택에서 노드 접근과 프레임워크·AMI 수준의 더 넓은 제어를 제공한다. 확장은 각각 CloudWatch 기반 관리형 자동 확장과 Karpenter·KEDA·CloudWatch를 활용하며, HyperPod는 Kubernetes 기반 학습부터 서빙까지의 다중 클라우드·하이브리드 배포에 적합한 경로로 소개된다. 원문은 2026년 현재까지 총 13개 기능을 출시했다고 설명하고, HyperPod 항목으로 Simplified Operator, Tiered KV Cache, Data Capture, Performance Features, Disaggregated Prefill and Decode, Model Caching을 나열한다. 다만 제공된 본문은 엔드포인트 기능 7개를 상세히 다루며, 마지막 라우팅 설명 도중에 잘려 있어 HyperPod 기능의 상세 내용은 확인할 수 없다.
2. 추론 추천과 벤치마크 자동화
2026년 4월 출시된 추론 추천은 인스턴스 유형, 서빙 컨테이너, 최적화 설정을 고르는 데 통상 1,000개 이상의 조합과 2~3주의 수동 벤치마크가 필요하다는 문제를 다룬다. 고객이 모델과 비용·지연·처리량 목표를 지정하면 SageMaker는 모델 구조·크기·메모리 요구로 후보를 좁히고, 처리량을 위한 EAGLE 3.0 추측 디코딩, 지연을 위한 커널 조정, 모델 크기에 따른 텐서 병렬화 등을 적용한다. 이어 실제 GPU 인프라에서 NVIDIA AIPerf로 여러 차례 측정하고 통계적 신뢰도를 보고한다. 결과는 배포 가능한 설정과 TTFT, ITL, P50·P90·P99 지연, 처리량, 예상 비용이 담긴 SageMaker Model Package로 제공된다. GPT-OSS-20B 시연에서는 같은 요청 지연에서 초당 토큰 처리량이 2배가 됐지만, 이는 제시된 최적화 사례의 결과다. 추천 생성에는 추가 비용이 없고, ML Reservations 고객은 예약 용량에서 추가 비용 없이 벤치마크할 수 있으며 다른 인스턴스 유형을 평가하는 데도 활용할 수 있다.
3. 용량 인식 인스턴스 풀로 대체 하드웨어 활용
2026년 5월 출시된 용량 인식 인스턴스 풀은 단일 인스턴스 유형의 용량 부족 때문에 엔드포인트가 요청을 처리하기도 전에 생성에 실패하던 문제를 해결하도록 설계됐다. 고객은 최대 5개 인스턴스 유형을 우선순위 목록으로 지정하며, SageMaker는 엔드포인트 생성 시 첫 번째 유형의 용량이 없으면 다음 유형으로 즉시 대체한다. 확장 시에는 목록에서 사용 가능한 다음 유형이 수요를 수용하고, 축소 시에는 대체 인스턴스를 먼저 제거해 선호 하드웨어 중심으로 구성이 돌아가도록 한다. 인스턴스 유형별 CloudWatch 지표 차원은 이기종 구성에 대한 가중치 기반 확장 정책을 지원한다. 각 유형에는 고메모리 인스턴스의 텐서 병렬화, 중간급의 추측 디코딩, 더 작은 대체 인스턴스의 양자화처럼 별도 최적화 구성을 연결할 수 있고, 추론 추천으로 이러한 하드웨어별 구성을 자동 생성할 수도 있다. 이 기능은 모든 상용 AWS 리전에서 단일 모델, inference component, 비동기 엔드포인트를 지원한다.
4. OpenAI 호환 API로 애플리케이션 연결 간소화
2026년 5월 출시된 OpenAI 호환 API는 OpenAI SDK, LangChain, Strands Agents 기반 애플리케이션을 SageMaker 호스팅 모델에 연결할 때 필요했던 사용자 정의 클라이언트 어댑터와 인증 재작성 부담을 다룬다. 엔드포인트는 스트리밍 Chat Completions를 지원하는 /openai/v1 경로를 제공하며, 원문은 엔드포인트 URL 변경만으로 이전할 수 있고 SDK 호출·스트리밍 로직·프롬프트 형식은 동일하게 유지된다고 설명한다. 인증에는 기존 AWS 자격 증명으로 생성하는 최대 12시간 유효한 bearer token을 사용해 SigV4 서명 복잡성을 줄인다. 다중 모델 엔드포인트에서는 모델별로 자원을 독립 할당하면서 같은 OpenAI SDK로 각각 호출할 수 있고, 에이전트도 기존 호환 인터페이스를 통해 고객 소유 GPU 인프라에서 실행할 수 있다. 제공 범위는 14개 AWS 리전이며, vLLM·SGLang AWS Deep Learning Containers와 /v1/chat/completions 경로를 구현한 사용자 정의 컨테이너를 지원한다.
5. 컨테이너 캐싱으로 확장 시 시작 지연 단축
2026년 6월 출시된 컨테이너 캐싱은 트래픽 급증으로 추가되는 인스턴스가 Amazon ECR에서 전체 컨테이너 이미지를 내려받느라 대기하던 시간을 줄인다. 10GB를 넘는 대형 서빙 컨테이너에서는 이미지 다운로드만으로 수분이 걸릴 수 있었지만, 지원되는 가속기 인스턴스에서는 이미지를 자동으로 미리 받아 별도 설정이나 코드·컨테이너 수정 없이 로컬에서 사용한다. Qwen3-8B를 ml.g6.2xlarge에서 압축 크기 17.7GB인 LMI 컨테이너로 실행한 사례에서는 전체 시작 지연이 525초에서 258초로 51% 감소했다. 이미지와 모델이 네트워크 대역폭을 두고 경쟁하지 않게 되면서 모델 다운로드도 168초에서 77초로 줄었고, 사전 이용 고객이 관찰한 개선 폭은 38~65%였다. 원문은 이를 확장 최적화의 세 번째 계층으로 설명하며, 앞선 계층에는 표준 1분 지표보다 확장 감지를 6배 빠르게 하는 1분 미만 CloudWatch 지표와 이미 실행 중인 인스턴스의 이미지·모델 다운로드를 제거하는 인스턴스 스토어 데이터 캐싱을 배치한다.
6. 토큰·GPU·가용성을 연결하는 추론 관측
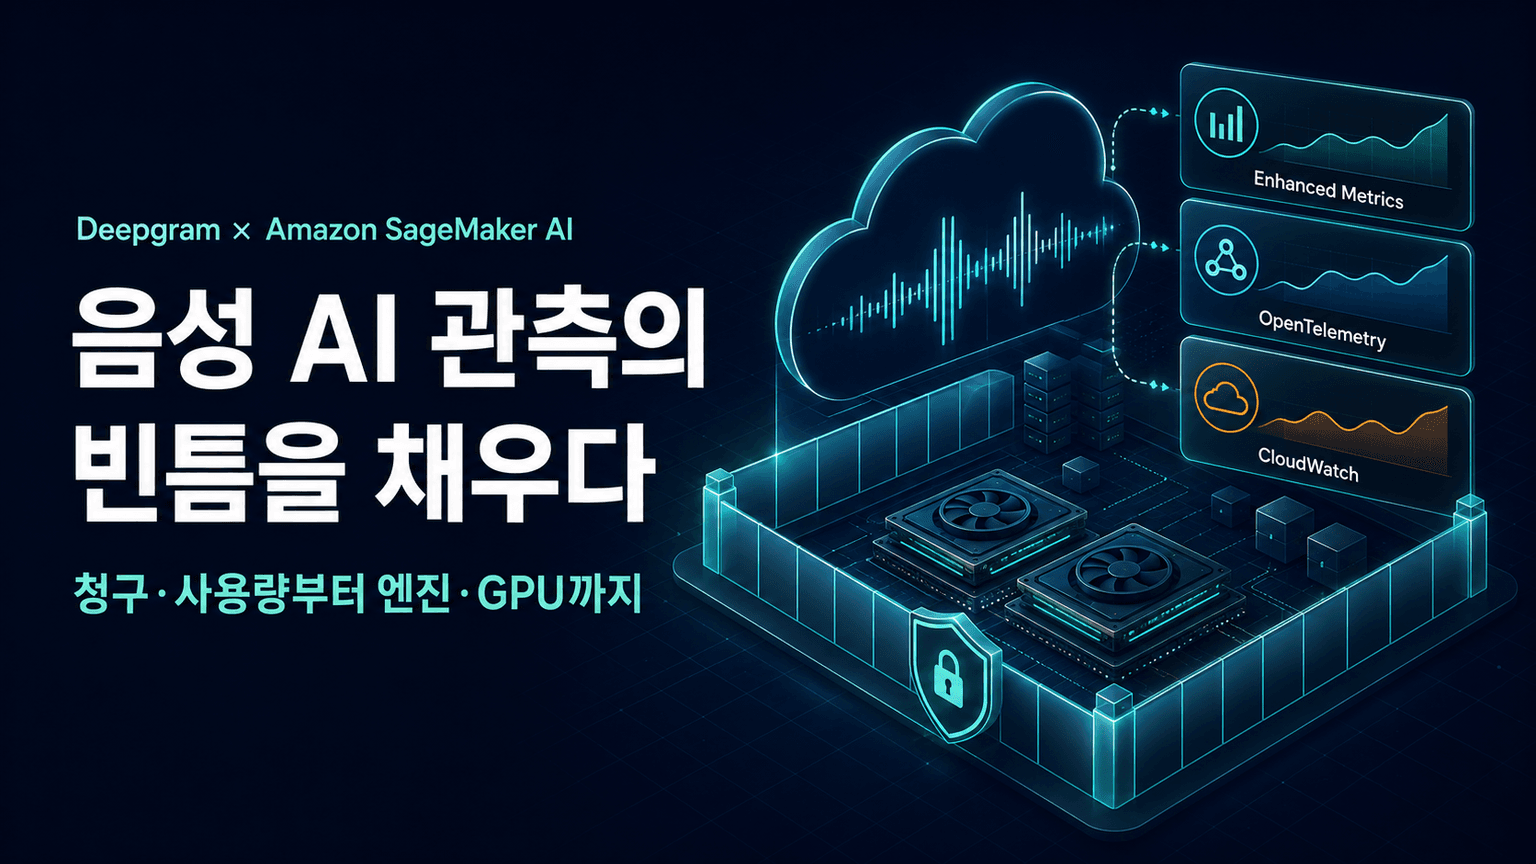
2026년 6월 출시된 관측 기능은 토큰 수준 지연, KV 캐시 압박, GPU 메모리 추세, 가용 영역별 inference component 배치 정보를 흩어진 지표에서 수동으로 연관 지어야 했던 문제를 다룬다. SageMaker는 네이티브 OpenTelemetry로 상세 추론 지표 100개 이상을 내보내고, 별도 계측 없이 사용할 수 있는 Amazon CloudWatch의 사전 구성 Insights 대시보드를 함께 제공한다. 새 엔드포인트에서는 기본 활성화되며 InService 상태에 도달한 뒤 2분 이내에 지표가 전달된다. 성능 영역에서는 TTFT·ITL·처리량, 모델 지연과 시스템 오버헤드, KV 캐시 사용률과 대기열 깊이를 보여주고, 용량 영역에서는 GPU 사용률·메모리·온도·디스크와 인스턴스 상태를 보여주는 벌집형 시각화를 제공한다. 신뢰성 영역은 가용 영역 분포와 위험 점수, 모델 다운로드·GPU 로드·컨테이너 시작으로 나눈 콜드 스타트, 확장 이력을 다룬다. 또한 SigV4 인증을 사용하는 PromQL 호환 엔드포인트를 통해 Amazon Managed Grafana나 다른 PromQL 호환 도구에서 지표를 직접 조회할 수 있다.
7. 비동기 추론 입력의 직접 전달
기존 비동기 추론은 수백 바이트의 간단한 JSON 프롬프트도 엔드포인트 호출 전에 Amazon S3에 업로드해야 했기 때문에 요청마다 구조적 복잡성과 지연이 추가됐다. 2026년 6월 출시된 인라인 입력 지원으로 InvokeEndpointAsync API의 Body 매개변수에 최대 128,000바이트의 페이로드를 직접 담을 수 있게 됐다. 원문은 이 방식이 대다수 비동기 워크로드에서 S3 사전 업로드 단계를 제거하며, 요청당 네트워크 왕복을 한 번 줄인다고 설명한다. 직접 입력을 사용하는 경우 입력 버킷을 마련하거나 IAM의 s3:PutObject 권한을 부여할 필요가 없고, 크기와 매개변수를 즉시 검증하며 호출당 S3 PUT 요금도 피할 수 있다. 기존 InputLocation 기반 워크플로는 그대로 유지되는 완전한 하위 호환성을 제공하고, 기능은 31개 AWS 리전에서 사용할 수 있다.
8. 공통 접두사 라우팅으로 KV 캐시 재사용
Prefix-aware routing은 시스템 지침, 검색 문서, 대화 이력처럼 요청마다 반복되는 프롬프트 앞부분을 지문으로 삼아 비슷한 요청을 같은 인스턴스로 보내고, KV 캐시 재사용을 높여 반복 계산을 줄인다. 과부하 방지와 확장 이벤트 중 안정적 동작을 위한 보호 장치를 포함하며, Llama 3.1 70B를 7개 인스턴스에서 실행한 벤치마크의 8,000토큰 접두사 조건에서는 P90 TTFT가 33~37%, P50 TTFT가 71~77% 감소하고 KV 캐시 적중률이 약 25%에서 82%로 상승했다. 짧은 문맥에서도 P90 TTFT가 24~37% 줄었고, 요청당 추가 라우팅 비용은 1.3~1.9밀리초였다. SageMaker의 라우팅 선택지는 기본값 RANDOM, LEAST_OUTSTANDING_REQUESTS, 새 PREFIX_AWARE이며, 원문은 RAG, 다중 턴 대화, 템플릿 봇, 코드 완성을 적합한 활용 사례로 제시한다. 활성화에는 엔드포인트 설정의 RoutingStrategy, PrefixLength, ConcurrencyThreshold 지정만 필요하고 모델 컨테이너나 서빙 프레임워크 수정은 필요하지 않다. 제공된 본문에서는 다중 테넌트 접두사 격리와 inference component 지원까지 확인되지만, 그 뒤 문장이 잘려 추가 지원 범위는 확정할 수 없다.
🧾 핵심 주장 / 시사점
- 원문의 개선 방향은 모델 실행 자체뿐 아니라 구성 선택, 용량 확보, 인스턴스 시작, 요청 배분, 문제 진단까지 추론 운영의 여러 병목을 나누어 다루는 데 있다.
- 추론 추천과 용량 인식 인스턴스 풀을 함께 활용하면 대체 하드웨어를 확보하는 것과 각 하드웨어에 맞는 모델 구성을 준비하는 것을 연결할 수 있다.
- 컨테이너 캐싱은 확장 시 준비 시간을, Prefix-aware routing은 반복 프롬프트 계산을 줄인다. 두 기능의 개선율은 측정 대상과 조건이 다르므로 동일한 성능 지표로 합산할 근거는 없다.
✅ 액션 아이템
- 관리형 엔드포인트와 HyperPod Inference를 운영 부담 및 Kubernetes 기반 인프라 제어 필요성에 따라 비교 검토.
- 추론 추천과 최대 5개 유형의 용량 인식 인스턴스 풀을 연계해 성능·비용 목표와 GPU 용량 부족 대응을 함께 평가.
- 컨테이너 캐싱과 Prefix-aware routing의 적용 효과를 신규 인스턴스 시작 지연 및 반복 프롬프트 특성에 따라 검증하고, 상세 관측 지표로 병목 확인.
❓ 열린 질문
- 대상 워크로드에는 관리형 엔드포인트의 운영 부담 최소화와 HyperPod Inference의 Kubernetes 기반 인프라 제어 중 어느 쪽이 더 중요한가?
- 추론 추천의 성능·비용 목표를 고려할 때 최대 5개 유형의 용량 인식 인스턴스 풀 우선순위는 어떻게 정해야 하는가?
- 실제 워크로드의 공통 프롬프트 접두사 특성에서도 Prefix-aware routing이 TTFT와 KV 캐시 적중률을 얼마나 개선하는가?