Accelerating vision-language models with LFM2.5-VL-DSpark
Quick Summary
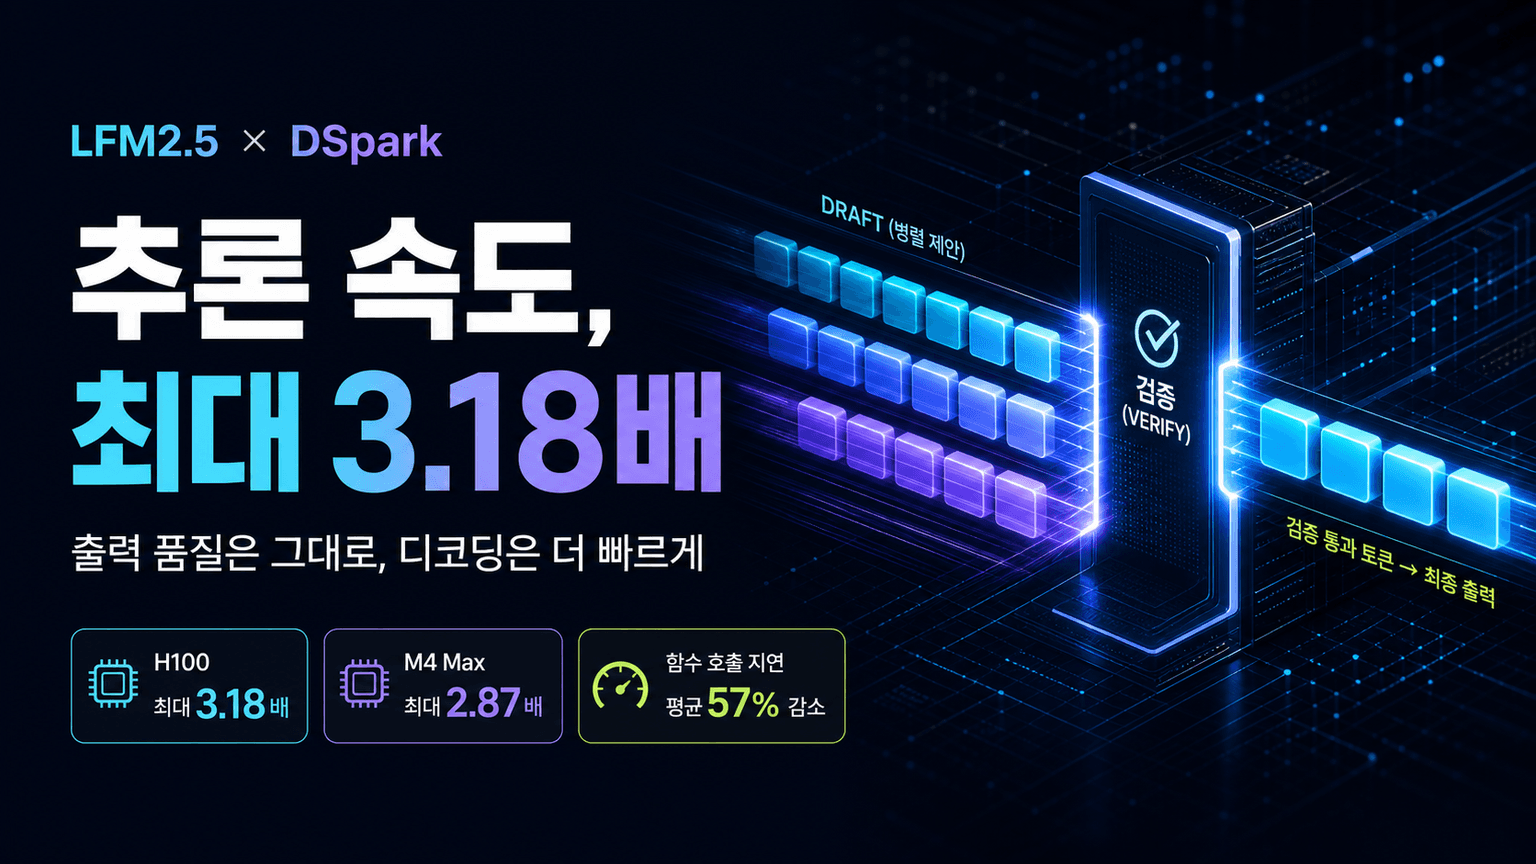
Liquid AI는 LFM2.5 VL 3B에 약 280M 파라미터를 추가해 출력 품질을 유지하면서 온디바이스 디코딩을 최대 3.13배, H100 디코딩을 최대 2.66배 가속한다고 발표한 실험적 초안 모델 LFM2.5 VL DSpark를 공개했다.

🖼️ 인포그래픽

🖼️ 4컷 인포그래픽

💡 한 줄 요약
Liquid AI는 LFM2.5-VL-3B에 약 280M 파라미터를 추가해 출력 품질을 유지하면서 온디바이스 디코딩을 최대 3.13배, H100 디코딩을 최대 2.66배 가속한다고 발표한 실험적 초안 모델 LFM2.5-VL-DSpark를 공개했다.
📌 핵심 요약
- 2026년 9월 24일 공개된 LFM2.5-VL-DSpark는 추측 디코딩용 초안 모델로, 약 280M 파라미터를 추가해 배포 모델의 파라미터 수를 8.9% 늘린다. 타깃이 제안된 모든 토큰을 검증하며, 탐욕적 디코딩 출력은 타깃 단독 실행과 동일하다고 설명한다.
- 초안 모델은 타깃의 지정된 계층에서 추출한 은닉 상태를 활용하는 4계층 어텐션 전용 구조다. 학습 블록 크기는 9이며 최종 데이터 혼합으로 10에포크 학습했고, 추론에서는 하드웨어에 따라 블록 크기 8 또는 9를 권장한다.
- MMSpec의 6개 시각 과제를 블록 크기 8로 평가한 결과, M5 Max의 MLX는 디코딩 2.30~3.13배·전체 처리 1.56~2.62배, M3 Ultra의 llama.cpp는 디코딩 1.57~2.14배·전체 처리 1.30~1.77배 개선을 보고했다.
- H100의 전체 처리 개선은 1.64~2.27배이며, 도입부의 디코딩 최대 가속은 2.66배다. 다만 본문 디코딩 범위는 '20.4x to 2.66x'로 표기되어 수치가 불일치한다. 추측 디코딩은 비전 인코딩과 프리필을 가속하지 않아 전체 성능 개선에 한계가 있다.
- llama.cpp, MLX-VLM, SGLang용 통합을 공개 당일부터 제공하지만 각각 DSpark를 지원하는 빌드가 필요하다. 모델은 Hugging Face에서 Safetensors와 GGUF 형식으로 제공된다.
🧩 주요 포인트
- 공유 표현으로 변환된 이미지·텍스트의 은닉 상태를 활용 → 텍스트용 DSpark와 같은 추론 알고리즘을 VLM에도 적용하고, 타깃 검증으로 출력의 정확성을 유지한다.
- 파라미터 8.9% 증가와 하드웨어별 가속 폭의 차이 → 메모리 부담과 디코딩 개선을 함께 평가하되, 비전 인코딩·프리필 비중을 반영해 전체 처리 이득을 판단해야 한다.
- llama.cpp·MLX-VLM·SGLang 통합 및 블록 크기 8 또는 9 권장 → 지원 빌드와 하드웨어별 설정이 적용 조건이며, H100의 상충하는 디코딩 수치는 확인이 필요하다.
🧠 상세 정리
1. 실험적 VLM 초안 모델 공개
Liquid AI는 2026년 9월 24일 비전 언어 모델 LFM2.5-VL-3B를 위한 실험적 DSpark 초안 모델을 공개했다. 앞서 발표한 텍스트용 LFM2.5-DSpark처럼 추측 디코딩 경로를 추가해, 작은 메모리 부담 증가로 출력 품질을 바꾸지 않고 추론을 가속한다는 설명이다. 초안 모델은 약 280M 파라미터를 더하며, 배포 모델의 파라미터 수 증가율은 8.9%다. 도입부는 온디바이스와 H100에서 디코딩이 각각 최대 3.13배와 2.66배, 전체 처리가 최대 2.62배와 2.27배 개선된다고 제시한다. 이는 디코딩 단계의 가속과 실제 전체 처리 이득을 구분해 보고한 결과다.
2. 이미지와 텍스트에 공통으로 적용되는 추측 디코딩
비전용 초안 모델은 텍스트용 LFM2.5-DSpark와 같은 구조를 사용하며, 타깃 모델의 미리 지정된 여러 계층에서 은닉 상태를 추출한다. 이 상태를 조건으로 삼아 k개의 후보 토큰으로 이루어진 블록을 생성하고, 타깃 모델이 제안된 모든 토큰을 검증한다. 이미지 패치와 텍스트 토큰은 해당 계층에 도달하기 전에 공유 표현으로 투영되므로, 초안 모델이 처리하는 은닉 상태 벡터의 차원은 입력 모달리티와 관계없이 같다. 따라서 비전 입력이 추가되어도 추론 알고리즘 자체는 텍스트 모델에서 바뀌지 않는다. 원문은 추측 디코딩이 정확성을 보존하며, 특히 탐욕적 디코딩 출력은 타깃 모델만 실행했을 때와 동일하다고 명시한다.
3. 학습 구성과 4계층 구조 선택
학습에는 DSpark 방식을 따르면서 예상 사용 과제에 가중치를 둔 비전 언어 지도 미세조정 데이터 혼합을 사용했다. 3·4·5계층을 비교하는 절제 실험을 거쳐 단순화된 4계층 어텐션 전용 초안 모델과 블록 크기 9를 선택했다. 최종 데이터 혼합으로 10에포크를 학습하고 매 에포크 수용률을 측정했으며, 학습 토큰이 늘면서 수용률이 개선되다가 추가 개선 폭이 줄었다고 설명한다. 구성별 파라미터는 디코더 스택 193.0M, 은닉 상태 투영 21.0M, Markov 헤드 65.5M, 정규화와 신뢰도 헤드 6.4k로, 총계는 약 279.5M이다. 추론 시에는 하드웨어에 따라 블록 크기 8 또는 9를 권장한다.
4. 온디바이스·H100 평가 결과와 수치 불일치
평가는 MMSpec을 따라 일반 VQA, 텍스트 VQA, 이미지 캡셔닝, 차트 VQA, 복합 추론, 다중 턴 대화의 6개 과제를 사용했으며, 온디바이스와 GPU 모두 DSpark 블록 크기 8을 적용했다. M5 Max에서 MLX를 사용하면 과제별 디코딩이 2.30~3.13배 빨라지고 전체 처리는 1.56~2.62배 개선됐다. M3 Ultra의 llama.cpp에서는 디코딩 1.57~2.14배, 전체 처리 1.30~1.77배의 개선을 보고했다. H100의 전체 처리 개선은 1.64~2.27배지만, 본문은 디코딩 범위를 '20.4x to 2.66x'로 적었다. 이 표기는 도입부의 최대 2.66배와 일관되지 않으므로, 정확한 범위를 임의로 고쳐 해석할 수 없다.
5. 비전 인코딩과 프리필이 제한하는 전체 가속
원문은 LLM의 프리필이 주로 연산량에 제약을 받고, 프롬프트 길이에 따라 비용이 제곱 또는 그보다 낮은 차수로 증가한다고 설명한다. VLM은 여기에 비전 인코더의 이미지 처리와 언어 백본의 수백 개 시각 토큰 처리가 추가된다. 엣지 장치는 데이터센터 GPU보다 연산 자원이 적어 프리필이 전체 지연에서 차지하는 비중이 커지며, M5의 GPU 코어별 신경망 가속기는 이 격차를 줄인다고 덧붙인다. 추측 디코딩은 디코딩만 가속하고 비전 인코딩이나 프리필에는 영향을 주지 않는다. 따라서 이들 단계가 이미 실행 시간의 큰 부분을 차지한다면 디코딩이 크게 빨라져도 전체 이득은 제한되며, 원문은 이를 가속되지 않는 부분이 전체 속도 향상의 상한을 정하는 암달의 법칙으로 설명한다.
6. 지원 빌드와 배포 경로
SGLang은 LFM2 타깃의 DSpark 지원 빌드인 PR #40651이 필요하며, 예시는 LFM2.5-VL-3B에 LFM2.5-VL-3B-DSpark를 연결하고 블록 크기 9로 서버를 실행한다. llama.cpp와 MLX-VLM도 각각 PR #29339와 PR #2280에 해당하는 빌드가 필요하다. 다만 llama.cpp 실행 예시의 초안 파일은 LFM2.5-2.6B-DSpark-F16.gguf로 기재되어, 글에서 소개한 비전용 초안 모델 이름과 차이가 있다. 원문은 블록 크기를 초안의 config.json 또는 사이드카 메타데이터에서 읽고, 응답별 timings의 draft_n과 draft_n_accepted로 제안·수용 토큰 수를 보고한다고 설명한다. 모델은 Hugging Face에서 Safetensors와 GGUF로 제공되며, Liquid AI는 제한 없이 다운로드·미세조정·배포할 수 있는 공개 가중치와 기본·오디오·비전 모델을 아우르는 제품군을 강조한다.
🧾 핵심 주장 / 시사점
- 이미지와 텍스트가 동일한 차원의 은닉 상태로 표현된다는 점이 텍스트용 DSpark 추론 알고리즘을 VLM에도 적용할 수 있는 핵심 근거다.
- 디코딩 가속만으로 실제 응답 시간 개선을 판단하기 어렵다. 비전 인코딩과 프리필이 차지하는 비중에 따라 동일한 초안 모델의 전체 처리 이득이 달라진다.
- H100의 디코딩 범위와 llama.cpp 예시의 초안 파일명에는 원문 내부의 불일치가 있어, 성능 수치 해석과 실행 예시 적용 시 확인할 부분이 남는다.
✅ 액션 아이템
- LFM2.5-VL-DSpark 적용 시 파라미터 8.9% 증가와 하드웨어별 전체 처리 개선을 함께 평가.
- llama.cpp·MLX-VLM·SGLang의 DSpark 지원 빌드와 하드웨어에 맞는 블록 크기 8 또는 9를 확인.
- H100 디코딩의 '20.4x to 2.66x' 표기와 최대 2.66배 주장 간 불일치를 확인.
❓ 열린 질문
- H100 디코딩 범위의 '20.4x to 2.66x'와 최대 2.66배 중 정확한 성능 범위는 무엇인가?
- 하드웨어별로 블록 크기 8 또는 9를 선택하는 구체적인 기준은 무엇인가?
- 비전 인코딩과 프리필이 전체 지연에서 차지하는 비중에 따라 LFM2.5-VL-DSpark의 전체 처리 이득은 얼마나 달라지는가?